Wiki Foundations3 Concepts and Frameworks of AI
3.2 循环神经网络
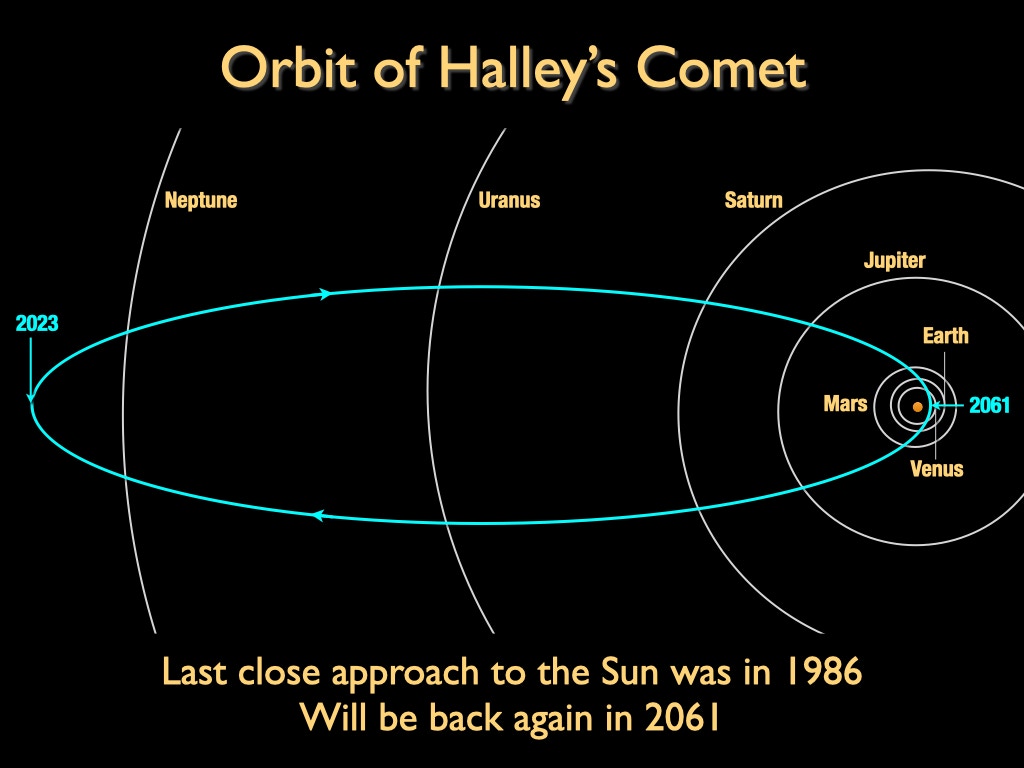
17世纪末,彗星仍被视作不可预测的、偶然划过天际的幽灵。天文学家埃德蒙·哈雷决定挑战这一认知。他没有依赖单次观测或个体直觉,而是系统性地搜集、整理了数百年来的彗星观测记录——一个跨越时空的时间序列数据集。在分析这些数据时,哈雷发现1531年、1607年和1682年三次彗星的轨道参数惊人地相似。他提出了一个大胆的假设:这不是三颗独立的彗星,而是同一颗天体按规律的回归。他计算出其周期约为76年,并以此做出了一个伟大的预测:它将在1758年再次出现。
从天体周期到统计思想:序列建模的缘起#
1758年,彗星如期而至,完美验证了哈雷的预测。在一个由确定性规律(如万有引力)主导的系统中,只要我们能从数据中准确地归纳出这个规律,就能做出精准的长期预测。然而,当我们从星空回归人间,却几乎不可能找到这样简单、永恒的“上帝公式”。
从金融市场的涨跌、商品价格的波动到日常语言的流转,这些现实世界的序列状态由无数微小、动态、甚至不可观测的因素共同决定,充满了不确定性。但人类对预测未来渴望似乎与生俱来,时间序列分析作为统计学中的一个特殊领域,正是为了解决这类问题而生。它关注如何分析按时间顺序排列的数据点,通常基于数据的平稳性(Stationarity) 等假设条件下,进行统计建模与推断。
在20世纪,时间序列领域主要由两条思想路径主导。一条是以Box-Jenkins方法论为核心的ARMA模型,它擅长为相对平稳的序列建模,在经济学界影响深远。另一条则是以卡尔曼滤波器为代表的状态空间模型,它在需要动态追踪与控制的信号处理领域,取得了里程碑式的成功。
尽管这两大学派的理论侧重与应用场景各异,但它们共同的思想中,有两个与我们的主题高度相关,并最终成为了现代RNN的基石:
1. 时间不变性(Time Invariance)
在统计学中,这一思想通常对应着平稳性假设,即数据的统计特性(如均值、方差)不随时间推移而改变。从更深层的思想层面解读,平稳性意味着驱动数据生成的底层“规律”是恒定的。
这与我们在卷积神经网络(CNN)中看到的平移对称性形成了深刻的呼应:两者都假设存在一种通用的模式或规则,可以应用于数据在不同时间(或空间)位置上的片段。这一通用性原则,正是神经网络中参数共享的根本动机。
2. 马尔可夫假设(Markov Assumption)
马尔可夫假设中,一阶假设最为简洁和影响深远。它的准确表述是:一个时刻的状态,只取决于前一个时刻的状态,而不直接与更早的历史相关。
当我们以做出有效预测为目标时,它的内涵发生了变化——遵循马尔可夫假设的同时要保持对未来强大的预测能力,那么模型对“当前状态”的认知就必须足够丰富。
因此,我们可以从另一个角度来理解马尔可夫假设——它要求模型学会将漫长历史的关键信息有效地“吸收”进对当前状态的表征之中。
这两个思想——规律在时间上的不变性,以及未来仅依赖于一个不断更新的当前状态——共同催生了一种优雅而强大的动态演化框架——循环神经网络(Recurrent Neural Network,RNN)。
其核心结构可以用一个抽象的函数形式来表达:
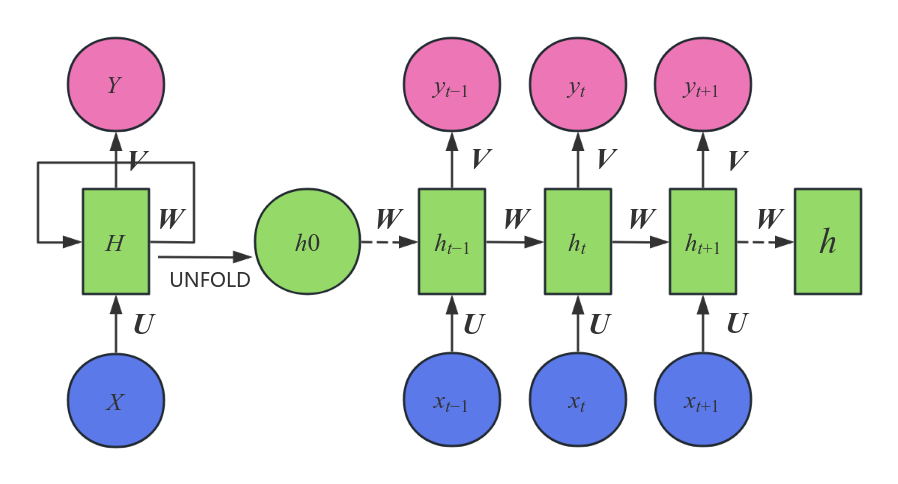
这个公式概括了RNN的运作机制:网络在下一刻的新状态 h_t(也称为隐状态,Hidden State),是由网络上一刻的旧状态 h_{t-1} 和在当前时刻接收到的外部新输入 x_t 共同决定的;随后,当前时刻的输出 y_t 则由这个新状态 h_t 生成。
需要强调的是,与CNN引入了卷积、池化这类特殊的神经网络操作不同,早期RNN的特殊之处并不在于引入了新的操作类型——其核心计算单元 f(\cdot) 内部仍然是我们熟悉的线性层与激活函数的组合,或是乘法与加法。
RNN的真正创新在于它的循环结构:将同一套计算单元在时间维度上重复使用,从而建立起当前与过去之间的联系。
循环神经网络:记忆的挑战与门控的革新#
循环神经网络的核心思想是通过一个在时间步之间循环传递的隐状态向量来维持对历史信息的记忆。
在每个时间步 t,网络会执行两步操作:首先,接收当前输入 x_t 和上一时刻的隐状态 h_{t-1},通过共享的变换生成新的隐状态 h_t;然后,基于这个新的隐状态生成当前步的输出 y_t。
在其最初的、最简洁的设计中,具体的计算过程是:
这个结构中,权重矩阵 W, U, V 和偏置项 b_h, b_y 在所有时间步中保持不变(时间不变性),而 h_t 仅直接依赖于 h_{t-1}(马尔可夫假设)。理论上,它能处理任意长度的序列,并捕捉复杂的动态模式。
然而,这种看似优雅的循环结构在训练时面临着一个致命的“阿喀琉斯之踵”,使其难以学习序列中的长期依赖关系。
其训练算法——通过时间的反向传播(Backpropagation Through Time,BPTT),要求将损失函数的梯度信号,沿着展开的时间步链式地回传。根据链式法则,这个过程不可避免地涉及与同一个权重矩阵 W 的反复连乘。
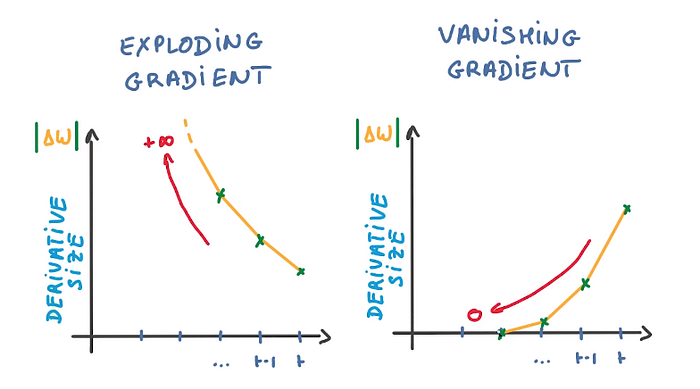
这就导致了严重的数值不稳定问题:若矩阵 W 的谱半径(即其最大特征值的绝对值)小于1,梯度信号在回传过程中会呈指数级衰减,最终趋近于零,是为梯度消失;反之,若其大于1,梯度则会呈指数级增长,导致数值溢出,是为梯度爆炸。
梯度消失使得模型无法从遥远的历史中获得有效的学习信号,而梯度爆炸则会直接让训练过程崩溃。因此,朴素RNN天然地存在“短期记忆”的倾向,难以胜任真正需要长期记忆的任务。
为了攻克这一难题,让神经网络拥有可靠的长期记忆能力,长短期记忆网络(Long Short-Term Memory, LSTM) 被设计了出来。
LSTM的革命性创新在于,它没有试图去“修复”那个单一的隐状态,而是引入了一个独立的细胞状态(Cell State),作为一条专用的信息“传送带”。同时,它还设计了一套精密的门控机制(Gating Mechanism),像熟练的工程师一样,主动、精细地管理这条信息流。
接下来,我们一步步拆解LSTM单元内部的信息流动过程,看它是如何通过协同工作的“阀门”来实现长期记忆的。
LSTM的五步记忆管理过程#
1. 第一步:接收输入
在进行任何计算之前,一个LSTM单元会首先接收三个关键的信息源:上一时刻的短期记忆(即隐状态 h_{t-1})、当前时刻的外部输入(x_t),以及上一时刻的长期记忆(被称为细胞状态 C_{t-1})。
接下来的所有门控计算,都将围绕这三组信息展开,以决定如何更新记忆并产生输出。
值得说明的是,虽然LSTM引入了“细胞状态”这个新概念,但其本质仍是RNN隐状态的一部分。我们可以将LSTM看作是将原本单一的隐状态分化为“长期记忆”(细胞状态)和“短期记忆”(隐状态)两个部分进行协同管理的精巧设计,这完全符合RNN的通用定义。
2. 第二步:遗忘门(Forget Gate)——决定丢弃什么
LSTM首先需要判断,从上一时刻继承下来的长期记忆 C_{t-1} 中,有哪些信息已经过时,需要被丢弃。
它通过一个被称为“遗忘门”的Sigmoid层来实现,该层接收短期记忆 h_{t-1} 和外部输入 x_t,并为 C_{t-1} 中的每个数字输出一个0到1之间的值。1 代表“完全保留”,而 0 代表“完全遗忘”。
3. 第三步:输入门(Input Gate)——决定存入什么
接下来,网络需要决定哪些新的信息要被存入长期的细胞状态中。
这个过程分两步:首先,“输入门”通过一个Sigmoid层(同样接收 h_{t-1} 和 x_t)决定需要更新哪些值;然后,一个tanh层会根据同样的输入创建一个候选的新记忆向量。
4. 第四步:更新细胞状态——执行记忆更新
现在,LSTM准备好对细胞状态进行更新。
它将旧的长期记忆 C_{t-1} 与遗忘门的输出相乘,丢弃掉决定遗忘的信息。然后,将输入门的输出与候选的新记忆向量相乘,筛选出需要存入的新信息。
最后,将这两个结果相加,生成全新的细胞状态 C_t。这个以加法为核心的更新步骤至关重要,它构建了一条梯度的“高速公路”,让梯度在反向传播时可以更顺畅地流动,从而极大地缓解了梯度消失问题。
5. 第五步:输出门(Output Gate)——决定输出什么
最后,网络需要根据更新后的长期记忆 C_t 来决定当前时刻的输出 h_t(它既是本步的最终输出,也将作为下一时间步的短期记忆)。
“输出门”通过一个Sigmoid层来决定细胞状态中的哪些部分将被输出,然后将细胞状态通过一个tanh层进行处理,并将两者相乘,得到最终的输出 h_t。
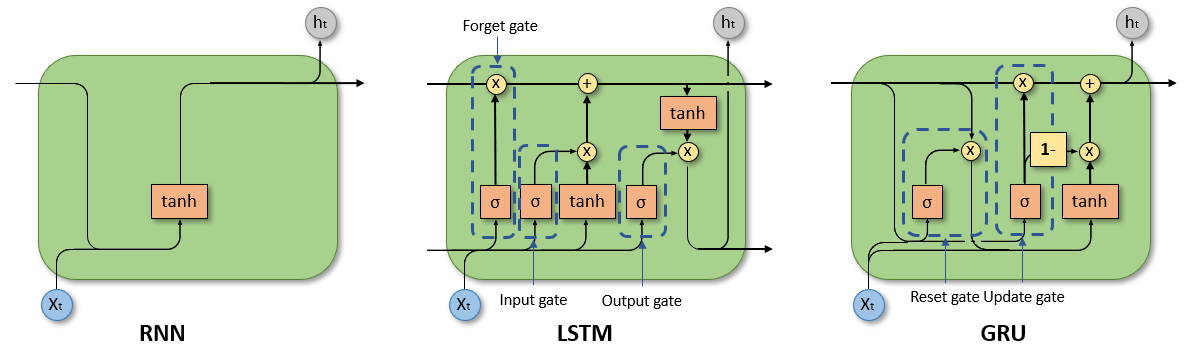
值得一提的是,上述 Sigmoid 与 tanh 的组合是LSTM最经典的设计,但并非一成不变。后续的研究也探索了使用 ReLU 等其他激活函数来替代的可能性,以期优化模型的动态特性。比具体激活函数的选择更核心的,是LSTM所开创的“门控”这一架构思想本身。
在LSTM大获成功后,研究者们发现其内部结构可以被简化,门控循环单元(Gated Recurrent Unit, GRU) 便是其中最流行的一种变体。
GRU将LSTM的遗忘门和输入门合并为了一个“更新门”,并将细胞状态与隐状态合二为一。这使得GRU的参数更少,计算效率更高,但在许多任务上能保持与LSTM相近的性能,因此也成为了一个非常受欢迎的选择。
至此,通过引入精巧的门控机制,研究者将一个信息易丢失的被动更新结构,改进为了能够选择性维持长期信息的主动管理结构,使得神经网络模型首次真正具备了处理长序列的可靠能力。
下一步的挑战,自然也从单元的设计转向了架构层面:如何将这些强大的单元组合起来,构建成能够处理更复杂任务的端到端模型?
超越循环:Seq2Seq架构与注意力机制的崛起#
事实上,在2014年之前,LSTM还未真正在自然语言处理领域火起来。因为LSTM模型的输入与输出序列在结构上是紧密耦合的,其工作方式就像是同声传译,听到一个词就得马上翻译一个词而且要求输入和输出的节奏(长度)差不多。
对于完成像智能问答这类输入与输出序列长度往往不同的复杂任务,研究者们需要一种新的架构范式。
带来转机的是一个名为Seq2Seq(Sequence-to-Sequence, 2014)的模型。如下图,它并未修改LSTM/GRU单元的内部结构,而是设计了一套两段式工作流程,编码器(Encoder)与解码器(Decoder)将“读取”和“生成”的过程进行解耦:
1. Encoder(编码器)
它就像是全神贯注的阅读者,负责完整地阅读整个输入序列,并将其“压缩”进一个固定长度的向量中,也被称为上下文向量(Context Vector,如 [0.13, -0.54, 0.88, \ldots])。
这个向量包含了序列中的所有信息——无论是语义、语法还是情感色彩。
2. Decoder(解码器)
就像是依据概要的创作者,它将编码器生成的上下文向量作为自己的“创作大纲”(即初始隐状态),然后逐个生成输出序列的词元(任意长度),直至完成整个创作。
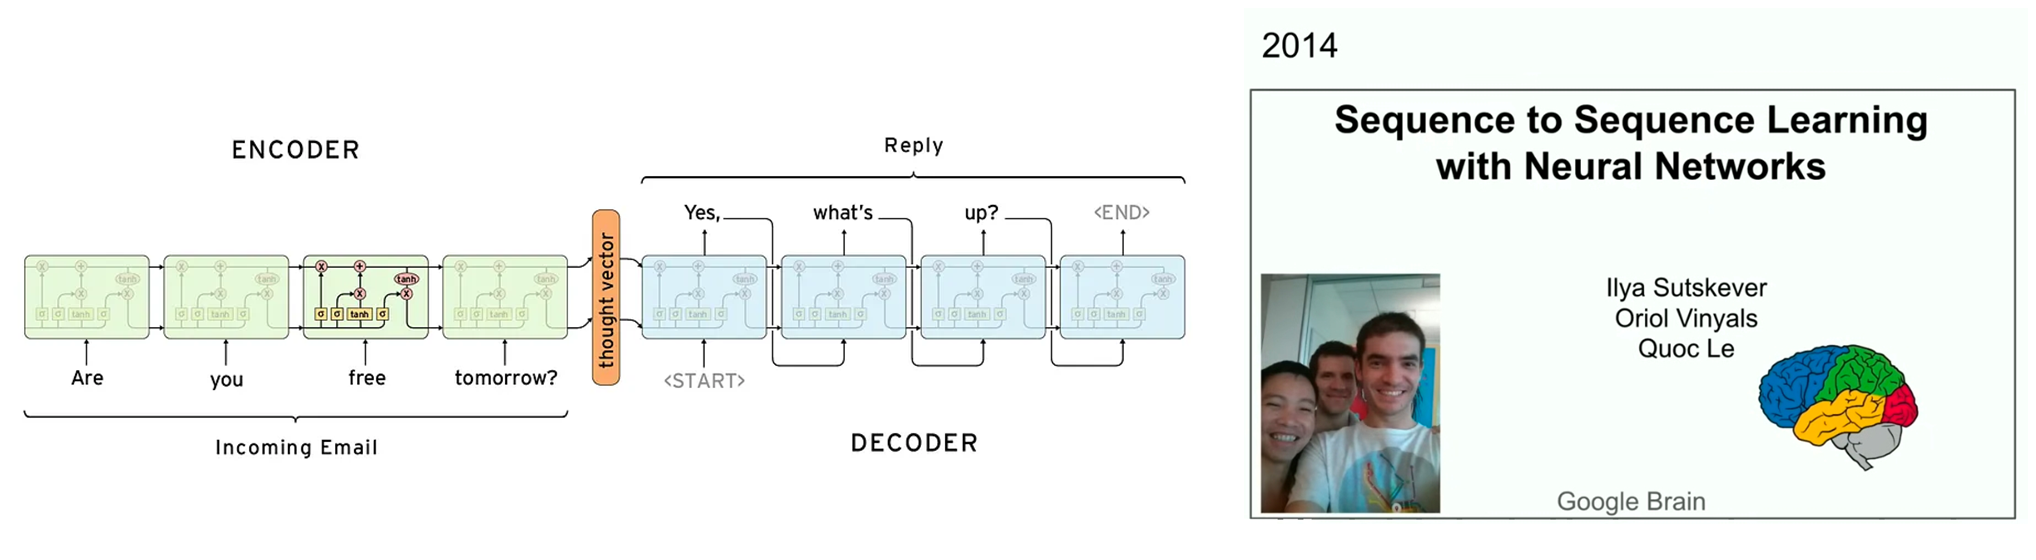
Seq2Seq这种“先编码,后解码”的架构取得了显著成功。值得一提的是,它的主要提出者正是Ilya Sutskever——后来OpenAI的联合创始人及首席科学家,GPT系列开发的核心主导者。
这段历史的有趣之处在于,Seq2Seq为后来的语言模型奠定了基础,但ChatGPT最终的形态却恰恰需要抛弃Seq2Seq的核心设计。这背后是什么原因呢?
答案是,当面对过长的输入序列时,这个架构存在一个与生俱来的“致命”缺陷——信息瓶颈(Information Bottleneck)。
可以直观理解为:它要求编码器把一本上千页的古籍内容,全部浓缩进一张巴掌大的小纸条里,然后递给解码器,让它从中了解整本古籍。但这张小纸条(上下文向量)的容量终究是有限的,大量重要的细节必然会丢失。所以无论编码器多么高明,其输出的质量和准确性仍会受到极大限制。
于是研究者们开始反思,强制所有信息通过单一隐状态进行传递似乎太过苛刻。
与其让解码器完全依赖这个被高度压缩的上下文向量,不如赋予它一种能力,使其在生成每一个输出单元时,可以“回顾”并直接从输入序列的各个部分中提取最相关的信息。
而这一想法则催生出了下一代序列模型的核心组件——注意力机制(Attention Mechanism)。
RNN中的注意力#
具体而言,其工作流程可以分解为以下几个步骤:
-
形成查询: 在解码的每一步,解码器根据其当前隐状态,生成一个“查询”或“线索”,代表了它此刻最需要什么样的信息。
-
计算分数: 模型将这个“查询”与输入序列的每一个位置的信息进行比较,为每个位置计算出一个“相关性分数”。
-
权重归一化: 这些分数经过归一化处理(通常使用Softmax函数),转化为一组权重,即“注意力权重”。这组权重清晰地表明了在当前步骤中,输入序列的各个部分所应占的“关注度”。
-
加权求和: 最后,模型根据这些注意力权重,对输入序列的各部分信息进行加权求和,生成一个为当前步骤动态定制的上下文向量,并用于指导最终的输出。
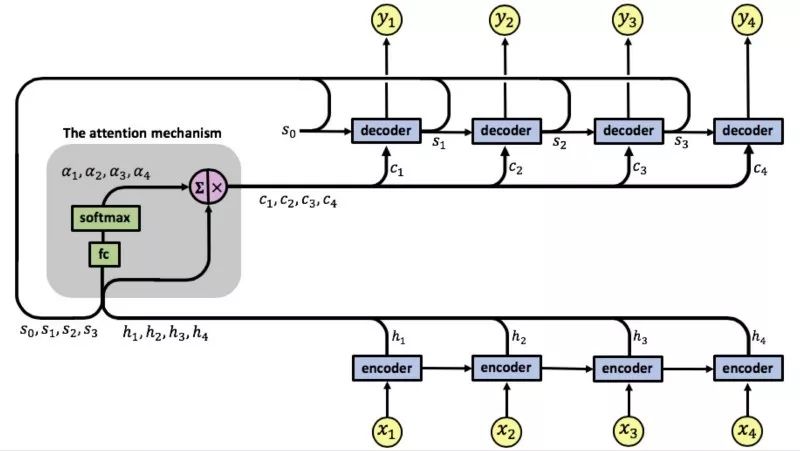
那么,这个“相关性分数”具体是如何计算的呢?主流方法主要有两种,它们体现了在模型设计上不同的权衡思路:
-
Bahdanau注意力(加性注意力): 此方法引入一个小型的前馈神经网络,专门用于学习“查询”(解码器隐状态)和“键”(编码器隐状态)之间的对齐关系。由于增加了一个独立的网络层来建模,其表达能力更强,但也带来了更高的计算开销。
-
Luong注意力(乘性注意力): 此方法采用更直接的点积(Dot-Product)或其变体来计算相似度。这种方式计算效率极高,因为它几乎不引入新的学习参数,但其效果在一定程度上依赖于“查询”和“键”的向量表示本身已经能很好地蕴含相似性信息。
这种注意力机制使模型不再试图“死记硬背”整个输入序列,而是根据当前任务动态提取最相关的信息。
举例来说,机器翻译时,生成动词可能会关注源句的主语和宾语,而生成形容词时,注意力则会迅速转向被修饰的名词。RNN + Attention的组合一度成为序列处理的主流架构。
注意力机制无疑是提供了一种强大的、可以连接任意序列位置的工具。
这自然地引出了一个颠覆性的疑问:如果注意力本身已经足以捕捉长距离依赖,那么RNN为了维持顺序信息而进行的、步步为营的循环计算,是否还是必要的?它会不会反而成为了限制模型并行计算能力的瓶颈?
GeoAI——关于时空数据,我们在预测什么?#
按照惯例,本节或许应该向读者呈现一系列RNN在地理空间智能(GeoAI)中的“经典应用”。但实际上,所谓“经典应用”并不好界定。
交通流量预测确实涉及地理空间和及其特性,但这一方向早已在计算机科学的时序预测领域形成自洽体系;另一方面,模型设计的精巧之处往往根植于其所要应对的数据特性。
若无法建立起对时空数据的基本世界观,那么在后续章节即将登场的Transformer、Diffusion等模型或许会变成纯粹技术上的自白。
因此,本节并非要告诉读者“如何建模”,而是尝试埋下一颗关于“时空”的思考种子。
随着后续内容展开,这颗种子或许会逐渐生根发芽。当你面对一个新的GeoAI模型时,会自然地追问:它如何体现空间的异质性?它如何处理时间与空间的依赖?
在阅读本节之前,不妨先思考:关于时空数据,我们究竟在预测什么?回答这个问题,需要我们看懂技术在“古”与“今”中的交叠。
从“古”到“今”:时间的特性不曾改变#
如本章开篇所述,在深度学习流行之前,时间序列预测主要依赖统计学方法,其核心是深入挖掘数据自身的内在规律。
尽管这些方法在今天看来颇为“古早”,却为我们今天理解和构建时间序列模型奠定了核心的思维范式。
1. 分解法:从复杂波动中寻找规律#
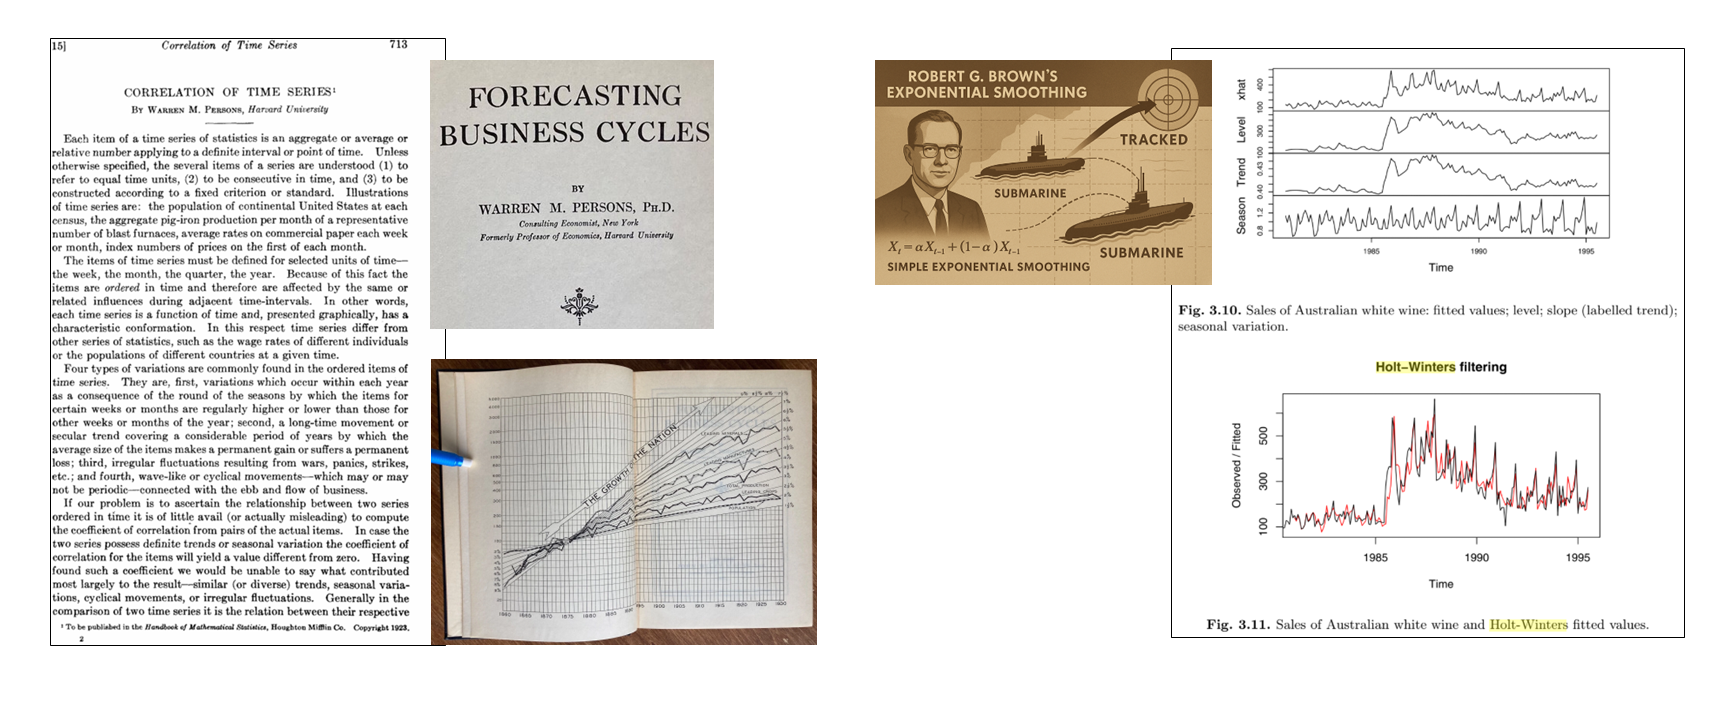
分解法是最早尝试把时间序列拆解成几个“相对稳定”的部分,即趋势(T)、季节性(S)、周期性(C)和残差/随机性(I)的叠加。
它起源于20世纪初经济学家和商业统计学家的工作,他们在面对复杂的经济波动时,希望通过在不同时间尺度上剥离成分,来更清晰地识别规律。
这一思路也在深度学习中得以延续,并发展为“多尺度建模”与“结构化表示”等理念。
其中,N-BEATS(2019)是最直接的例子,它通过深层全连接网络去学习一组基函数系数,再用线性组合拟合出趋势与季节性,其在M4时序预测数据集上的优异表现引发了广泛关注。
而后续的AutoFormer(2021)则更进一步,将分解原则内化为网络中的一个可微结构组件,让模型在处理过程中自动进行解构与重组。
2. 指数平滑法:时间衰减与记忆#
指数平滑法强调“时间衰减与记忆”——最近的观测值比早期的观测值包含更多关于未来的信息,因而应赋予更大的权重,权重随着时间向后呈指数式衰减。
这类方法出现在二战后期,满足了对军事物资需求的快速、自动化预测。其代表是Winters在1960年提出的Holt-Winters三参数指数平滑法,它把指数平滑的思想与趋势和季节性结合,形成了兼具“记忆”与“分解”的混合框架。
在思想上,这与LSTM的门控机制颇为相似:二者都在决定信息该保留还是遗忘。太阳底下没有新鲜事,即便是今日看似前沿的模型,也常能追溯到历史方法的影子。
3. ARIMA:经典时间序列预测的集大成者#
自回归集成移动平均模型(ARIMA) 融合了分解法与指数平滑的思想,由George Box与Gwilym Jenkins在1970年代提出,被视为时间序列预测的里程碑。
那么,来拆解一下ARIMA中字母的含义:
- AR(AutoRegressive,自回归): 未来是过去的延续,历史数据中蕴含着预测未来的信息,所以要用自身过去值(滞后项)作为特征来预测未来。
数学表达为:
-
MA(Moving Average,移动平均): 建模时应该考虑历史预测的“失误”所带来的冲击效应,所以用过去预测的误差(残差)来改进当前的预测。
-
I(Integrated,差分): 通过用当前值减去前一时刻的值,将非平稳序列转换为平稳序列。
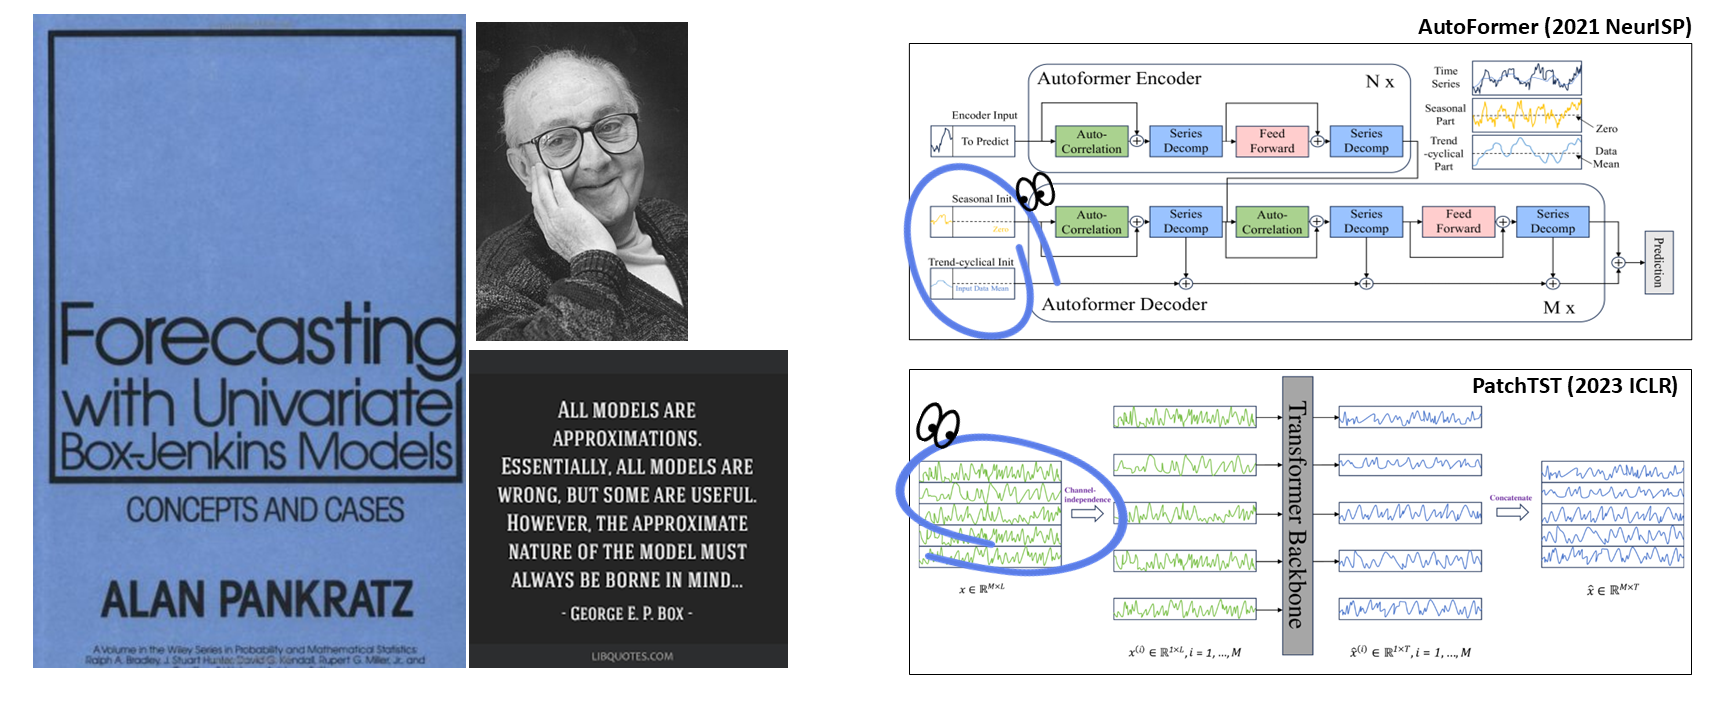
至此,从数据的时间特性出发,ARIMA已集成了时间序列建模的三大核心理念:自相关性(承认时间依赖性),趋势与季节性(分解时间模式)以及指数衰减(近期更重要)。
今日许多深度学习时序模型的框架设计,在很大程度上延续并再表达了这些思想——高明的创新往往是将那些被历史证明行之有效的“第一性原理”,用新时代的工具(无论是CNN/RNN还是Transformer,或者是将会出现的新模型)进行更高效“再表达”。
世界是个开放的复杂系统#
回到主线问题:关于时空数据,我们在预测什么?
细心的读者可能已经发现,刚刚谈及的这几个经典方法,实际上是为数据构建了一个内生的封闭的系统,它的预测完全是基于序列内部的自相关性和趋势(惯性)的一种外推。
然而,现实世界却是开放的复杂系统,常常受到“外力”扰动:以交通流量预测为例,一场暴雨、一次交通事故、一场演唱会的散场,都能瞬间打破交通系统的“惯性”。
而且同样的事件,在不同地点带来的后果截然不同:
- 一场暴雨在市中心可能导致交通瘫痪,在郊区却只是湿滑的路面。
- 一次主干道事故会产生远超支路事故的拥堵范围和持续时间。
这就揭示了地理空间分析中的一核心原则:空间非平稳性(Spatial Non-stationarity)——变量关系会随地理位置而变化。
正是这种对“此一时;彼一时;此一地;彼一地”的时空间依赖性有了深刻认知,GeoAI与传统时序预测有了根本区别。让我们来看不同时期,这种“时空思维”如何在模型中呈现。
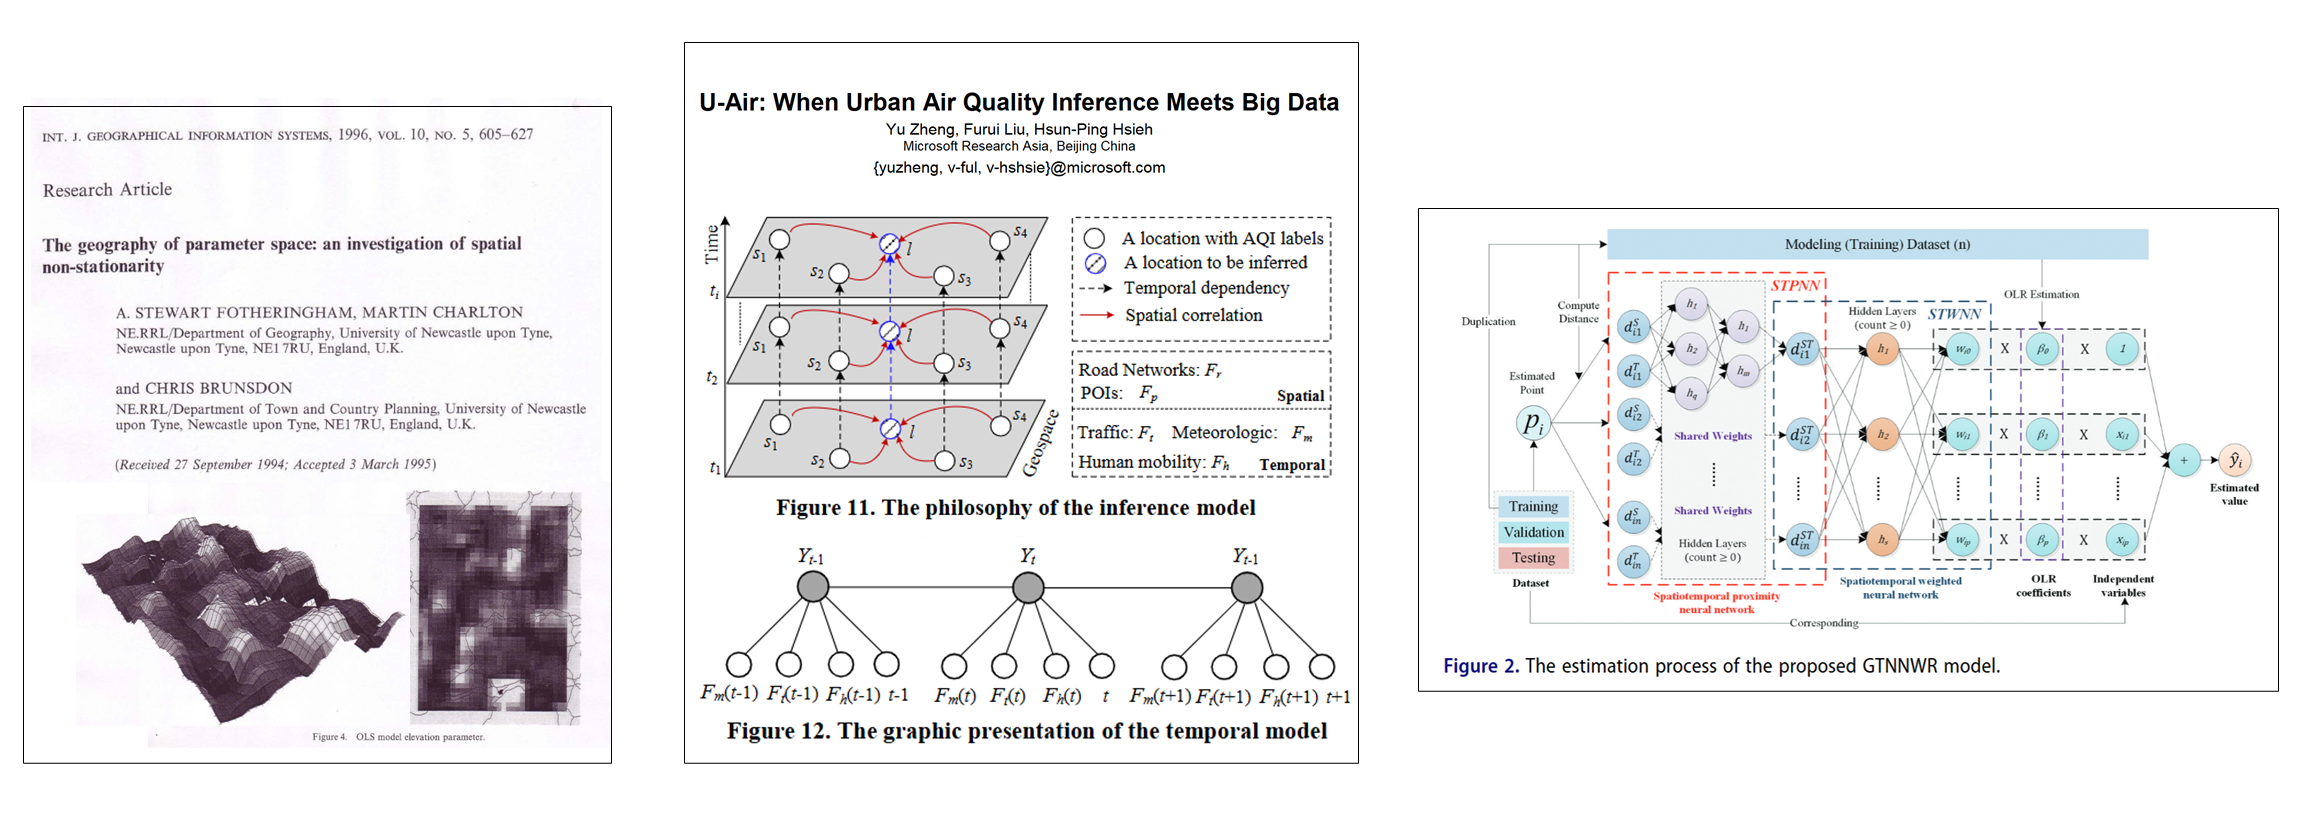
从这一脉络看,时空预测本质上是一种复杂系统中的关系建模:整合系统历史状态(时间维度)、外部驱动因子(天气、事件)、空间邻域影响,尽可能逼近“当前时刻”的系统状态,并由此推演未来。
GeoAI的视角下,则是借助深度学习模型从海量数据中自动学习到时空演化过程中的隐藏模式和关系。
那么,以使用LSTM进行城市中人类移动轨迹的预测为例,模型的输入除了历史轨迹点外,往往还需包括路网可达性和城市功能区的分布(空间约束),天气情况甚至是用户的社会属性等外部状态。模型会在隐藏层中自动学习这些外部状态与移动行为的数学关系。
然而,问题仍在:外部因子纷繁复杂,如何选择?空间约束和时空依赖是什么,如何定义?倘若我们将一切可得数据都投入深度学习模型,它是否真的能“预知一切”?
一个好的模型:关联时空#
本节无法直接回答这个问题,但历史与现状提供了启示。
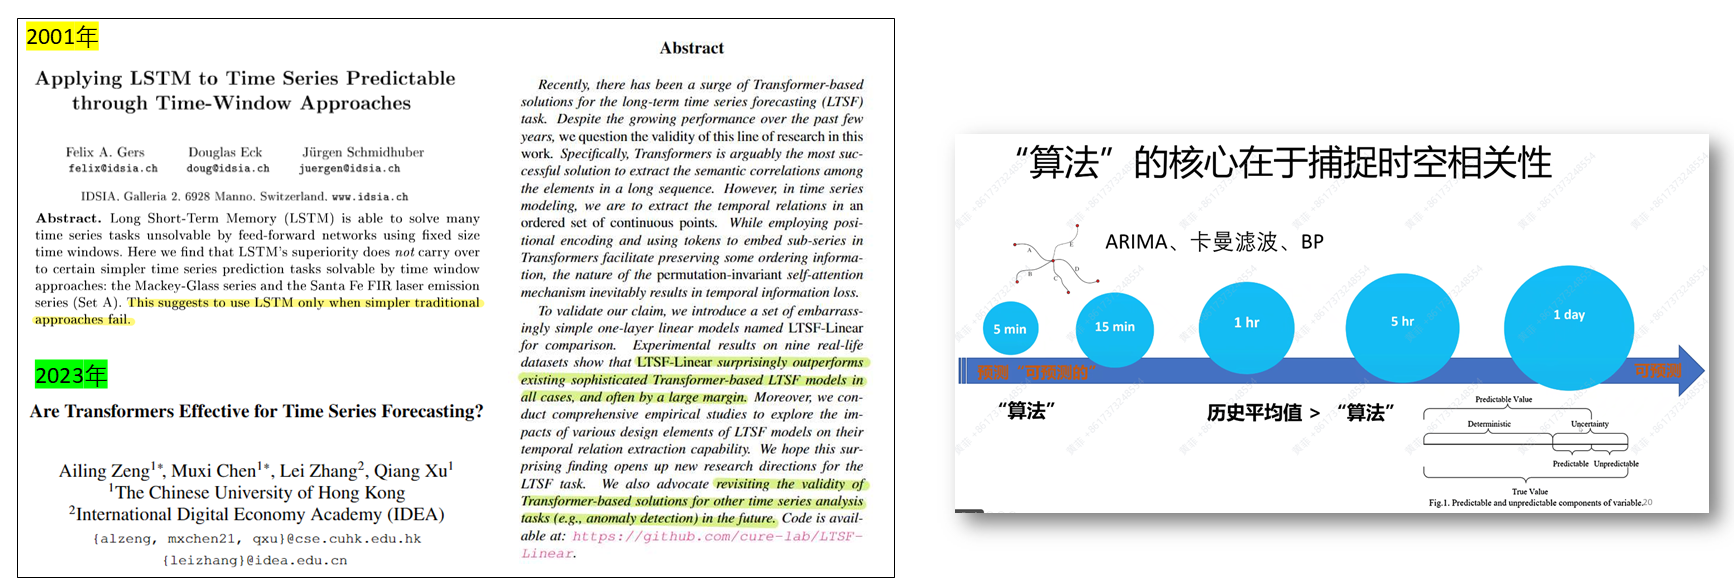
在2001年,一篇关于LSTM的研究发现,在一些可用时间窗口方法解决的序列预测任务上(如Mackey-Glass和Santa Fe激光序列的预测),并非每一次复杂建模都能带来预测增益。
相似地,在2023年的研究中发现(Are Transformers Effective for Time Series Forecasting?),尽管Transformers在长序列语义建模上表现出色,但时间序列预测的本质是连续点的顺序关系,而self-attention的置换不变性可能会导致时间信息损失。
有时LTSF-Linear的线性假设反而更贴近数据本身的韵律。而这一点在空间上则可呼应GWR的思想,过度假设空间的全局同质性可能掩盖局部异质性。
回到趋势、季节性与依赖衰减,这些方法源自经济数据归纳,具有一定可迁移性。
但如果时间分辨率改变,或者序列模态不同,规律的表现也会随之变化:日尺度或更长周期的序列中,历史平均值可能已足够精准;而在5分钟或15分钟的高频波动中,算法才真正展现捕捉时空依赖的能力。
就像地理空间中存在可变面元效应(MAUP),改变地图网格大小会重塑统计结果,改变时间分辨率也决定着我们能看到什么,又错过了什么。时间和空间在这一点上具有惊人的一致性。
这似乎是在提醒,规律的“可捕捉性”并非单纯由模型复杂度决定,而更取决于数据的时间–空间模态、尺度与内部结构。
数据的时空(不)可预测性#
在直觉上,就算将一切可得数据都投入深度学习模型,它也无法真的“预知一切”。
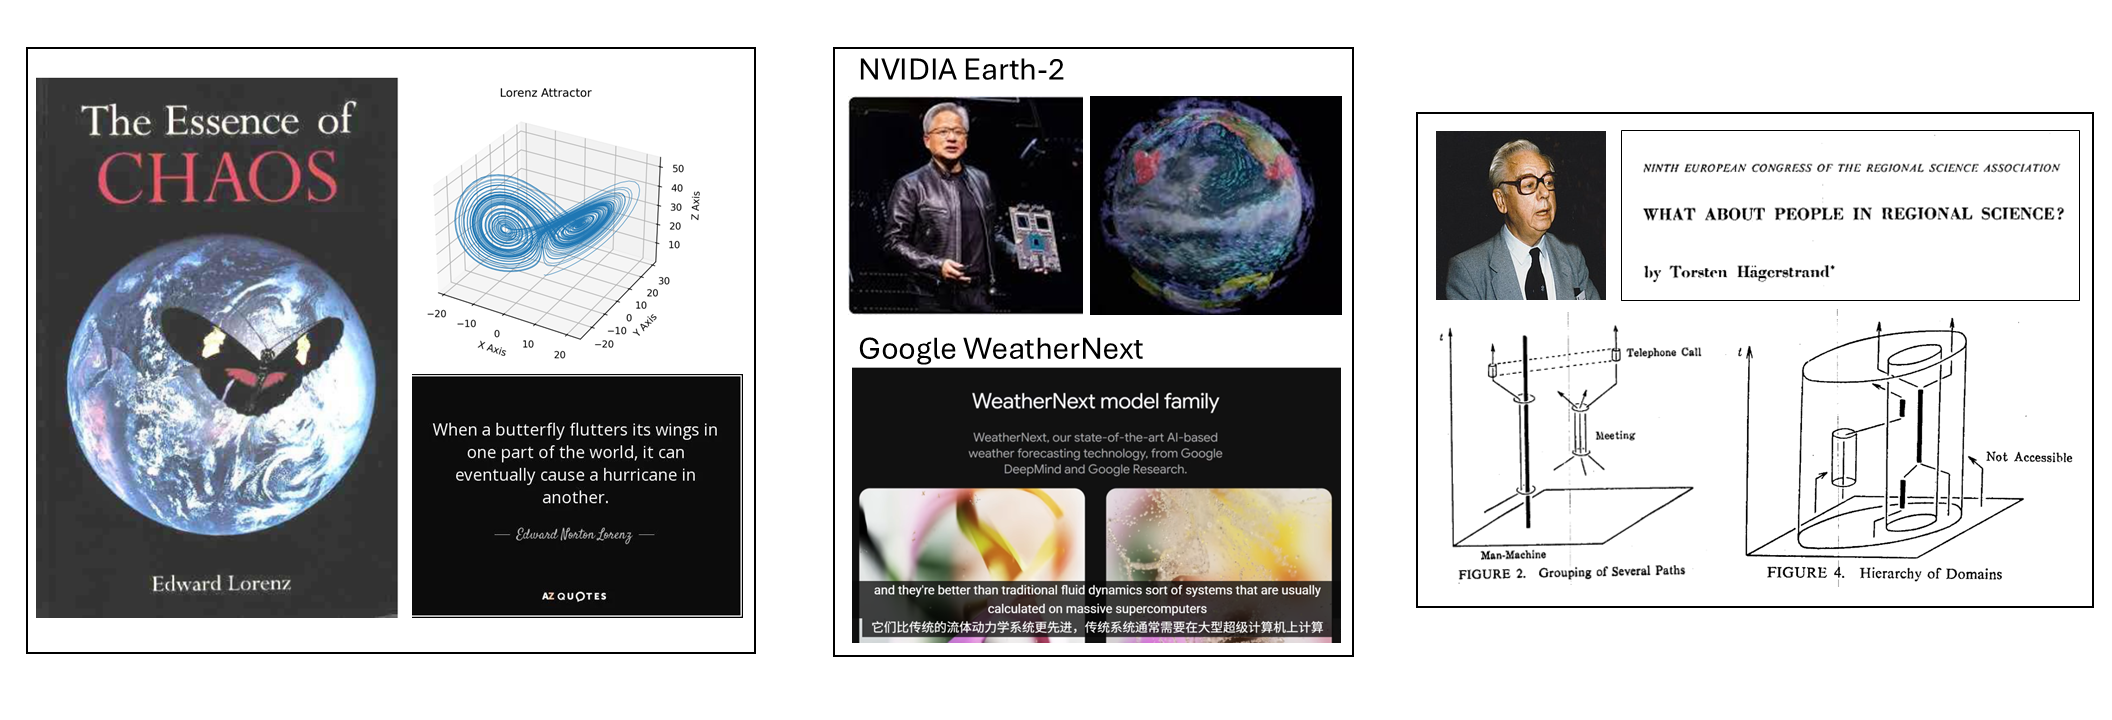
复杂系统对初始条件极端敏感,时间和空间相互作用可能产生非线性放大效应。以天气为例,微小扰动可引发暴雨或风暴,其影响会随时间演化,并在空间上形成扩散与梯度——这正是混沌理论揭示的特性。
但在模拟地球的背景下,NVIDIA构建的Earth-2、Google开发的WeatherNext似乎已在庞大的时空数据中捕捉到了一种“宏观上的秩序”,并非追求还原每一次风的轨迹、每一滴雨的落点,而是试图在统计意义上把握整体的动力学轮廓(注:这两个框架都是基于扩散模型构建,数学基础为郎之万动力学)——虽然微观行为充满不可预测性,但宏观模式仍然可以被学习和模拟。
这其实与Torsten Hägerstrand的时空棱镜理论所强调的颇为相似,个体移动不仅受时间约束(作息、活动窗口)影响,也受空间约束(道路网络、城市功能区)限制。
因而,即便城市中的人类移动也是一个高度依赖时空条件的非线性复杂系统,明确的时空约束仍为预测提供了可捕捉的规律。
换句话说,“(不)可预测”并不是绝对的,而是与尺度、对象和建模方式相关。便是最复杂的系统,也在某些尺度、某些层次上具有可捕捉的时空依赖。
于是,问题从能否预知一切转变为我们究竟想要预测什么。
从哈雷彗星的轨道参数,到ARIMA模型的滞后项,再到RNN的隐状态,序列建模的每一次飞跃,都伴随着对“状态”描述能力的提升。
然而,在地理空间中,“状态”的内涵变得空前丰富:它不仅包含时间上的前后关联,还蕴含着空间上的距离、拓扑、方向和语义。
如何将这些多维度的地理上下文,优雅地编码成模型能够理解的语言,至今仍是GeoAI领域的核心难题。
可以说,我们对时空预测能力的探索,其边界正取决于我们对时空表征能力的想象力。
作者信息与参考来源#
本科毕业于太原理工大学,现为深圳大学城市空间信息工程系,2024级测绘工程专业硕士研究生。
研究方向:GeoAI、POI去重与配置。
本科毕业于山东大学,现为深圳大学城市空间信息工程系,2023级人工智能专业硕士研究生。
研究方向:GeoAI、Geospatial Data Representation Learning。
深圳大学城市空间信息工程系,2022级博士研究生。
研究方向:GeoAI、Geospatial Tokenization、Human Mobility Generation、Geospatial Data Representation Learning。
本章节由陈堉铨、李国隆、黄菲负责编写,含AI工具辅助(GPT-5、Gemini 2.5 Pro),文中所用插图来源于网络。
封面图由即梦AI合成,prompt为:西班牙超现实主义画家萨尔瓦多·达利的《记忆的永恒》的风格。线条感,远景,小机器抬头仰望,复古,质感,色块,仰望时间,模糊的轮廓。抽象,奇幻,色块,扭曲的时间,时间线条。印象派背景,色彩,奇妙梦幻,时间漂浮,时钟飘在空中,另一个时钟扭曲,落在地上。
参考来源#
-
Wikipedia. (n.d.). Hidden Markov model. Retrieved September 20, 2025.
-
Elman, J. L. (1990). Finding structure in time. Cognitive Science, 14(2), 179–211.
-
Ahmed, N. A. (2022, November 10). Vanishing/Exploding Gradients in Deep Neural Networks. Comet.
-
Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735–1780.
-
Chung, J., Gulcehre, C., Cho, K., & Bengio, Y. (2014). Empirical evaluation of gated recurrent neural networks on sequence modeling. arXiv:1412.3555.
-
Jonte Dancker. (n.d.). A brief introduction to recurrent neural networks. Towards Data Science.
-
Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to sequence learning with neural networks. Advances in Neural Information Processing Systems, 27.
-
Minhaz Chowdhury. (2024, September 5). Exploring encoder-decoder architecture with LSTMs. Medium.
-
Bahdanau, D. (2014). Neural machine translation by jointly learning to align and translate. arXiv:1409.0473.
-
Wikipedia. (n.d.). Attention (machine learning). Retrieved September 20, 2025.
-
Luong, M. T., Pham, H., & Manning, C. D. (2015). Effective approaches to attention-based neural machine translation. arXiv:1508.04025.
-
Geographically and Temporally Neural Network Weighted Regression.
-
The geography of parameter space: An investigation of spatial non-stationarity.
-
Autoformer: Decomposition Transformers with Auto-Correlation for Long-Term Series Forecasting.
-
A Time Series is Worth 64 Words: Long-term Forecasting with Transformers.