Wiki Foundations3 Concepts and Frameworks of AI
3.6 Tokenization
在上一章,我们把视角落在模型的内部世界——潜空间(Latent Space)。在那里,相似的样本彼此靠近,不同的类别自然分离,某些语义关系甚至会被转化为几何上的方向与距离。
Latent Space 就像一套由模型自己“长”出来的世界坐标系,它用大量向量的排列,组织起对外部世界的理解。
但在讨论 Latent Space 的形状和结构时,有一个更基础的问题被轻轻略过:这些高维向量本身从何而来?
一段文本、一张图片、一个声音片段,最初并不是向量;它们是符号、是像素、是时间上的信号。
那么,它们如何进入这套内部坐标系?又是谁在决定它们以什么样的方式被“放进去”?
或许,要理解模型为何会在“聪明”与“愚蠢”之间摇摆,我们需要从源头追问:从数据进入模型的那一刻;从它决定“以何种最小单元来组织世界”——这就是本章即将探索的概念,Tokenization。
Token:AI 眼中的最小信息单元#
要让一段文本、一张图像在模型的内部世界里占据一个位置,总得先有某种记录方式。即,模型得先决定:用什么样的单元来记录它们的存在。
这一点在人类身上也并不陌生,回想一下自己小时候学汉字的过程:
一开始,老师会教你认单个字:“山、水、人、日”;很快你会发现,一个字往往不够用,于是出现“山水、行人、日出”这样的词;再往后,老师要求你用这些词造句、写段落,还要会组织结构,如开篇明义、承上启下,最后写成一篇完整的文章。
在这个过程中,“笔画 → 偏旁 → 汉字 → 词语 → 句子 → 段落”,是一条层层封装的链条:越往上,语义越完整;越往下,颗粒越细。
我们可以做个小测试:
大多数人都会卡壳一下。
但把它们放进词里:犄角旮旯、邯郸、深圳、奢侈,你大概就能顺畅读出来了。
这个原因很简单:人脑更习惯在“成块”的语义单元上运作,而不是在完全孤立的字形上。
这条直觉,在大语言模型身上同样成立,只是它使用的“块”叫做 Token。
从文本到 Token,再到编号#
当我们把一句话喂给模型,例如:
小明在犄角旮旯里邯郸学步,而小红在深圳过着奢侈的生活。
在屏幕上,你看到的是熟悉的汉字序列,一眼就能理解其中大致的意思;但对模型来说,这并不是一件容易的事。
模型想要理解语义,就需要先把这串字符切成一个个的 Token。
这一步由 Tokenizer(中文翻译为“分词器”,但实际上切分出来的未必是词,也可以是标点符号、数字或者某个单词的一部分)完成。
它会按照自己的一套规则,把原始文本拆开,比如:
- 有的模型会把“犄角旮旯”当成几个罕见字的组合。
- 有的模型会把“小明”和“小红”当成整体。
- 有的模型会把“在深圳”视作一个高频片段,把“奢侈”拆成两个子词。
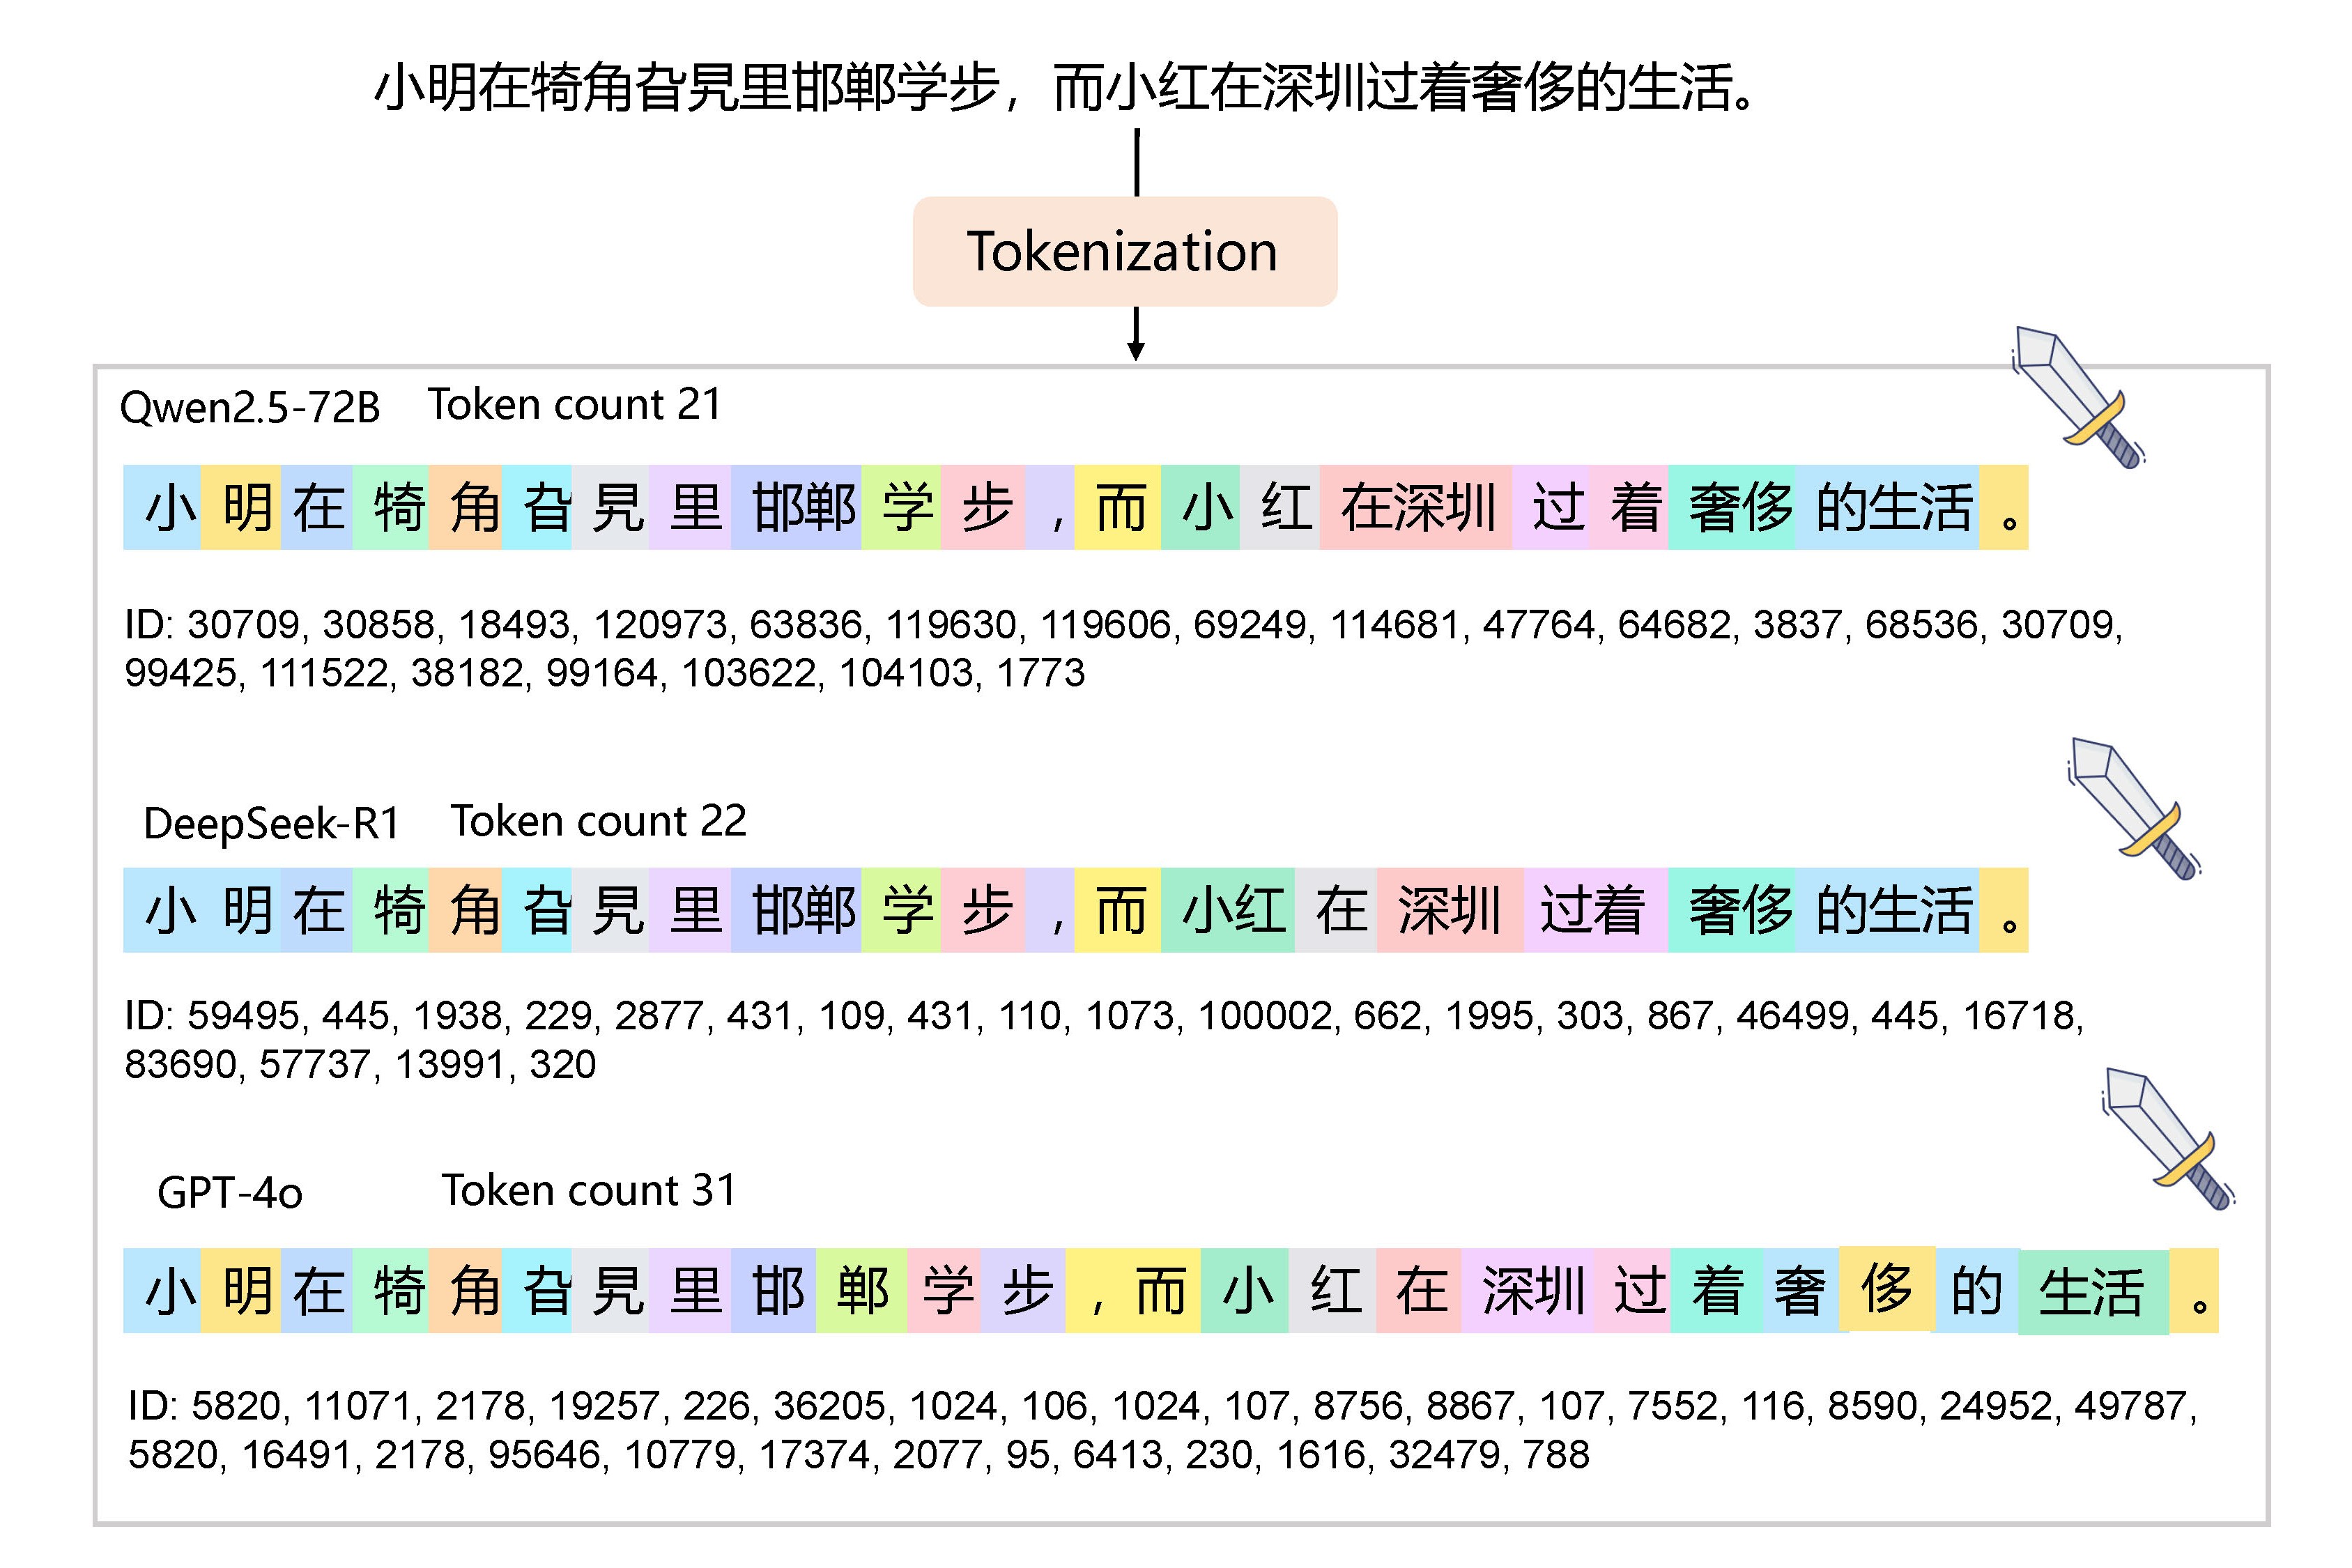
上图所呈现的那些五颜六色的色块,就是 Token。
但到目前为止,它们还没有任何语义,只是被切出来的单元。
接下来,需要给每个 Token 分配一个唯一的编号,就像给每块乐高积木贴上编号:
- “小”可能对应 ID 5327。
- “深圳”可能对应 ID 19483。
- “侈”可能对应 ID 87654。
在模型的输入里,真正流动的并不是“汉字”,而是一串串整数 ID。
这也是为什么调用 LLM API 时,计费单位不是字数,而是 Token 数量——因为从底层算力的角度看,模型关心的是处理了多少个编号,而不是你写了多少个字。
把原始文本切分成这些离散单元,并为它们分配编号的整个过程,就叫做 Tokenization。
编号背后的向量:Embedding 如何“长出”语义#
如果 Token 只是整数编号,那模型是怎么“理解”它们的呢?
关键是第三步:Embedding(嵌入表示)。
可以把模型想象成一本极厚的词典:每个 Token ID 都会在一张“查表”里,找到一行高维向量:
- ID 5327 → 一个长为4096的向量。
- ID 19483 → 另一个4096维向量。
这些向量就是 Embedding,是模型真正能够计算的对象。
它们一开始是随机初始化的,在训练过程中会不断被调整:出现在相似上下文中的 Token(比如“深圳”和“广州”),其向量会被拉得更近;语义相反的词(比如“高”和“低”),在某些维度上会呈现出相反的方向;同一个 Token 在不同上下文中承担的搭配关系,也会在向量的不同维度上被编码。
于是,原本毫无意义的整数 ID,通过 Embedding 这一步,被映射到了一个连续的语义空间。
在这个空间里,“距离”“方向”“角度”等几何关系,开始承载语义上的相似、对立与组合能力。
从这一步开始,模型才真正进入我们在 Transformer 章节中描述过的那条流程:
换句话说,模型并不会“在字上思考”,而是在高维向量上做几何运算。
而这些向量又完全依赖于前一步:我们是如何把语言切成一个个 Token,并赋予它有意义的 Embedding。
不同的切法,看到不同的结构#
我们再回头看刚才那句例子:
小明在犄角旮旯里邯郸学步,而小红在深圳过着奢侈的生活。
在你眼中,它是一整句话,是一个完整的场景;在模型眼中,它能够理解这句话的语义很大程度上取决于分词器的“刀法”:
- 如果一个模型把“小明”“小红”以及“在深圳”视作整体 Token,它更容易捕捉到“人物 + 地点”的结构模式。
- 如果另一个模型把“奢侈”拆成“奢”和“侈”两个 Token,那它学习到的可能更多是部件之间的统计关联,而不是词语作为整体的情绪色彩。
- 如果某些生僻成语被拆得七零八落,它就更难在 Embedding 空间里为这些词找到稳定的位置。
同一句话,在不同模型内部,会对应到不同的 Token 序列、不同的 Embedding 分布。
可以说,每一种 Tokenization 方法,都在回答一个问题:
我打算用怎样的单位,来描述这段语言中的结构?
这就是模型理解语言时的第一道栅栏:数据被切成什么样的单元,模型就在这样的单元上去发现关系、建构结构。
Tokenization 的尺度:“粗”与“细”的拉扯#
我们已经看到,模型理解文本的第一步,是把连续的文本转换为一串 Token,再由这些 Token 进入 Embedding 空间。
于是会自然冒出一个问题:以语言为例,我们应该把它切成多大的单元?
一词、一字,或是偏旁部首?
这个问题看似简单,实则困扰自然语言处理(NLP)领域二十多年,也没有一个完美答案。
原因很朴素:语言本身是灵活的,而 Tokenization 总要做出某种固定的选择。
最早的直觉是:既然“词”是语言中最直观的语义单位,那每个词就应该是一个 Token。
这种方法对英语来说看上去很合理,因为空格天然标记了词边界。所以在20世纪末期的 NLP 模型里,“one token = one word”是很常见的设定。
但问题也接踵而至:
- 词形变化太多。 run / runs / running / ran 或是 dog / dogs / dog’s / dogs’,每种变化都需要一个新 Token,词表很快膨胀到不可收拾。
- 语言差异极大,无法通用。 中文没有空格,日语中汉字假名混写,土耳其语、芬兰语等黏着语,一个词可以包含多个语法功能。
- 未登录词(OOV)成灾。 新名字、新词汇、拼写错误……任何没见过的词都变成一个黑洞:“我不认识这个”。
词级 Tokenization 就像是试图给天空中形状不断变化的云都贴上标签——看上去语义完整,但工程上却无法维持。
为了摆脱词表爆炸的问题,有人提出最极端的方案:把所有文本切成一个个字符就好了!
这样做的优点确实非常诱人:词表极小(英文只需不到256个字符),不会再有 OOV 问题;任意新词、外来词、网络语都能被完美覆盖;对多语言友好,所有字符都能以同样方式处理。
但代价同样巨大:
- 序列长度变得极长。 比如,“strawberry”从一个 Token 变成10个字符 Token
[s, t, r, a, w, b, e, r, r, y]。情况越复杂,序列越膨胀,模型计算成本也随之增加。 - 语义碎裂,学习困难。 模型必须从 s、t、r 重新推演出“str”这个音段、再推到“straw”的概念,最后才可能逼近“草莓”。对模型而言,这更像是在处理噪声组合,而不是现成的语言单元。
- 长距离依赖变难。 一个句子被拆成几百个字符后,模型很难在注意力机制(Attention)中维持整体结构。
子词(Subword):折中之策#
在词级太粗、字符级太细的两极之间,研究者提出了一条折中路线:把语言切成“可以复用的片段”,就像用积木可以搭出风格各异的城堡。
这就是子词(Subword)方法。
现代大模型的主流分词器,都属于子词派,只是各家刀法不同。
下面我们不讨论算法公式,而是从“它们偏好怎样切”来理解它们的差异。
1. 字节对编码(BPE / Byte-level BPE):高频优先的统计派
BPE 的逻辑非常简单:先从所有字符开始 → 找出语料中最常相邻出现的两个符号 → 把它们合并成新的 Token → 不断重复……
最终高频词会逐渐变成更大的 Token,低频词则保持较细的颗粒度。
Byte-Level BPE(如 GPT-2、DeepSeek 等)更进一步:直接在0~255的字节序列上操作,不依赖 Unicode、空格或任何语言规则,从而在跨语言上具备高度稳健性。
但它的问题也很明显:高频构词单元会被捕捉到,但频率与语言学语义并非总是完全一致,例如把“unbelievable”拆成“un + believ + able”还算合理。
但在中文中,字符的共现频率并不稳定对应语义结构。
例如“的人”因出现频率极高(“很多的人”“所有的人”),往往会被直接合并成一个 Token,而“研究生”却可能被拆成“研究”与“生”。
从频率角度看这种切法合理,但与语义边界并不一致。
2. WordPiece:让语料更自然的概率派
WordPiece(用于 BERT)反其道而行:它不问“出现次数多不多”,而问“把这两个合起来,会不会让整个语料更像自然语言”。
它的目标是最大化语言模型的整体似然,因此更接近词根、前后缀等传统语言学结构。
其缺点是:强依赖空格预分词 → 对中文不友好;词表对不同语言的偏好很明显。
3. SentencePiece:去语言假设的极简派
SentencePiece 进一步往“通用”方向走:把文本当成原始字符流,不假设空格、词边界,空格也只是一个可学习的符号。
它的 Unigram 模型从一个巨大的候选集合开始,不断删除“贡献最小的子词”,最终留下统计意义上最稳健的词表。
这使它成为跨语言模型(如 T5、mBART)的常用选择。
“错误回答”背后的真相#
在理解了这些分词方法之后,我们可以重新回到那些人类可以轻易答对,但 LLM 却回答错误的例子:
为什么有些模型认为 9.11 比 9.9 大?
原因之一在于,它并没有把“9.11”当作一个整体的数值,而是当作一串 Token。
在大多数模型中,9.11 会被切成 [9] [.] [11],而 9.9 被切成 [9] [.] [9]。
于是 Embedding 层看到的是:
- “11”是一个 Token,有独立向量。
- “9”是一个 Token,有独立向量。
在训练语料中,“11”常出现在“更大”的场景里,从而影响模型的判断。
当你把问题换成:“从数值角度看,9.11 和 9.9 谁更大?”模型往往又能答对。
因为这种问法触发了更明确的语义轨道,让模型召回“数学类上下文”的模式。
这个例子直观地反映出:模型的判断方式,与它“如何将输入拆解为 Token,并在何种语境下使用这些 Embedding”密切相关。
类似地,当我们让模型去数 strawberry 里有几个 r 时,它看到的往往也不是一串整齐的字母,而是已经被切好的子词片段:例如 ["straw", "berry"],或更细一些的 ["str", "aw", "berry"]。
模型学习的单位从一开始就是这些 Token:它知道“straw”常与“berry”同时出现,也知道“berry”在食品语境里出现得更频繁;但它并不会像人一样沿着字母逐个扫描。
于是,“数 r”和“比较 9.11 与 9.8”虽然表面上属于完全不同的题型,一个是数数,一个是算术,但在模型内部,它们其实落在同一个层面:
都要求模型绕过 Token,直接在更细的符号层面(字符、数位)上精确操作,而这恰恰不是它平时最常练习的模式。
到此读者大概可以看出:Tokenization 并不只是“把文本切开”,它更像是在规定模型能够观察和操作的单位的尺度与边界。
一旦确定,模型所能观察到的结构、能够形成的经验、甚至会犯的错误,也随之被固定下来。
粒度太粗,信息被压成大块;粒度太细,信息又被打成碎片;子词方法试图折中,但每一种折中都隐含着不同的偏好。
而这些偏好最终沉入模型内部,变成它的 Embedding 分布、语义结构与可能的误差模式,以及最重要的——基于数据建立的“世界观”。
视觉 Token:当图像被转译成序列#
在语言中,Token 是天然离散的:字母、汉字、词语,本身就是人类发明的符号单元。
但图像不是。一张照片是连续的光强分布,是流动而密集的纹理细节。
然而 Transformer 这类架构的前提,是接收向量序列。
这意味着,当我们希望用类似的架构去处理图像时,需要先回答一个问题:
一幅图像,应该被拆成什么样的“序列单元”,才能交给模型去处理?
视觉 Tokenization 便是在这个问题下逐步形成的一套做法。
为什么图像也需要 Tokenization?#
可以先做一个简单的数量级估算。
如果我们把一张 224×224 的图像直接展平成像素序列,就会得到 50,176 个位置(若考虑 RGB 通道,还会更多)。
在自注意力机制中,需要处理的是一个接近 50k × 50k 的相关性矩阵,这在计算上很难直接承受。
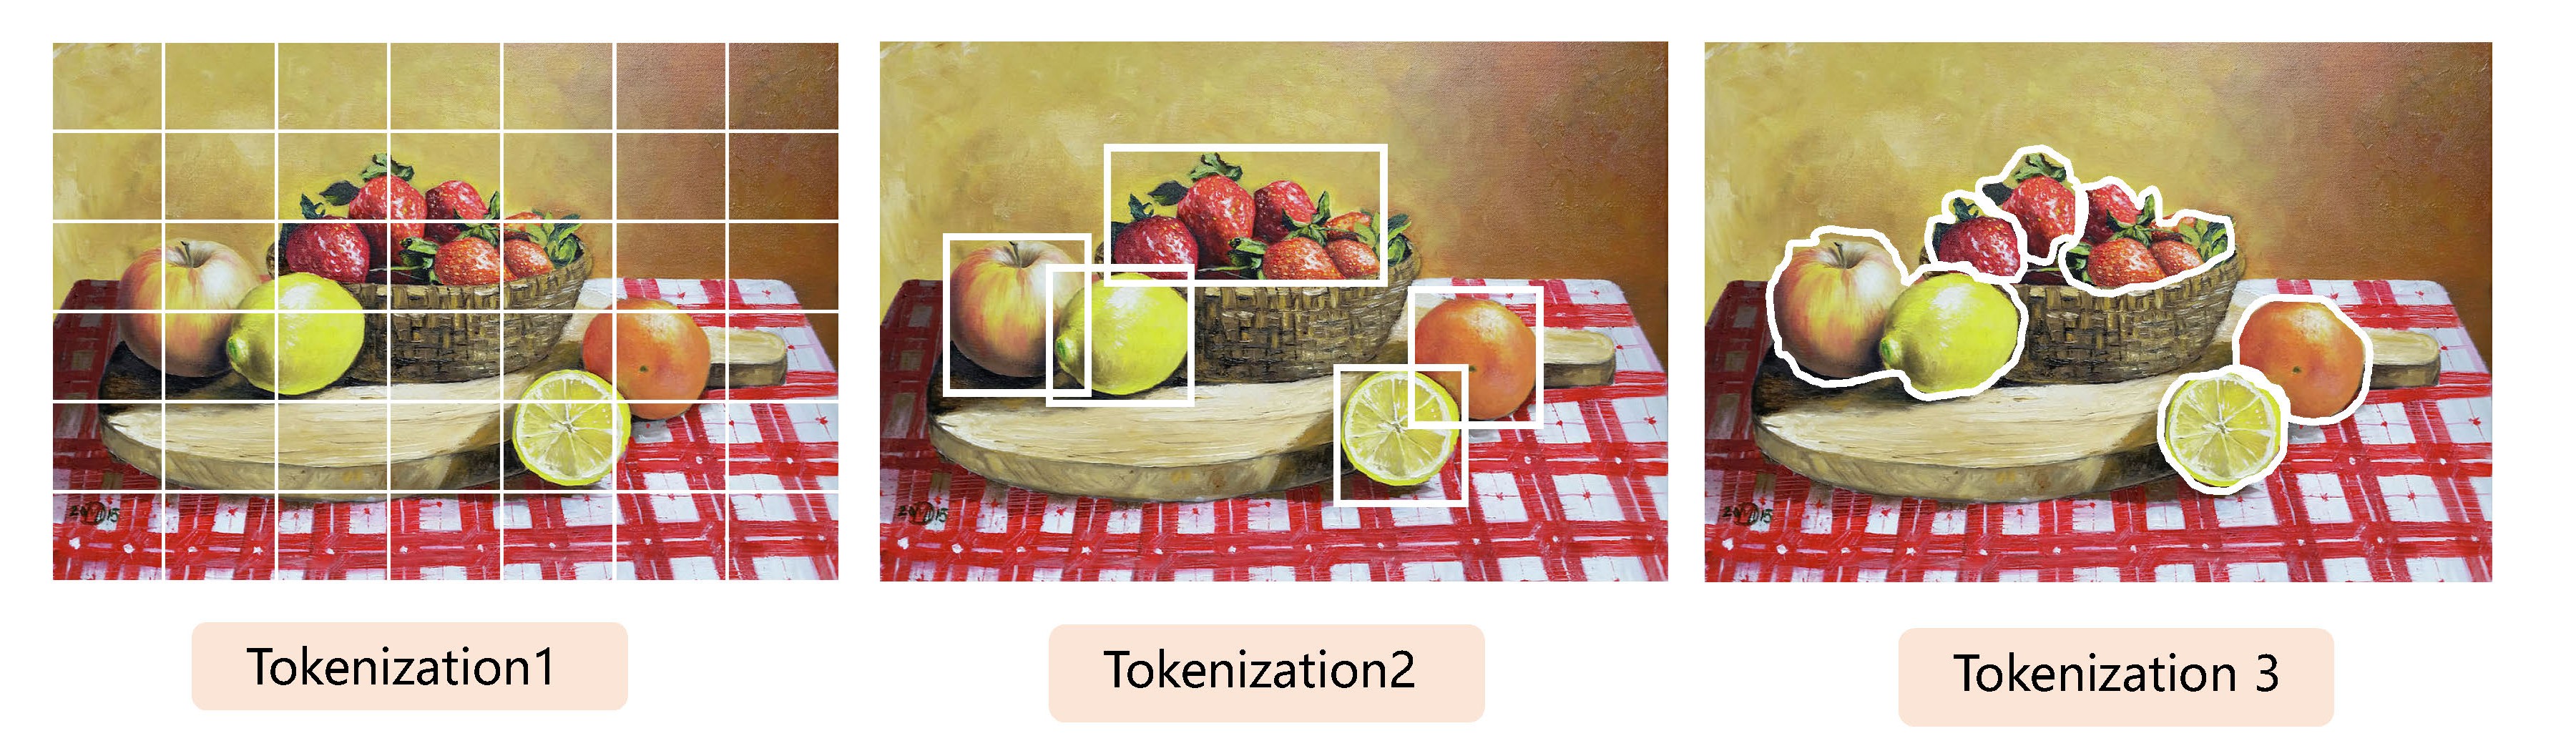
于是,研究者提出了一个非常工程化、同时也非常暴力的决定:把图像切成若干小块,每块视为一个 Token。
这就像把一幅画切成16×16的拼图块。每一个拼图块,成为模型的一个输入单位。
这便是 Vision Transformer(ViT)提出的经典做法:如果 Patch 大小为16×16,一张 224×224 的图像会被切成:
个 Patch Token。
196 个 Token——与语言中的几十个 Token 数量级相近,Transformer 终于能消化这样的序列了。
那么,Patch Token 能让模型“看到”什么?
切成 Patch 之后,每个 Token 对应的是图像中的一个局部区域:一个 Patch 可能是苹果的一部分;或是桌子的一小块纹理、桌布的一角。
这些 Patch 一开始并没有语义标签,只是局部视觉信息的载体。
模型需要在多层 Attention 与前馈网络的作用下,逐渐从这些局部中抽取出对象、边界与场景结构。
与文本 Token 相比,有一个明显区别:文本 Token 往往直接对应一个符号单元,其边界通常与语义边界接近;图像 Patch 的边界则与物体边界未必一致,更像是一个规则网格在连续场上的投影。
连续 vs. 离散#
这种粗暴的 Patch 化切法带来三重结构性问题:
1. 信息密度不均
一个16×16的 Patch 里,可能包含水果的某个部位,或者变化复杂的纹理。
但这些 Patch 在模型内部都只有一样的“权重”。
模型需要通过注意力才能判断哪些 Patch 重要、哪些不重要。
这造成视觉理解的一个常见现象:模型对细节的把握经常不足,对整体结构的重建也不稳定。
2. 语义边界不对齐
语言的 Token 边界大多与语义边界相对一致:“水果”和“桌子”这种词天然是语义单位。
但对图像来说,一块规则的网格不会因为看到“苹果”或“香蕉”而改变形状,它只按照固定步长切割。
于是,一个完整的果实往往被拆成数块:颜色落在不同格子里,轮廓被切断,纹理跨越 Patch。
模型接收到的,不是一整个“东西”,而是被网格分散后的若干片段,它需要在更高层的表示里重新把这些片段组织成连贯的对象。
3. Token 太少 → 模型看世界的“像素”太粗
196 个 Patch Token 装载的信息远不足一张百万像素的图像。
这意味着模型必须“压缩式理解”:积木块少(Token 少),每个积木块很大,世界只能被粗略分辨。
这就造成:视觉 Token 是一种低分辨率的世界。文本 Token 是一种高分辨率的世界。
这也解释了为什么在多模态模型中,语言 Token 经常在注意力中“盖过”视觉 Token:
文本 Token 的语义信息密度更高、表达更明确、边界更清晰。
除了 ViT 这种基于 Patch 的做法,在视觉生成领域还出现了另一条路线:先把图像压缩到一个低维的潜空间(Latent Space),再用一个有限大小的“码本”(Codebook)把每个 Latent Block 映射成离散的索引 Token。
在 VQ-VAE、VQ-GAN、RQ-VAE 等模型中,一张高分辨率图像会被编码成一个较小的 Latent 特征图,特征图的每个位置会被量化到码本中的某个向量,对应一个离散编号。
这样,一张图像就可以用一串有限词表中的 Token 来描述,便于用 Transformer 等模型进行自回归生成。
与 Patch Token 相比,这一类表示更强调:
- 压缩能力: 用尽可能少的 Token 表示尽可能多的信息。
- 生成友好: 方便作为“视觉词序列”被语言模型风格的架构处理。
尽管两条路线在形式上不同:一种偏向连续特征,一种偏向离散索引;它们都在尝试回答同一个问题:
如何在可接受的计算量下,为模型提供足够丰富、又便于操作的视觉结构单元?
Tokenization 之后:结构、模态与世界模型#
到此,读者或许已经明白,不论是语言、图片或是由静态图片衍生出的动态视频,Tokenization 都会经历类似的两步:
- 把数据转化为一组基本单元,即 Token。
- 再为每个单元赋予一个向量表示,即 Embedding。
在这个意义上,Tokenization 为每种模态选择了“模型将以何种视角去解构与理解数据”:
语言强调符号之间的组合关系,图像强调空间邻域与局部纹理,视频与行为则包含时间结构与因果约束。
而在人类的感知与理解中,多模态并非是分离的:我们不会把“看见的猫”和“听见的猫叫”“说出的‘猫’这个词”视作独立对象,它们自然地指向同一个概念。
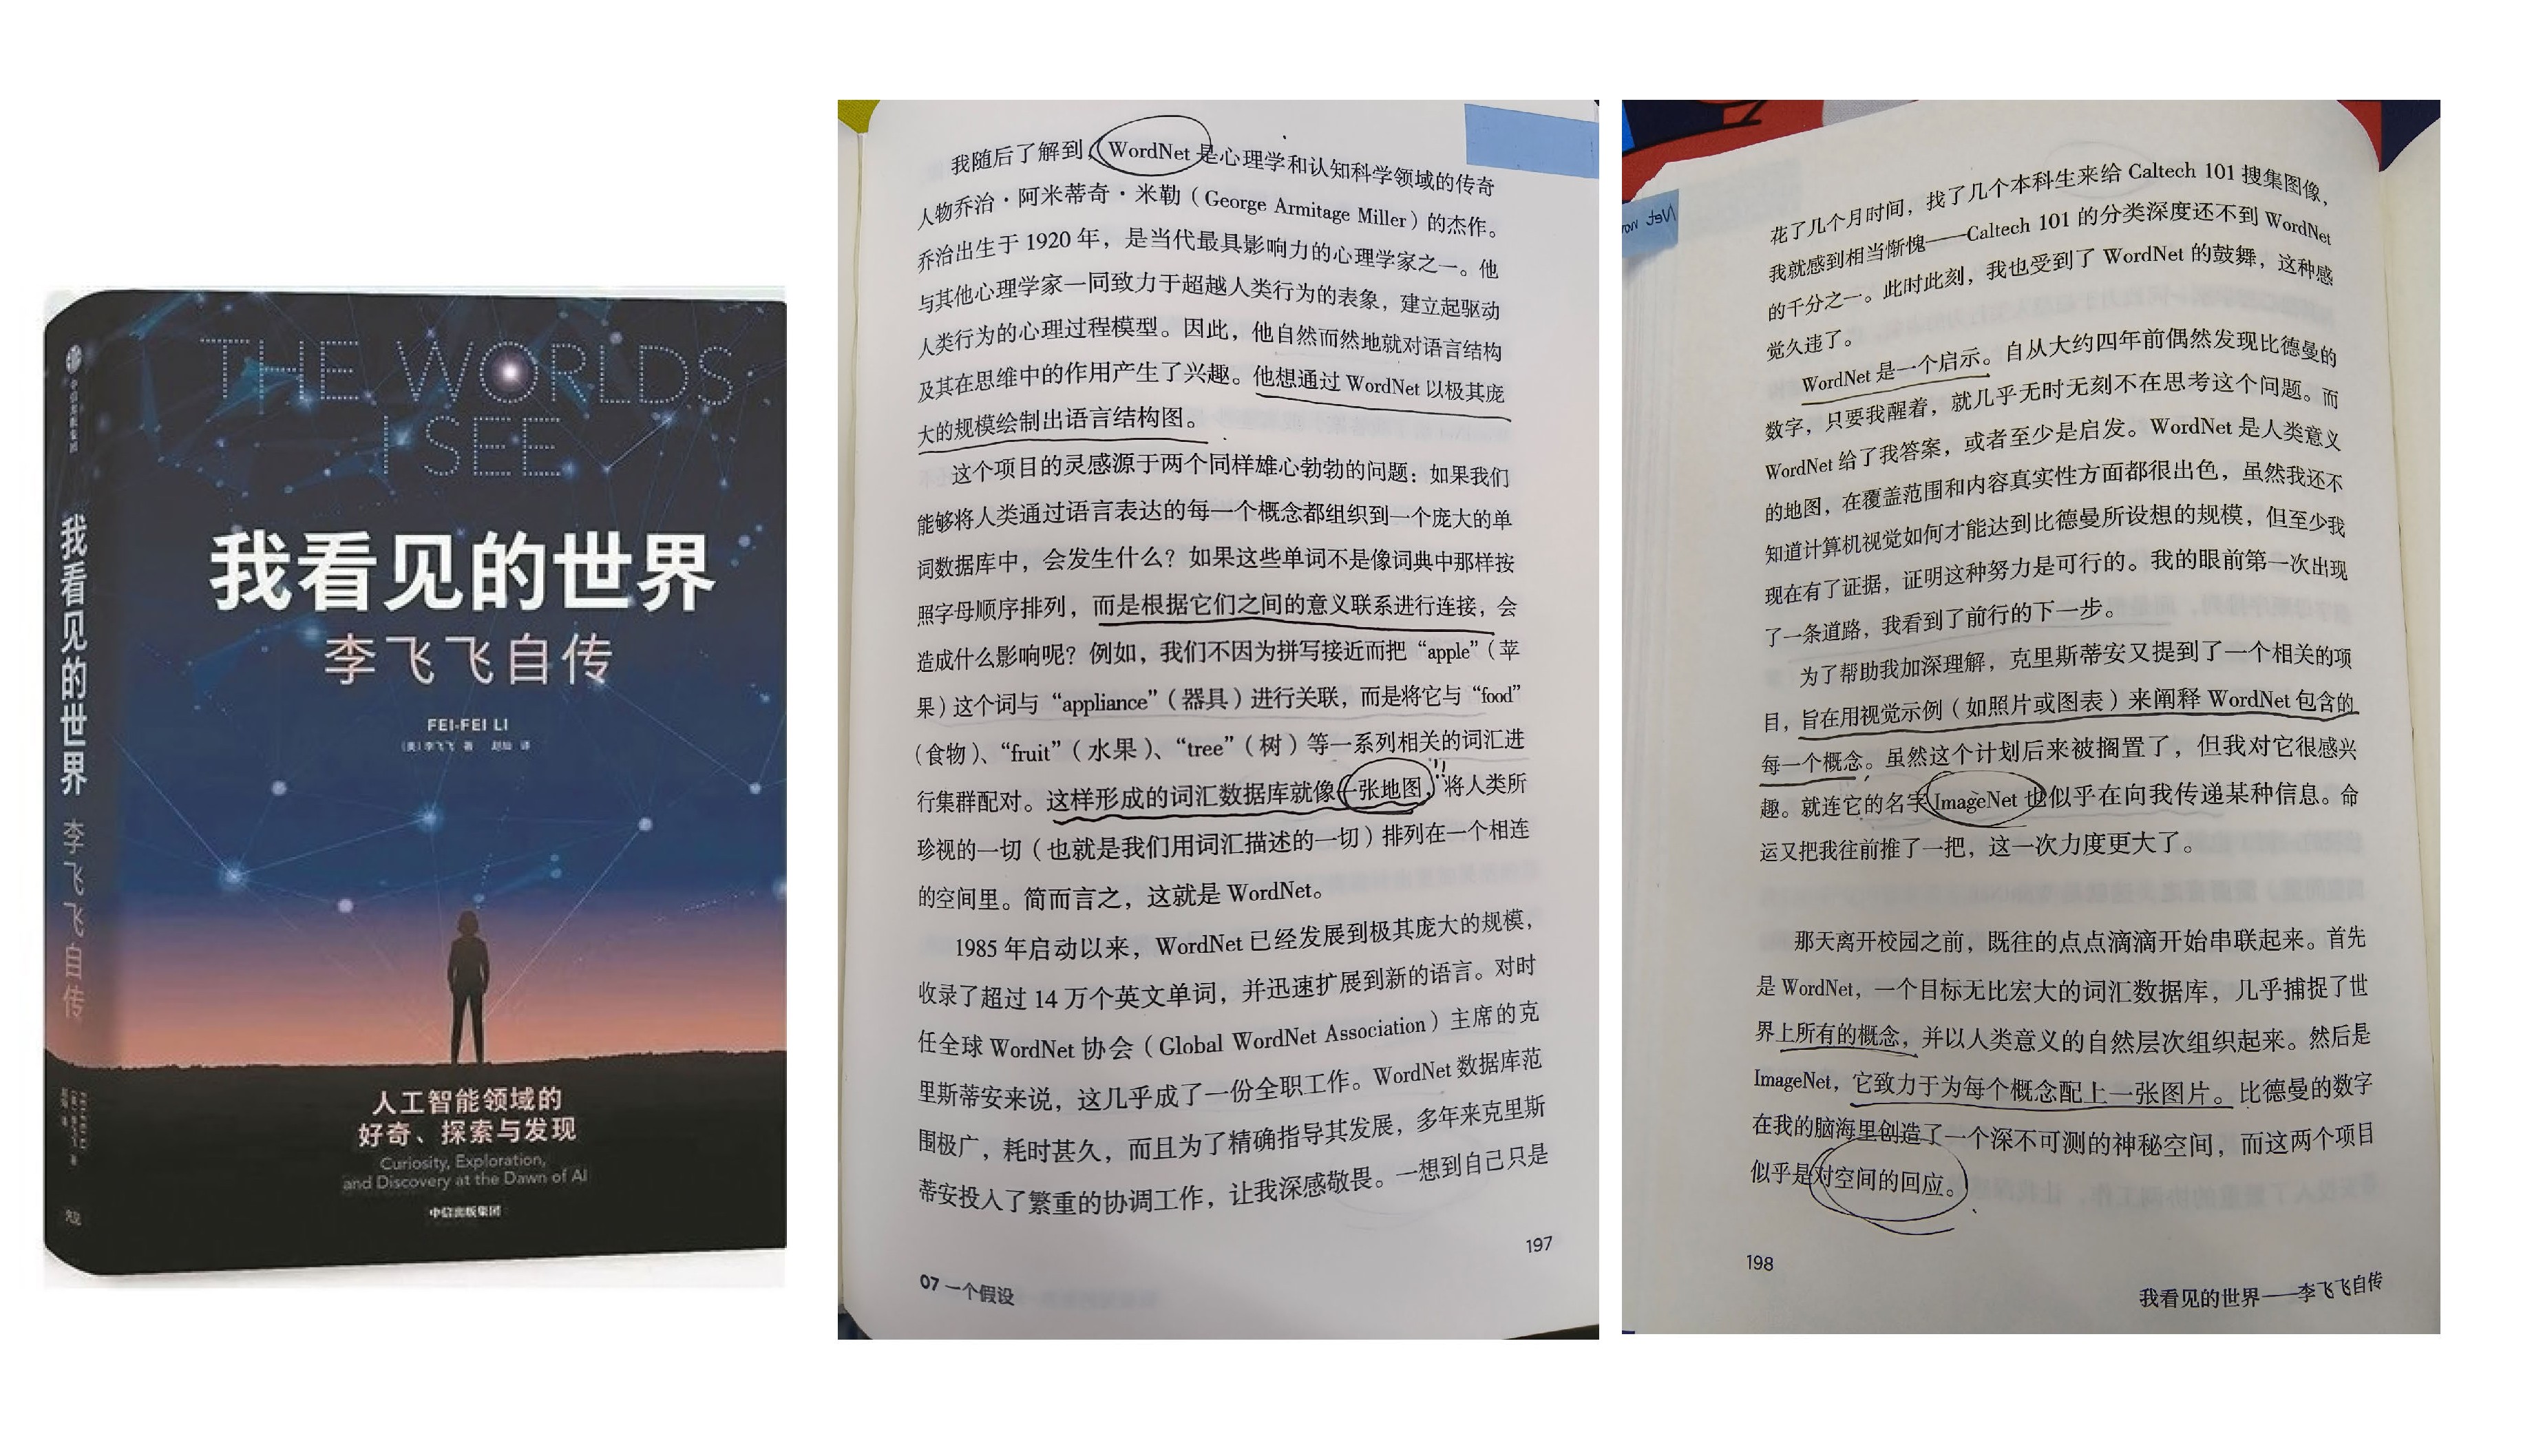
李飞飞在《AI’s Next Frontier》中也提到,真正的世界模型必然是多模态的——因为世界本身就是通过多种感官被感知和刻画的。
回顾 ImageNet 的构建,或许是一个有趣的启发。
李飞飞团队当年并未从图像本身出发,而是从 WordNet 这座语言系统的结构性出发:词语之间的上下位关系、类别层级、语义网络,被用作组织图像世界的框架。
这些语言结构为图像提供了“放置位置”,再由人工标注填入视觉内容。
ImageNet 背后体现的正是一种多模态对齐的直觉:在日常生活中,我们使用图像,却总是借助语言来命名、分类、解释。
图像并不是孤立存在的,而是以语言的概念体系为坐标,在一张更大的结构网络上占据位置。
而构建这样的数据集,本质上是在寻找一种结构,使这些异质的模态可以在其中相互落位。
在这样的例子旁观之下,多模态 Tokenization 的意义愈发清晰:它既将不同模态转成模型可读的形式,也为每种模态选定了可被对齐的表达方式。
语言的名称、图像的形状、轨迹的路径各不相同,却常常在关系模式上隐隐相合。
正因如此,不同模态才有机会在同一模型中并置,并让我们得以追问:
在这些表面形式背后,是否存在一种更普遍的组织方式,使它们能被纳入同一个坐标框架?
这个问题不必急着回答。
它只是提示我们:在 Token 与 Embedding 之上,或许还存在一层更抽象、更稳定的表达空间。
不同模态的具体表示会继续演化,但它们透露出的结构性线索似乎始终指向某种共同形态。
也正因如此,近年来也出现了另一条探索路线——弱化离散 Token 的角色,直接在连续的潜空间中刻画对象、场景与动态关系1,让对齐发生在更接近结构本身的层面。
这两种方向未必对立,更像是在同一问题上,从不同侧面摸索“结构应该长成什么样”。
最后,如果把视线轻轻移到更大的尺度,会发现:地理空间本身就是一种关系载体,通过位置、距离、邻接与流动等关系,把城市与活动织成结构清晰的网络。
空间的意义从来不是某个点本身,而是这个点在关系之网中的位置——它与谁相连、与谁接近、在哪些路径上被不断经过。
沿着这种视角往回看 Geospatial Tokenization,一个真正成熟的模型,迟早需要在内部形成一种能够同时容纳语义、时间与空间约束的关系骨架。
沿着这个方向继续追问,一个自然的问题浮现出来——
在这样一张骨架上,AI 将以怎样的方式安放它所“读取”的语言、图像以及人类行为?
作者信息与参考来源#
深圳大学城市空间信息工程系,2023级地理信息与智慧城市专业硕士研究生。
研究方向:产业园区空间配置、时空知识图谱。
深圳大学城市空间信息工程系,2022级博士研究生。
研究方向:GeoAI、Geospatial Tokenization、Human Mobility Generation、Geospatial Data Representation Learning。
本章节由吴双、黄菲负责编写,含 AI 工具辅助(ChatGPT、Gemini),文中所用插图部分来源于网络。
封面图由即梦 AI 合成,prompt 为:积木散落,漂浮,机器人俯身搭建积木,微观积木拼凑成城邦,远景,镜头从机器人身后俯拍,机器人背影,机器人盘腿而坐,机器人搭建积木,远景,上帝视角,宇宙背景;肌理纹理;积木漂浮,积木拼凑;上帝视角,机器人背影,地球上布满由积木搭建的城市,树木,城邦,高低错落,积木在空中漂浮。
参考来源#
-
《我看见的世界——李飞飞自传》
-
From Words to Worlds: Spatial Intelligence is AI’s Next Frontier
校稿:黄菲
-
近几年,不同研究路线开始尝试在更连续的潜空间中组织表征。例如,V-JEPA 模型尝试让系统直接预测潜空间中局部与整体的关系,让结构从像素和 Patch 的离散边界里抽离出来;Genie-3 将视频先压缩到一个时空潜空间,再在其中预测动态的延续;Sora-2 则把潜空间进一步量化为 Codebook Token,让模型在更高层次的块结构上学习场景的一致性与物理约束。这些方向的共同意图在于指出,表达结构这件事,并不一定要完全依赖离散的单元;连续的潜空间或许能够更好地承载模式、关系与约束。或许在未来的模型中,离散 Token 与连续潜空间会一起构成一套更完整的表达体系:前者提供离散的入口,后者承担更大的结构跨度。 ↩