Wiki Foundations3 Concepts and Frameworks of AI
3.7 扩散模型
这次要介绍的扩散模型(Diffusion Model),正是这样一位掌握了“时间逆转”魔法的数字雕刻家:它通过学习无序的扩散过程,掌握了逆流而上的路径,从而学会了如何在混沌的噪声中“雕刻”出清晰的秩序。
扩散:一种思想启发的生成任务拆分方式#
扩散模型是当前极具代表性的生成式建模框架,本章先以此为切入点,介绍生成式建模的核心机制与实现路径。关于生成式 AI 的整体概念框架、主要方法谱系及其在 GeoAI 中的意义与应用,将在第 3 章系统展开。
生成式任务#
简单来说,深度学习任务可以被粗略地分为两类:判别式(Discriminative)任务和生成式(Generative)任务。
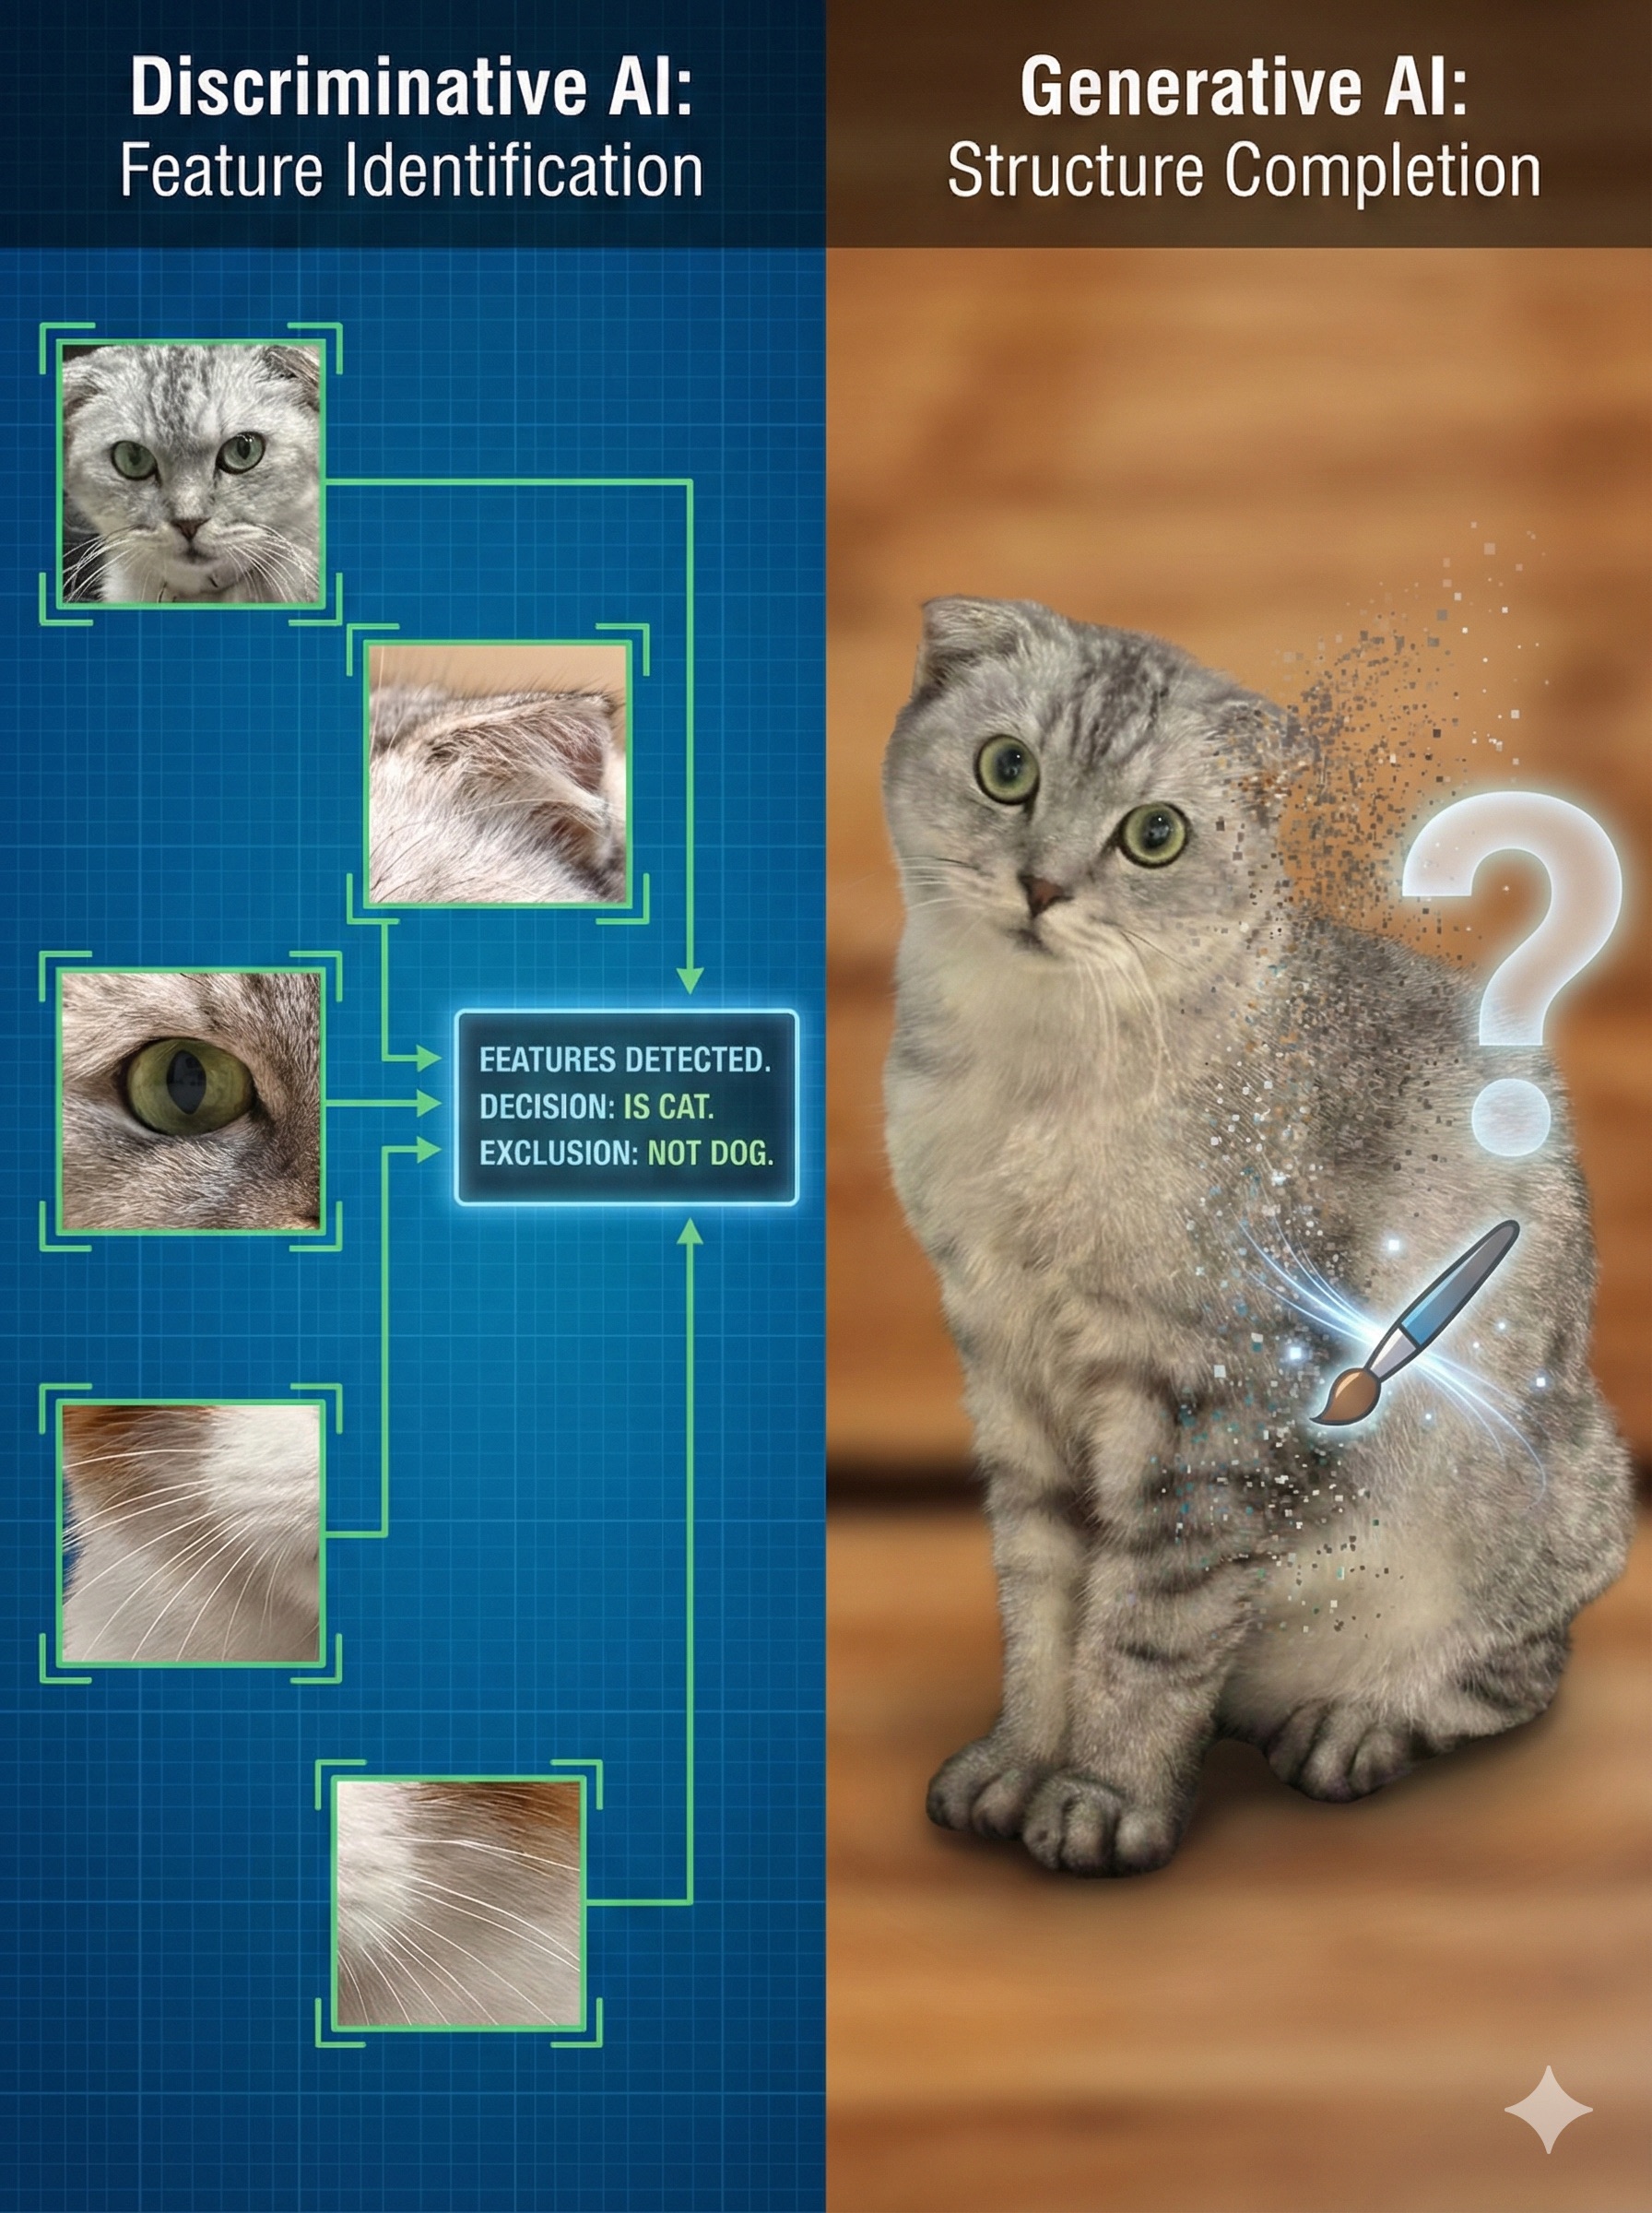
我们可以通过一个直观的例子来理解这两者的核心差异:
-
判别式任务(认出一只猫): 这类任务的目标是“区分”。模型在处理时往往可以走“捷径”。它只需要学会识别猫的几个关键特征,比如特有的瞳孔形状、胡须分布或耳朵轮廓。只要模型能从图片中找到这些足以区别于狗、老虎或汽车的决定性证据,就足以自信地宣布“这是猫”。模型可以选择性地聚焦于最具区分度的局部特征,而无需构建一个关于“猫”的完备内在模型。
-
生成式任务(画出一只猫): 这类任务的目标是“创造”。在这里,模型不能走捷径。它不仅要“知道”猫有毛发、五官和特定动作,更要拥有一种全局的、内在的深刻理解。它必须掌握这些特征之间的联合概率分布:胡须必须长在嘴边,耳朵必须在头顶,毛发的纹理需要和身体的姿态相匹配。任何一个细节的缺失或不协调,都会让生成的图像显得虚假。
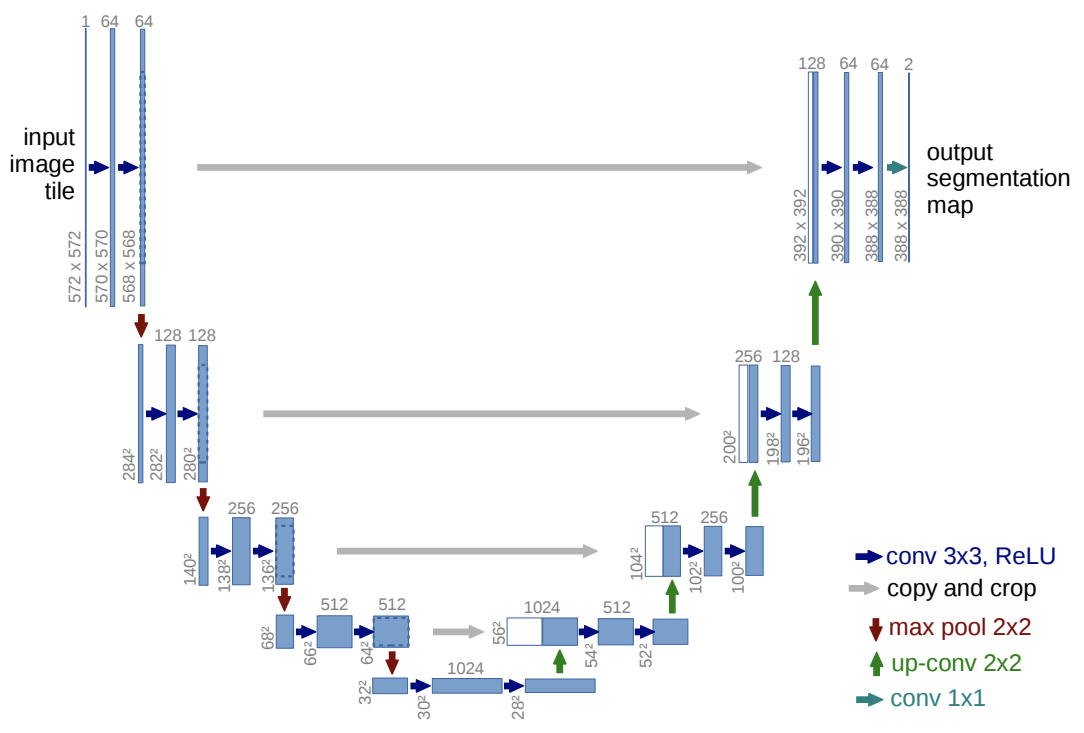
与判别式模型(如分类网络)通常利用池化层逐步压缩信息、丢弃冗余不同,生成式模型通常需要输出与真实数据结构一致的预测,图像任务尤甚(例如,输入是噪声,输出必须是一张完整的、同尺寸的图片)。
为了实现这一点,网络架构通常需要包含“上采样”或“反卷积”等操作来恢复空间细节。
这种需求使得 U-Net 脱颖而出,并成为了早期扩散模型最常用的骨架。
生成式任务与判别式任务的差异决定了,它的研究核心在于探索如何更有效地学习和表达数据各维度之间复杂的联合概率分布。
在图像领域早期,为了解决“如何画好一只猫”这个问题,研究者们提出了两种主流的深度生成模型做法:
1. 生成对抗网络(Generative Adversarial Network, GAN)
此方法的思想在于,它将学习联合概率分布的“距离”转化为一个可学习的判别器。
一个普通的分类模型仅学习数据点间的边界,而 GAN 的判别器则学习区分真实数据分布与生成数据分布的边界。
生成器从随机噪声中创造样本,其目标是生成的样本分布能成功“欺骗”判别器。
如果生成器未能捕捉到真实数据联合概率分布的某些复杂特征,这种“结构性差异”就会被敏锐的判别器发现。
因此,这种对抗博弈压力迫使生成器必须学习完整的真实数据分布,以创造出难以分辨真伪的样本。
2. 变分自编码器(Variational Autoencoder, VAE)
此方法的思想则在于构建一个信息的“瓶颈”,并强迫模型通过这个瓶颈来重构自身。
一个普通的分类模型在处理数据时会主动丢弃与任务无关的信息,而 VAE 的编码器则必须将输入样本的所有关键信息压缩到一个低维的概率性隐空间中。
因为解码器随后需要仅凭这个压缩过的信息,来完整地重构出原始样本。
这个“先压缩再重构”的压力,迫使模型在隐空间里学习到了数据最本质的结构和变化规律——这正是对数据联合概率分布的一种紧凑而有效的表达。
这两种方法各有千秋,共同推动了生成式 AI 的早期繁荣。然而,面对生成高质量数据的挑战,扩散模型却有着完全不同的看法。
扩散作为简化生成任务的思想#
2015 年,Sohl-Dickstein 等人发表的《Deep Unsupervised Learning using Nonequilibrium Thermodynamics》(也被称为 DPM)被公认为扩散模型的开山之作。
它指出,生成式模型长期存在一种根本性权衡:
- 灵活性(Flexibility): 模型需要足够强大,才能捕捉真实世界中如图像等复杂数据的丰富结构。
- 易处理性(Tractability): 模型必须在计算上可行,即能够轻松地进行训练、采样和评估其概率。
历史上,满足一个目标通常意味着牺牲另一个。
简单的模型(如高斯分布)易于处理,但无法描述复杂数据。而灵活的模型,其评估、训练和采样通常需要依赖非常昂贵的蒙特卡洛过程。
该论文的最终目标就是开发一种能同时实现这两个看似冲突的目标的方法。
具体而言,想要打破这样的权衡,DPM 把任务拆分为多个同质化步骤组成的细分任务链,从而做到单步简单(易处理),而步骤组合效果强大多样(灵活性)。
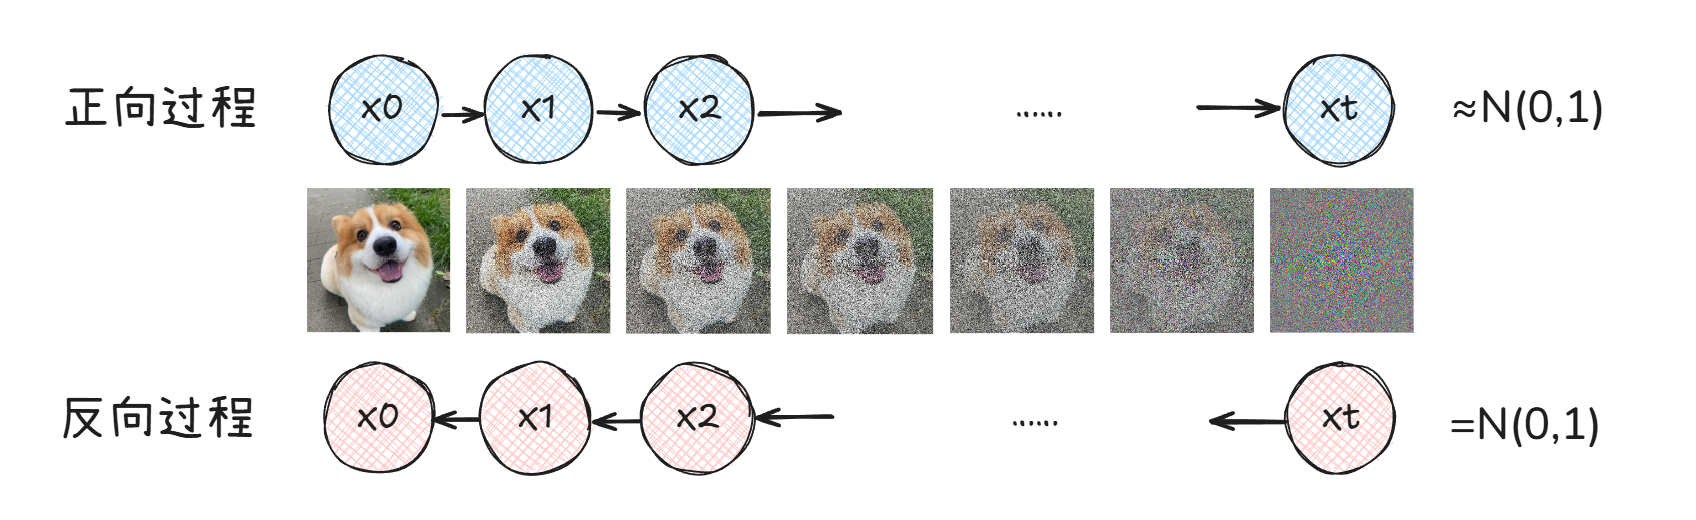
最终这个任务链受热力学启发,被确定为逐步添加和去除高斯噪声的过程。
从拆分任务到将拆分方法确定为添加和去除高斯噪声过程的设计,受到三个关键概念的启发:
-
朗之万动力学(Langevin Dynamics): 物理学原理告诉我们,如果有一个将数据结构逐渐破坏为噪声的扩散过程,那么在数学上必然存在一个逆向的恢复过程。这意味着我们不必费尽心机去设计如何一步生成复杂数据,只要我们能学会“如何逆转每一步的噪声”,就能从高斯噪声中还原出任意数据分布,这样,所有问题都被归结为“数据分布 ←→ 高斯噪声”这一条路径上的问题。
-
柯尔莫哥洛夫前向与后向方程(Kolmogorov Equations): 给出了至关重要的数学保证——前向加噪过程的时间逆转,其数学形式与前向过程相同。这极大地降低了模型的复杂度,是“易处理性”的关键。
-
Jarzynski 等式 / 退火重要性采样(AIS): 提供了一套方法论,让我们能用完全已知的前向过程作为“探针”或“路标”,来测量和评估我们想要学习的反向过程。具体而言,是用前向过程的路径来精确估计模型对真实数据的似然性,解决了灵活模型“难评估”的问题。
然而,纯粹的数学或物理理论无法直接被神经网络所用,我们必须将它“翻译”为深度学习的语言。
具体地说,需要为神经网络确定一个明确的、可学习的任务。这包括定义模型的输入、输出形式,以及至关重要的——模型的预测目标。
这个预测目标需要符合梯度优化所需的良好数学性质,否则训练过程会变得不稳定,难以收敛。
在一个数学关系式中,根据神经网络的训练特性(如对输入输出范围的偏好、数值稳定性等),有策略地选择让神经网络直接预测哪个变量,这一过程被称为重参数化(Reparameterization)。
举个例子,给定物体的起点,通过预测其未来的坐标、速度,或是加速度(选择其一),我们都可以刻画其运动轨迹。
然而,在不同条件下,这些物理量的数值范围和分布特性迥异,并非都适合作为神经网络的预测目标。
重参数化正是通过选择最合适的预测目标,来让任务更好地被神经网络学习。
在扩散模型中,一个关键的重参数化选择题是:给定带噪图像 \mathbf{x}_t,模型是应该直接预测去噪后的图像 \mathbf{x}_0,还是应该预测添加到 \mathbf{x}_0 上才得到 \mathbf{x}_t 的噪声 \mathbf{\epsilon}?
选择不同的目标,会直接影响优化过程的稳定性和最终效果。
事实证明,一个好的重参数化策略,往往能极大地简化优化目标,下面我们结合 DPM 和 DDPM,直观地展示这个过程。
从数学到直观的预测目标#
为了直观地展示这一“翻译”和“重参数化”的过程,我们简要地回顾一下扩散模型优化目标的演进。
最初,我们希望最大化的理论目标是真实数据的对数似然(Log Likelihood)。
在 DPM 的框架中,这个目标的形式非常复杂,因为它需要考虑所有可能的加噪路径,写出来令人望而生畏:
这个公式的核心难点在于对数函数内部包含了一个高维积分,直接优化它在计算上是不可行的。
为了解决这个问题,研究者们采用了一种在变分推断中常用的技巧:利用琴生不等式(Jensen’s Inequality),我们不再直接优化 L 本身,而是优化它的一个变分下界(Variational Lower Bound, VLB),也常被称为证据下界(Evidence Lower Bound, ELBO)。
这个下界在数学上更容易处理,其需要最小化的负形式可以被整理为三个有明确物理意义的部分:
这个形式虽然比最初的积分式清晰,但它依然复杂,尤其是去噪匹配项中的 KL 散度,需要在两个高斯分布之间进行计算。
而 DDPM 的贡献,正是通过一系列巧妙的设定和重参数化,将这个依然复杂的 ELBO,最终简化为了深度学习中最常见的形式之一。
关键步骤包括:
- 重参数化预测目标: 模型不再预测去噪后的图像均值 \mu_\theta,而是直接预测被添加的噪声 \epsilon_\theta。
- 固定方差: 将逆向过程的方差 \Sigma_\theta 设定为与前向过程相关的、不可学习的常量。
- 统一损失项: 将 t=1 时的特殊“重建项”也视为一个普通的“去噪项”来处理,统一了所有时间步的优化形式。
通过上述操作,并舍弃一些对最终结果影响甚微的加权项,DDPM 证明了最小化 ELBO 中的去噪匹配项,最终在形式上等价于一个极其简单的均方误差(MSE)损失:
其中,\mathbf{x}_t 是由真实图像 \mathbf{x}_0 和真实噪声 \mathbf{\epsilon} 构成的带噪图像。
或者简单地理解为:
这个过程堪称精彩:一个源自非平衡热力学的、形式复杂的多项 KL 散度目标,经过一系列有坚实理论依据的简化,最终变成了一个简单的、让神经网络预测的噪声与真实噪声尽可能接近的 MSE 任务。
正是这一简洁而有效的训练目标,使得 DDPM 能够在多个图像生成基准上取得高质量的样本,其视觉保真度在当时足以媲美主流的生成模型。
延伸思考:预测噪声是必须的吗?
值得注意的是,学术界对“预测目标”的探索从未停止。何恺明团队在2026年的最新研究《Back to Basics: Let Denoising Generative Models Denoise》中指出,尽管主流模型倾向于预测噪声,但这可能并非最优解。
基于流形假设,干净的数据其实位于低维流形上,比弥散在高维空间中的噪声更容易被神经网络捕捉。因此,让模型“回归本源”直接预测干净图像(x-prediction),或许是通向高效生成的新路径。这一点留待读者在未来的实践中细细辨别。
这种理论主导的演进在深度学习中是罕见的,后续的 DDIM、CFG、LDM 等研究也都建立在坚实的理论基础之上。
但为了文章的可读性,后续我们将更侧重于语言描述,不再深入具体的数学推导过程。
只要明白,扩散模型的演变通常都带有漂亮的数学推导,而重参数化是其中关键的方法即可。
DDPM 之后:Diffusion Model 关键的技术演进#
DDPM 的出现虽然令人振奋,证明了扩散模型在生成质量上足以挑战 GAN 的霸主地位,但初代的它更像是一个在实验室里精心呵护的精密仪器,而非一台能大规模部署的工业引擎。
在实际应用中,它面临着“三座大山”:采样速度极慢(生成一张图步骤冗长,需要几分钟)、难以精确控制(无法听懂人话生成特定内容),以及计算资源消耗巨大(在像素空间处理高分辨率图像极其昂贵)。
随后的几年里,社区爆发了惊人的创造力,针对这三个痛点进行了一系列关键的技术演进。
正是这些改进,将扩散模型从一篇漂亮的论文,推向了如今席卷全球的 AIGC 浪潮。
跳步的加速采样:DDIM#
尽管 DDPM 取得了巨大成功,但其致命弱点也显而易见:采样速度过慢。
由于其马尔可夫链的性质,生成一张图像需要完整地、串行地执行数百上千个去噪步骤,这在实际应用中构成了巨大的瓶颈。
DDIM 的贡献并非是创造了一个全新的模型,而在于通过深刻的数学洞察,揭示了标准 DDPM 训练目标背后惊人的通用性。
其核心结论颠覆了此前的认知:一个为“逐步”随机过程训练出的模型,其学到的知识和能力,足以直接应用于一个“跳步”的、甚至是完全确定的生成过程中,而无需任何重新训练。
这一结论的基石,是 DDIM 引入了一个由参数 \sigma 控制的、更广义的非马尔可夫生成过程。
这个 \sigma 决定了每一步去噪中随机性的强度。当我们将 \sigma 设为0时,整个去噪过程就变成了一条完全确定的路径。
DDIM 的通用生成公式揭示了如何实现这一过程:
这个公式的普适性,允许我们不再需要逐一遍历所有 T 个时间步。
相反,我们可以选择一个仅包含 S 个步骤的稀疏子序列(例如,从1000步中只选50步),并在这个子序列上进行“跳步”式去噪,从而极大地加速采样。
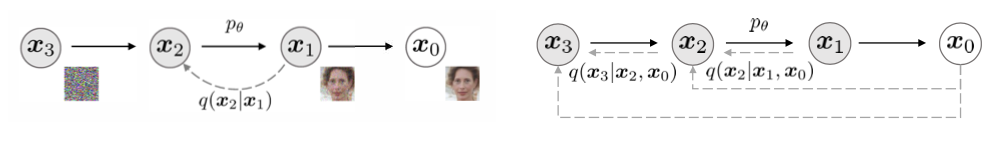
通过选择一条全新的、确定性的采样路径(即令所有 \sigma_t=0),DDIM 不仅解决了速度问题,还解锁了一系列 DDPM 不具备的宝贵新特性:
-
革命性的加速: 通过将采样步数从1000步大幅缩减至20到100步,DDIM 在保持高质量生成的前提下,实现了10到50倍的显著速度提升,使其从理论模型迈向了实用工具。
-
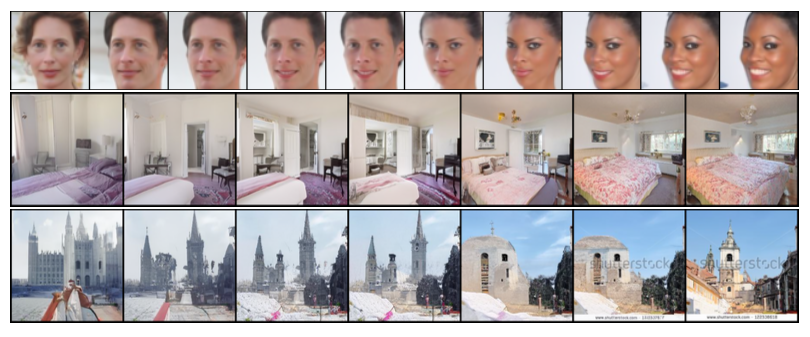
一致性与语义插值: 确定性过程意味着同一个初始噪声 x_T 将总是生成同一张最终图像 x_0。这使得初始噪声成为了一个稳定且信息丰富的“潜码”。因此,我们可以在两个不同图像对应的潜码之间进行线性插值,以生成在语义上平滑过渡的新图像。
-
可逆性: 由于确定性过程在数学上是可逆的,DDIM 允许我们将一张真实图像 \mathbf{x}_0 “编码”回它对应的初始噪声 \mathbf{x}_T,然后再从这个 \mathbf{x}_T “解码”以重建原始图像,从而以一种全新的方式实现了编码器—解码器结构。
可控的去噪过程:分类器引导与无分类器引导(CFG)#
至此,扩散模型已经获得了强大的性能,然而要迈向实用,一个核心需求是能够可控地生成指定内容。
与此同时,作为比较对象的 GANs 早已通过“截断技巧”(Truncation Trick)等方法,在“保真度”(Fidelity)与“多样性”(Diversity)的权衡上取得了领先。
通俗地说,这种权衡意味着:
-
当追求高多样性时,模型会生成各种各样、富有创造力的图像,比如要求生成“狗”,它会画出不同品种、不同姿势、甚至一些卡通风格或形态略显奇怪的狗,覆盖了“狗”这个概念的广阔边界。
-
当追求高保真度时,模型则会倾向于生成那些最“典型”、最不容易出错的图像,比如大量照片般逼真的、姿态完美的金毛犬。这些图像质量极高,但牺牲了种类的丰富性。
为了赋予扩散模型这种关键的权衡能力,研究者们首先探索了分类器引导的方案。
该方案通过训练一个能在带噪图像上工作的特化分类器,为去噪过程提供“导航”。
在采样的每一步,这个分类器都会观察当前的带噪图像 \mathbf{x}_t,并计算出一个能使图像更像目标类别的梯度。
这个梯度随后被乘以一个“引导尺度” s,并被添加到扩散模型原本的去噪预测中,从而“扭转”或“引导”生成方向。
这个过程在概念上可以表示为对去噪均值的修正:
在这里,通过调整引导尺度 s 的大小,就可以控制模型在条件生成下的保真度—多样性权衡。
更大的 s 值意味着更强的类别引导,从而提升保真度(但可能降低多样性),这使得扩散模型获得了与 GAN 可比的表现。
然而,无分类器引导(Classifier-Free Guidance, CFG)的研究者们则更进一步。
他们指出,通过外部梯度进行引导,不仅需要额外训练一个分类器使流程变得复杂,而且这种做法可能被视为一种针对评估指标的“对抗性攻击”,不一定代表模型生成能力的真实提升。
无分类器引导提出,这种引导方向完全可以由生成模型自身给出。
其核心思想是,在训练时同一个模型同时学会“有条件”和“无条件”两种预测。
在采样时,这两者预测的差值,就构成了纯粹的、源自模型内部理解的“类别方向”。
最终的引导公式极为简洁:
通过调节引导强度 w,我们同样可以控制保真度与多样性的权衡。
当 w=0 时,它是一个标准的无条件生成模型;当 w=1 时,它是一个标准的条件生成模型;当 w>1 时,它会沿着模型自己认为最能体现类别特征的方向进行强化,生成保真度更高的样本。
这种方法无需任何外部模型,更加优雅和高效,并迅速成为了后续扩散模型(包括 LDM 等)进行可控生成的标准配置。
潜空间扩散模型(LDM)#
潜空间扩散模型(Latent Diffusion Models, LDM)使用一种“分工合作”的智慧。
从前的扩散模型主要是在高维的像素空间中直接进行去噪绘制,但研究发现,基于最大似然的训练目标,会驱使模型花费不成比例的计算资源,去建模那些人眼几乎无法察觉的高频细节。
LDM 认为,如果将高度抽象、影响全局语义的创作交由核心的扩散模型负责,而将那些由概念决定的、相对确定且细节繁复的渲染工作交由一个专门的“助手”模型处理,这种分工合作有望在大幅提升效率的同时,甚至取得比单一模型更好的生成质量。
具体而言,LDM 引入了一个强大的自编码器作为“助手”。
在训练和生成时,它首先将高维的像素图像压缩到低维的、语义丰富的潜空间中。
随后,强大的扩散模型不再为像素细节所累,而是在这个经过压缩的潜空间中学习核心概念的组合与生成。
这个过程可以分为两步:
- 感知压缩(Perceptual Compression): 由自编码器的编码器(Encoder)负责,剥离图像冗余信息,得到紧凑的潜空间表示。
- 语义生成(Semantic Generation): 由扩散模型在潜空间中完成核心的去噪生成过程。
最后,自编码器的解码器(Decoder)再将生成的结果从潜空间“翻译”回高分辨率的像素图像。
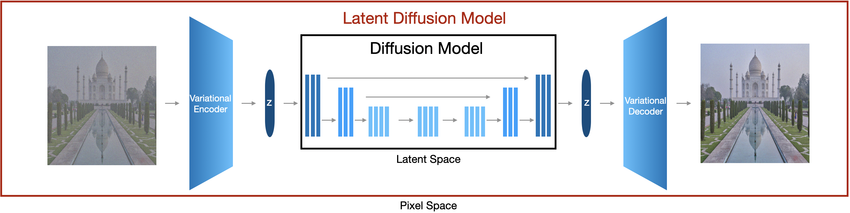
这样的做法带来了革命性的变化:它极大地降低了扩散过程所需的计算和内存资源,从而加速了训练和推理,使得在消费级硬件上进行高分辨率图像生成成为可能,这是 AIGC 技术“民主化”的关键一步。
同时,将部分工作“分包”给助手的做法并不像直观感觉那样会降低最终质量。
相反,实验发现,只要“分包”的程度合适(即找到合适的压缩率,如论文中发现的4倍到16倍的下采样因子),最终的生成效果反而会超越在像素空间中直接操作的模型。
这证明了让专家模型专注于其最擅长的任务——让扩散模型专注于语义、让自编码器专注于细节——是一种更优的策略。
DiT:当扩散模型遇上 Transformer#
之前扩散模型的主干架构几乎都是基于卷积的 U-Net。
在 ViT(Vision Transformer)于计算机视觉领域取得巨大成功后,一个自然的问题浮现出来:扩散模型是否也能摆脱对 CNN 的依赖,换上一个更通用、扩展性更强的 Transformer“引擎”?
DiT 这篇论文正是对这个问题的成功探索,它不仅证明了纯粹基于 Transformer 的扩散模型可行,而且取得了超越 U-Net 基线的 SOTA(State-of-the-Art)性能。
这一架构上的统一意义深远:它意味着扩散模型从此被接入了深度学习发展最快的主干道,未来在 Transformer 架构上的任何创新,都可以更无缝地被生成模型所借鉴。
此外,DiT 还贡献了一个重要的方法论转变。
论文指出,对于 DiT 这类模型,传统的“模型参数量”不再是衡量其能力的可靠指标,因为它忽略了 Patch 划分大小对计算量的巨大影响。
取而代之,总计算量(GFLOPs)成为了一个更精确的性能代理指标。
基于这一新标尺,DiT 清晰地揭示了缩放定律(Scaling Law)的存在:模型的总计算量与最终的生成质量(以 FID 分数衡量)之间存在着高达 -0.93 的强负相关性。
这说明只要投入更多算力,模型性能就会可预见地提升。
同时,论文还得出一个实用推论:对 DiT 来说,“天赋”比“努力”更重要——一个更强大的模型(高 GFLOPs)用较少的采样步数,其效果依然优于一个较弱的模型用极多的采样步数。
这一发现成为了后来 Sora 等视频生成模型选择 DiT 作为基座的重要理论依据。
Diffusion-LM:让语言也能扩散#
Diffusion 模型在图像领域的成功,自然地引出了一个问题:这一强大的范式能否被应用于另一热门模态——语言?
从直觉上看,这种“逐步求精”的生成过程,与人类作者反复推敲、修改文稿的过程极为相似。
然而,一个根本性的挑战在于,扩散过程是为连续空间设计的,而文字本质上是离散的符号。
我们可以对图像的颜色进行平滑插值,获得有意义的中间色;但我们无法对一个单词“加上0.1的噪声”,这个操作的语义是不明确的。
如何克服这种“连续—离散”的鸿沟,成为了将扩散模型应用于语言的首要难题。
此外,当时主流的语言生成模型(如 GPT 等自回归模型)存在其固有的局限性。
它们“从左到右”逐词生成的模式,使得模型难以进行全局规划,尤其是在需要满足复杂、细粒度约束(如特定句法结构或情感)的可控生成任务上表现不佳。
这种单向生成过程还容易导致“曝光偏差”(Exposure Bias),即训练与推理之间的差异会随着句子变长而累积,导致最终生成的文本质量下降。
Diffusion-LM 正是为了解决以上两个问题而提出的。
它应对“连续—离散”鸿沟的巧妙方案是:不在离散的文字空间中扩散,而是在连续的“概念空间”中进行。
具体而言,它首先通过词嵌入(Word Embedding)将离散的文字映射到高维、连续的向量空间中。
所有的加噪和去噪过程都在这个连续空间里完成。
当扩散过程结束,生成一个最终的连续向量后,再通过“四舍五入”的方式,找到词汇表中最接近的那个离散词汇作为输出。
当然,由于语言数据的独特性,直接套用图像领域的扩散配方并不可行。
Diffusion-LM 为此引入了几项关键的技术调整:
1. 重参数化预测目标
研究发现,在文本任务中,如果像图像任务一样预测噪声 \epsilon,最终生成的向量不够“干净”,导致“四舍五入”时错误率很高。
因此,Diffusion-LM 将预测目标重新设定为直接预测最终的、干净的词嵌入 x_0。
这为模型提供了更明确的监督信号,迫使其在每一步都思考一个“合法”的词语终点。
这再次印证了我们在前文提到的重参数化思想的重要性:在图像中,预测噪声 \epsilon 通常是更好的做法;而在文本的离散嵌入空间中,直接预测原目标 x_0 反而成了更稳定的选择。针对不同数据特性灵活调整预测目标,是扩散模型成功的关键。
2. 钳制技巧(Clamping Trick)
在生成(推理)时,模型在每一步预测出对 x_0 的估计后,会先将这个估计值“钳制”到词汇表中最接近的真实词嵌入上,再用这个“修正后”的结果进行下一步去噪。
这相当于在创作过程中不断进行校准,确保每一步都不偏离“合法”的轨道。
通过这些设计,Diffusion-LM 成功地将扩散模型的强大生成能力和全局视角引入了文本领域,为可控文本生成提供了一条全新的、非自回归的技术路径。
发展节点和应用#
风靡网络#
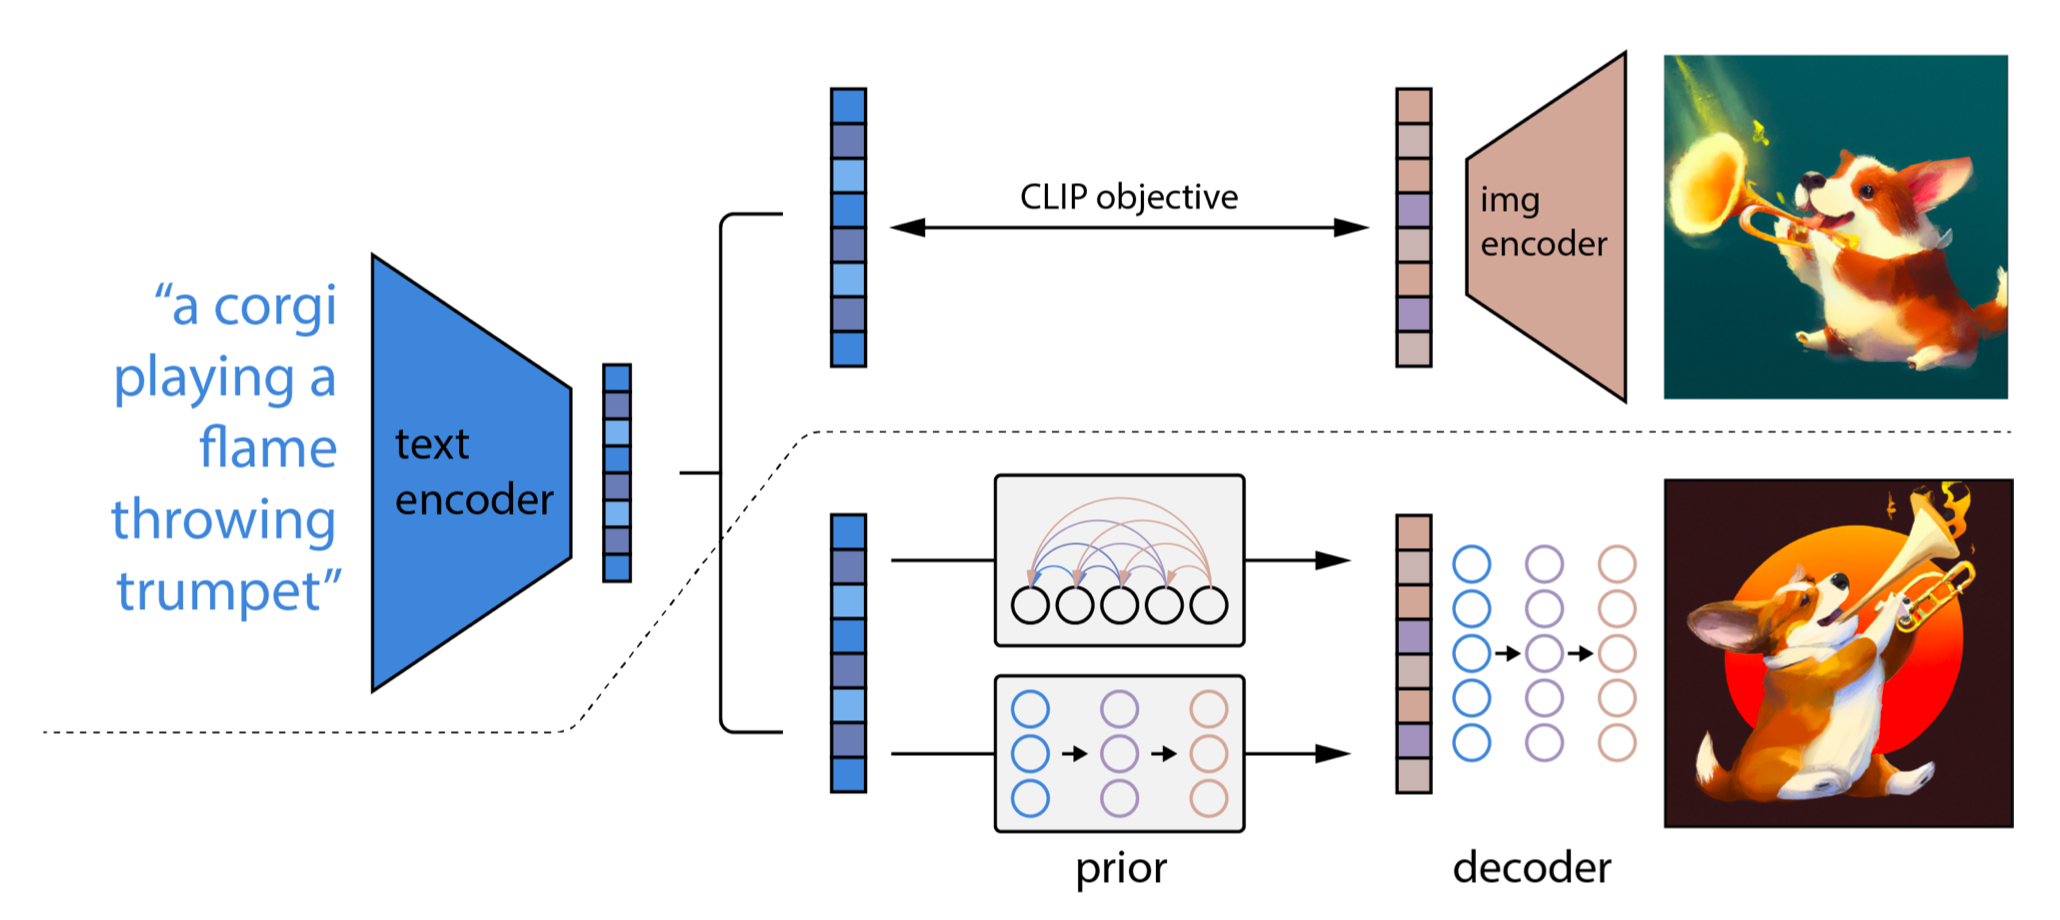
2022 年,连接文本与图像的模型 CLIP 与扩散模型相结合,使得基于文字引导的文生图扩散模型在图像生成领域彻底爆发,风靡网络。
例如 OpenAI 的 GLIDE、DALL-E、DALL-E 2,Google 的 Imagen 以及开源的 Stable Diffusion 等。
如今我们已经具备仅需一段描述性文本即可创作出视觉图像的强大能力。
持续进步#
自从扩散模型进入大规模化的阶段后,重新训练一个图像生成扩散模型的成本显著增加,不仅需要大量的数据,还消耗昂贵的计算资源。
对于个人研究者而言,这使得进入扩散模型的研究领域变得异常艰难。
然而,像开源项目 Stable Diffusion 这样的模型已经成功地掌握了丰富的图像生成知识,因此,重复进行类似的大型训练已不再必要。
由此,基于现有扩散模型进行“再学习”或微调的技术应运而生,这些技术让个人研究者能够在消费级硬件上进行定制化的图像生成模型训练成为可能。
例如,DreamBooth、LoRA 和 ControlNet 就是实现大模型“再学习”的三种不同方法。
DreamBooth:学习特定主体#
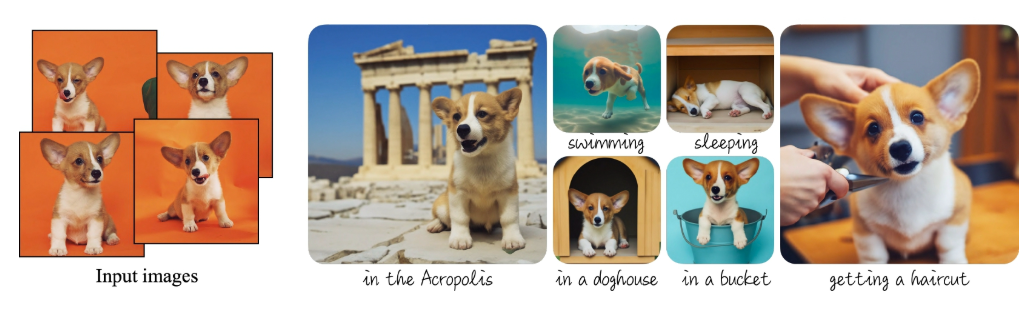
DreamBooth 允许用户通过少量样本训练将特定主体(如某个人物或物体)绑定到唯一的文本标识符上,从而可以使用文本提示来控制该主体在新图像中的表现。
LoRA:低成本模型微调#
LoRA(低秩自适应)是一种高效的微调技术。
它不调整庞大的模型原有参数,而是通过训练附加的微小参数模块来实现对模型的修改。
这使得生成的模型文件非常轻量(仅几十 MB),用户可以像“插件”一样灵活地加载不同的 LoRA 模型,在保持原模型能力的同时,快速切换画风、人物或特定概念。
ControlNet:可控空间结构#
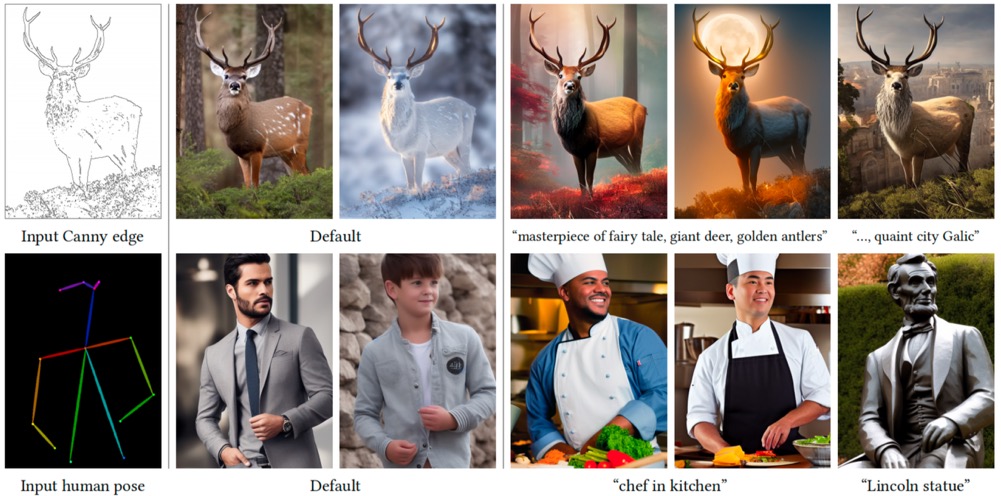
ControlNet 则专攻文本提示难以精确控制图像空间结构的痛点。
它通过引入额外的条件输入(如边缘检测图、深度图、人体骨架图等),让扩散模型能够“看懂”构图指令。
这使得用户可以精确指定物体的位置、姿态和轮廓,如同给 AI 提供了一个严格的“骨架”或“草图”,从而实现了从单纯的“盲盒式”生成向工业级精确绘图的跨越。
这些方法不仅降低了进入门槛,也大大拓展了扩散模型的应用场景和个人创作的可能性。
各领域中扩散模型的研究与应用#
扩散不仅是一种思想,更代表了一种灵活且适应性强的思维方式。
扩散模型本身也并不拘泥于某一特定的结构框架,这使得它一出现便展现出与其他领域相融合的潜力,从而催生了一系列创新且引人入胜的应用实例。
这种跨界整合的能力,正是扩散模型独特魅力与价值的体现。
1. 计算机视觉#
在实际应用中,扩散模型最为人所熟知且广泛应用的领域当属图像生成任务,前面的内容正是基于这一核心应用进行探讨和展开。
除此之外,扩散模型在计算机视觉领域还拓展出了多种应用场景,包括但不限于:
图像分割与目标检测#
图像分割和目标检测是计算机视觉中的两个关键任务,在智能驾驶和质量控制等领域非常重要。
引入扩散模型技术后,这些任务的精度得到了显著提升。
例如,Meta AI 开发的 SegDiff 模型可以生成精确的分割掩膜图,而 DiffusionDet 模型则能够直接从随机初始矩形逐步优化出准确的目标检测框。
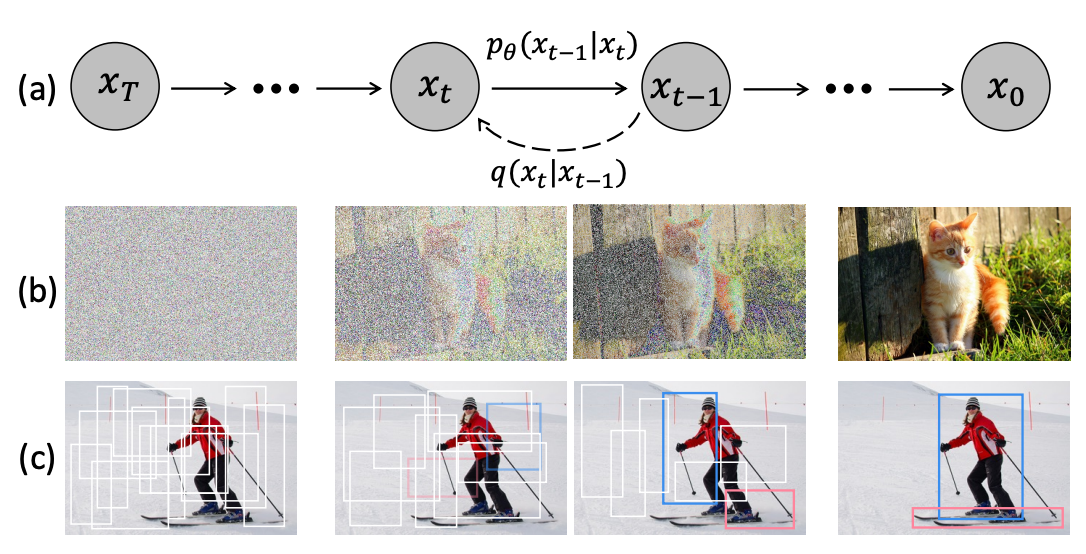
相比于传统目标检测(如 YOLO)依赖预设的锚框,DiffusionDet 等研究使用了新的范式:将目标检测视为从噪声框到物体框的生成过程。
这种方法的优势在于它不需要人为设计的先验框,且在处理遮挡物体或密集场景时,利用生成模型的联合分布特性,往往能给出比传统回归更合理的预测结果。
当然,这种“慢工出细活”的生成方式也带来了推理速度上的挑战。
如何在保持生成精度的同时满足实时监控或自动驾驶的低延迟需求,是当前该领域优化的重点方向。
图像超分辨率#
图像超分辨率技术旨在从低清图像恢复高清细节。
传统的基于均方误差(MSE)的模型往往会生成平滑但模糊的结果,因为它们倾向于预测所有可能性的平均值。
扩散模型在这里展现了更高一级的能力。
它不预测平均值,而是根据学到的分布规律,“脑补”出最符合统计规律的高频细节。
CDM(级联扩散模型)等方法通过分阶段的去噪,能够在放大图像的同时,生成发丝、皮肤纹理等逼真的高频信息。
虽然这些细节在原始低清图中并不存在,但它们符合人类的视觉认知,因此在感知质量上远超传统方法。
图像修复和图像编辑#
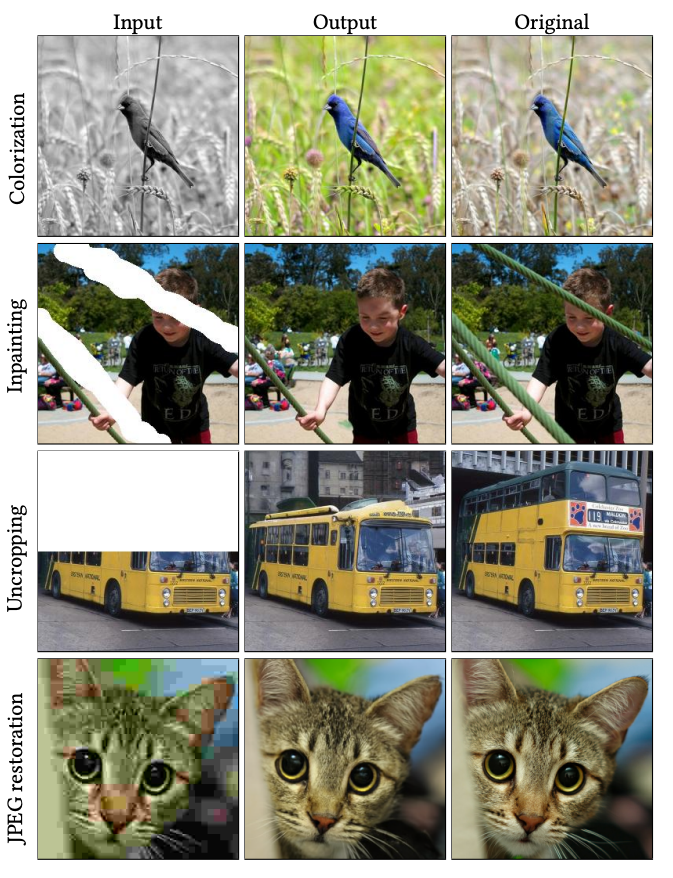
图像修复(Inpainting)本质上是一个解决不确定性的问题:当图片缺失了一块,那里原本可能是什么?
Palette 等集成化模型充分利用了扩散模型的优势。
面对缺失区域,它依据周围环境的语义,从概率分布中采样出一种清晰且合理的填充方案。
这种能力使得扩散模型成为了当前图像编辑、去水印及老照片修复领域的首选基础模型。
2. 时序数据预测:拥抱未来的不确定性#
时序数据预测的目标是根据历史观测推断未来。
然而,现实世界(如股票波动、交通流量、气象变化)充满了高度的随机性与不确定性。
传统的深度学习方法通常采用确定性的回归目标(如 MSE Loss),与图像面临的问题一样,这使得模型倾向于预测未来所有可能性的平均值。
在多峰分布场景下,“平均值”往往意味着撞向墙角的错误路径,或者对极端事件(如交通拥堵、股市崩盘)的严重低估。
扩散模型恰好可以用于将时序预测从“单点估计”升级为“概率建模”。
它不仅仅预测未来会发生什么,而是通过学习历史数据的条件概率分布,模拟未来可能发生的一系列情况。
TimeGrad 是首个将扩散模型理念应用于多元概率时序数据预测的自回归模型。
它结合 RNN 和 Diffusion,通过以下步骤实现这一目标:
- RNN 提取历史信息: 利用 RNN 处理和编码历史数据,将其映射到一个隐空间表示,作为条件输入。
- Diffusion 模拟未来分布: 在预测步,不再直接输出数值,而是让扩散模型在 RNN 提供的条件下,通过去噪过程从高斯噪声中还原出未来的数据序列。
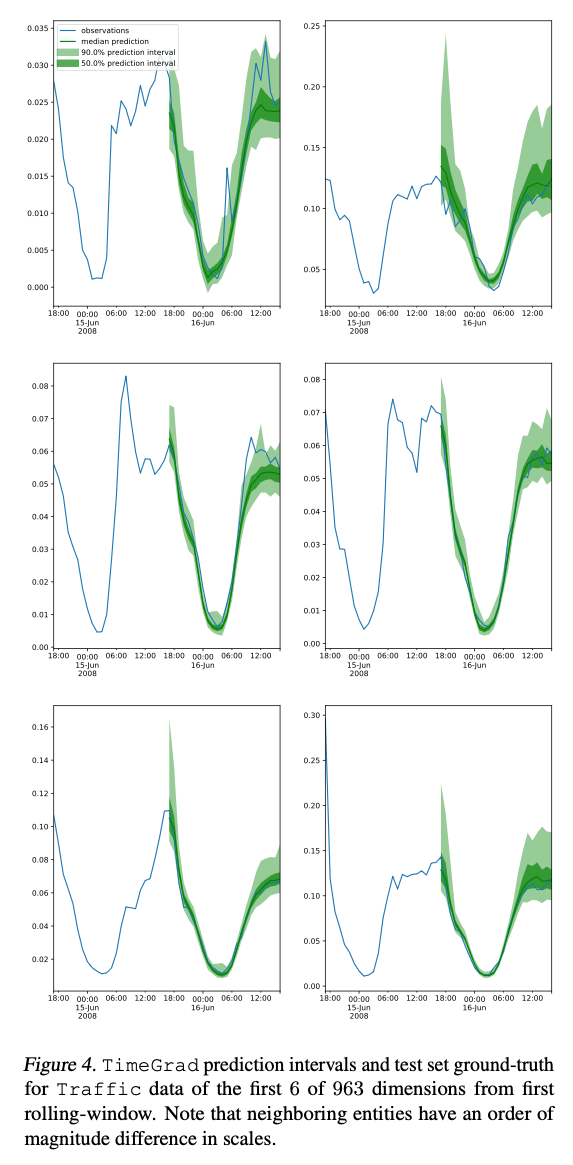
这种方法的优势在于它能捕捉数据之间复杂的相关性。
实验证明,在处理高维、多变量的复杂时序数据时,TimeGrad 生成的预测结果不仅准确,而且能给出合理的置信区间,真实反映了现实世界的随机本质。
3. 自然语言处理:非自回归的全局视角#
在自然语言处理(NLP)领域,以 GPT 为代表的自回归模型占据着统治地位。
它们像人类说话一样,通过“预测下一个词”来从左到右逐字生成文本。
虽然流畅,但这种机制缺乏全局规划能力,且难以在生成过程中施加硬性约束(比如要求句子使用特定结构)。
扩散模型则提供了一种全新的非自回归范式。
正如前文所述,通过将离散文字映射到连续的词向量空间(Diffusion-LM),扩散模型可以像生成图像一样,从一团模糊的噪声中同时“浮现”出整句话的所有单词。
这种“全局修正、逐步求精”的特性,赋予了它在特定任务上超越 GPT 的独特优势:
-
高度可控的文本生成: 由于模型在每一步都能“看到”整句话的草稿,我们可以轻松地施加复杂的句法或语义约束(如情感控制、关键词包含),强制模型向着目标方向去噪。这在诗歌创作、公文写作等强约束场景下尤为有效。
-
文本填空与编辑(Infilling): 自回归模型只能续写,难以修改中间内容。而扩散模型可以像图像修复一样,固定句子的首尾,自动补全或润色中间的词语,使其在上下文逻辑上连贯通顺。这种双向感知的方式,也让扩散模型与 BERT 等掩码语言模型产生了奇妙的理论联系。
-
多样性增强: 在对话系统或创意写作中,扩散模型能生成比自回归模型更具多样性的回复,避免了文本生成中常见的“复读机”问题。
尽管在长文本生成的连贯性上,目前的扩散模型仍难以撼动 GPT 式自回归模型的霸主地位,但它为 NLP 提供了一种在“生成速度”与“可控性”之间权衡的新思路,正成为该领域极具潜力的研究分支。
4. 视频生成#
将扩散模型的思想从静态图像拓展到动态视频,是生成式 AI 通往“世界模拟器”的关键一步。
Sora 作为这一方向的里程碑,证明了扩散模型不仅能生成像素,还能理解像素背后的物理规律。
视频生成的难点在于时间的一致性:物体在运动过程中必须保持结构稳定,且符合重力、碰撞等物理常识。
Sora 的核心架构延续了前文提到的 DiT 思想。
它将视频看作一个三维的数据块(时间 × 宽 × 高),并将其切分为无数个“时空块”。
通过在这些时空块上进行扩散去噪,模型不再是逐帧地“画”图,而是整体地“构想”一个动态场景。
这种全局视野使得 Sora 能够处理不同时长、分辨率和宽高比的视频,并涌现出对三维空间连贯性和因果关系的深刻理解。
这标志着视频生成从简单的“画面拼接”进化到了真正的“物理世界模拟”阶段。
5. AI 基础科学#
AI 基础科学(AI for Science)致力于利用人工智能解决生物、化学、材料学中的硬核难题。
而在这些领域,扩散模型正在引发一场范式革命。
传统的科学计算往往面临“搜索空间过大”的难题。
例如,想要设计一个能与特定病毒结合的蛋白质,可能的原子排列组合是天文数字。
传统的搜索算法容易陷入局部最优解,而扩散模型提供了一种“逆向去噪优化”的新思路:它将寻找稳定分子结构的过程,建模为从随机噪声顺着能量梯度“滑落”到稳定状态的过程。
-
AlphaFold 3: DeepMind 在2024年推出的这一模型,抛弃了前代纯几何的构建方式,转而使用扩散模型直接预测蛋白质、DNA、RNA 等生物分子的所有原子坐标。它将生物分子的折叠视为一个去噪过程,从而能够更精准地预测复杂的生物分子相互作用。
-
材料与药物设计: 例如 CDVAE 和 SMCDiff 等模型,利用扩散模型在潜在空间中的游走能力,能够根据特定的物理化学属性(如导电性、结合力)反向定制新材料的晶体结构或药物分子的支架。
AI 基础科学(AI for Science)是人工智能领域中一个前景广阔的分支,它正发展成为一项造福全人类的技术。
例如,2021年 DeepMind 推出的 AlphaFold 2 能够预测人类已知98.5%的蛋白质结构,而2022年,DeepMind 再次利用强化学习成功控制核聚变反应堆内的高温等离子体。
扩散模型以其在生成任务中的卓越表现,在 AI 基础科学研究中也扮演着关键角色,尤其是在生成和预测类的研究方面。
例如:
- SMCDiff: 开发了一种专门用于生成多样化支架蛋白质的扩散模型,该模型可以根据给定的模体结构进行创新性设计。
- CDVAE: 提出了一种名为“扩散晶体变分自编码器”的模型,专注于生成和优化具有固定周期性原子结构的材料,为新材料的设计提供了新的途径。
- AlphaFold 3: DeepMind 推出的这一模型使用扩散模型来生成 3D 原子坐标并预测蛋白质、DNA 和 RNA 等生物分子结构。
在这种视角下,扩散模型不再仅仅是一个“生成器”,而是一个高效的科学发现引擎,帮助科学家在微观世界的迷宫中快速找到通往真理的路径。
6. GeoAI#
地理空间人工智能(GeoAI)面临的核心难题在于如何从有限且异质的观测中准确刻画时空过程本身。
不同于以静态结构为主的视觉数据,地理空间数据记录的是在空间约束下持续演化的复杂系统,其行为由物理机制、空间结构与人类活动共同驱动,并表现出显著的多尺度性与非确定性。
因此,将 Diffusion 应用于时空数据时,直接照搬图像领域的经验往往显得“水土不服”。
因为在这里,数据不再是自由的像素,而是受物理世界严格法则支配的实体。
比如同样是空间约束,图像生成关注的是纹理的连贯,而人类移动轨迹的生成必须严格受限于城市路网的拓扑结构(想象一条穿房而过的汽车轨迹)。
比如同样是时间演变,视频生成只需保证画面流畅,但云图的推演则必须服从流体动力的守恒定律。
这意味着,我们必须针对这些特有的问题,对扩散过程进行定制化的改造。
下面的内容中,我们聚焦交通与遥感领域具体面临的问题,展示扩散模型的独特优势。
交通#
扩散模型在人类移动和交通流量建模方面发挥了其概率建模的特长,这与城市交通本身高度随机的本质非常契合。
DiffTraj:人类移动轨迹生成
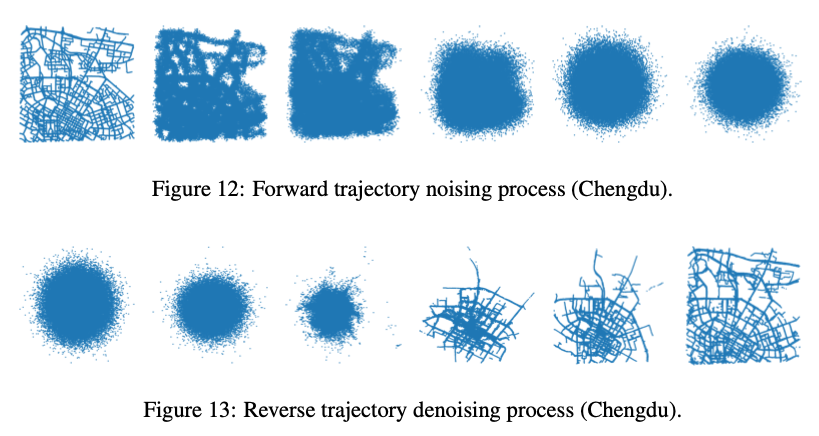
DiffTraj 落脚于人类移动轨迹的生成,是数据隐私保护和数据增强的理想工具。
它能够根据给定的条件(如起始与终点区域、出发时间),生成既保留了真实群体统计特征、又完全去除了敏感个人信息的合成轨迹。
DiffUFlow:城市流量超分辨率
面对城市传感器往往存在的噪声和粗粒度问题,DiffUFlow 利用扩散模型的去噪本能,通过引入 Transformer 提取时空特征,实现了从粗糙、含噪的流量观测中推断出细粒度、可靠的城市流量分布(即流量的“超分辨率”)。
SpecSTG:概率时空交通预测
SpecSTG 则进一步引入了谱扩散(Spectral Diffusion)的思想,通过在傅里叶域中进行扩散生成,不仅大幅提升了处理大规模时空图的计算效率(速度提升3倍以上),还能更精准地量化未来交通流的不确定性,为实时交通管理提供了可信的概率参考。
遥感领域#
遥感数据分析长期受困于两个物理瓶颈:一是成像质量的退化(受云雾遮挡、传感器分辨率限制),二是环境因素的干扰(光照、季节变化影响解译)。
扩散模型以其强大的生成先验和特征表达能力,为解决这些“反演难题”提供了新的范式。
1. 图像复原与增强:从“平滑逼近”到“纹理生成”
在处理低质量遥感图像时,传统的回归模型(基于 MSE Loss)往往倾向于输出模糊的平均结果。
EDiffSR 针对遥感图像的超分辨率任务,利用扩散模型强大的高频信息生成能力,打破了传统方法的平滑效应。
它基于概率分布“幻化”出符合物理逻辑的微小纹理(如房屋边缘、植被细节),在视觉保真度上实现了质的飞跃。
同理,针对光学遥感中常见的云雾遮挡问题,DiffCR 将“去云”建模为条件引导下的去噪过程。
模型通过学习无云地表的先验分布,能够穿透厚重的云层,“脑补”出下方被遮挡的真实地貌,其恢复的一致性和清晰度远超传统插值手段。
2. 变化检测:鲁棒的语义特征提取器
在监测地表变迁时,最大的挑战在于区分“真变化”(如建筑物新增)与“伪变化”(如季节更替、光照差异)。
DDPM-CD 开创性地挖掘了扩散模型的另一面——不仅仅是生成器,更是卓越的特征提取器。
研究发现,经过大规模无监督预训练的扩散模型,其内部特征对地物的语义结构高度敏感,而对光照、色彩等环境噪声具有天然的鲁棒性。
利用这种特征进行变化检测,能够有效过滤掉环境干扰,精准锁定具有实际意义的地理要素变更。
尽管扩散模型能够出色地生成外观合理、统计相似的样本,但这类结果并不必然意味着其对地理过程具有可操作的解释或支撑能力。
对于受强空间约束与物理机制支配的系统而言,生成模型更容易复现“结果的形态”,却未必真正刻画了过程的合理性。
一旦生成结果被直接用于分析、推演或决策,其潜在偏差可能被放大而非抵消。
因此,如何界定生成结果在地理问题中的适用边界,仍是生成式 GeoAI 模型以及时空合成数据走向实用化之前必须正视的问题。
结语:从理解到创造#
在这一章里,我们追溯了扩散模型的演进足迹。
从 Sohl-Dickstein 等人(2015)那篇极具前瞻性的 DPM 奠基之作出发,我们看到了研究者如何巧妙地利用“非平衡热力学”的思想,将复杂得难以逾越的生成任务,拆解为一系列简单、可控的去噪步骤。
这种用“时间换空间”、以多步迭代平衡灵活性与易处理性的智慧,最终造就了如今强大的扩散模型。
我们好像还没有完全回答那个问题:“生成”真的这么重要吗?
物理学家理查德·费曼曾说:
“我不能创造的,我就不理解。”
What I cannot create, I do not understand.
这可能就是“生成”的核心价值所在。
判别式模型(如分类)往往是在做信息的“减法”,丢弃背景、纹理等冗余,只保留用于决策的特征;而生成式模型是在尝试做信息的“加法”,它强迫模型去理解数据背后错综复杂的联合概率分布,去重构每一个细节。
只有当一个模型能够从零开始、毫无破绽地“生成”出一张猫的照片或者一段车流的轨迹时,我们才能确信:它真正理解了那个对象背后的物理规律与运行逻辑。
当然,扩散模型仅仅是“生成式 AI”浪潮中的一朵高耸的浪花,而非海洋的全貌。
在本章中,我们聚焦于扩散模型这一具体架构的技术原理,但关于生成式模型如何从数学本质上区别于判别式模型?它们在历史长河中是如何一步步演进的?以及当这种通过“创造”来验证“理解”的强大能力,与复杂的地球科学和地理空间数据相遇时,会激荡出怎样的火花?
在本书的下一部分生成式 AI 与 GeoAI中,我们将跳出单一的模型视角,去探索当人工智能从“观察世界的工具”进化为“模拟世界的引擎”时,将如何重塑我们认知地理空间的方式。
作者信息与参考来源#
本科毕业于山东大学,现为深圳大学城市空间信息工程系,2023级人工智能专业硕士研究生。
研究方向:GeoAI、Geospatial Data Representation Learning。
深圳大学城市空间信息工程系,2022级人工智能专业硕士研究生(已毕业)。
研究方向:LLM-Agent、轨迹合成。
本章节由李国隆、李旭川负责编写,含 AI 工具辅助(Gemini 2.5 Pro),文中所用插图部分来源于网络。
封面图由 Gemini Nano Banana Pro 合成,prompt 为:
Conceptual digital art, visual representation of diffusion model, a cloud of random pixel noise transforming into a hyper-realistic landscape, particles aligning into structure, evolution from static grain to a vivid image, golden ratio composition, volumetric lighting, dreamlike, sci-fi aesthetic, octane render, unreal engine 5, 8k –ar 16:9
参考来源#
-
U-Net — Ronneberger, O., Fischer, P., & Brox, T. (2015, October). U-net: Convolutional networks for biomedical image segmentation. In International Conference on Medical Image Computing and Computer-Assisted Intervention (pp. 234–241). Springer.
-
GAN — Goodfellow, I., Pouget-Abadie, J., Mirza, M., Xu, B., Warde-Farley, D., Ozair, S., … & Bengio, Y. (2020). Generative adversarial networks. Communications of the ACM, 63(11), 139–144.
-
VAE — Kingma, D. P., & Welling, M. (2013). Auto-encoding variational Bayes. arXiv preprint arXiv:1312.6114.
-
DPM — Sohl-Dickstein, J., Weiss, E., Maheswaranathan, N., & Ganguli, S. (2015, June). Deep unsupervised learning using nonequilibrium thermodynamics. In International Conference on Machine Learning (pp. 2256–2265). PMLR.
-
DDPM — Ho, J., Jain, A., & Abbeel, P. (2020). Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems, 33, 6840–6851.
-
Li, T., & He, K. (2025). Back to basics: Let denoising generative models denoise. arXiv preprint arXiv:2511.13720.
-
DDIM — Song, J., Meng, C., & Ermon, S. (2020). Denoising diffusion implicit models. arXiv preprint arXiv:2010.02502.
-
Dhariwal, P., & Nichol, A. (2021). Diffusion models beat GANs on image synthesis. Advances in Neural Information Processing Systems, 34, 8780–8794.
-
CFG — Ho, J., & Salimans, T. (2022). Classifier-free diffusion guidance. arXiv preprint arXiv:2207.12598.
-
LDM — Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-resolution image synthesis with latent diffusion models. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 10684–10695).
-
DiT — Peebles, W., & Xie, S. (2023). Scalable diffusion models with transformers. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 4195–4205).
-
Diffusion-LM — Li, X., Thickstun, J., Gulrajani, I., Liang, P. S., & Hashimoto, T. B. (2022). Diffusion-LM improves controllable text generation. Advances in Neural Information Processing Systems, 35, 4328–4343.
-
unCLIP — Ramesh, A., Dhariwal, P., Nichol, A., Chu, C., & Chen, M. (2022). Hierarchical text-conditional image generation with CLIP latents. arXiv preprint arXiv:2204.06125, 1(2), 3.
-
LoRA — Hu, E. J., Shen, Y., Wallis, P., Allen-Zhu, Z., Li, Y., Wang, S., … & Chen, W. (2022). LoRA: Low-rank adaptation of large language models. ICLR, 1(2), 3.
-
ControlNet — Zhang, L., Rao, A., & Agrawala, M. (2023). Adding conditional control to text-to-image diffusion models. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 3836–3847).
-
DiffusionDet — Chen, S., Sun, P., Song, Y., & Luo, P. (2023). DiffusionDet: Diffusion model for object detection. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 19830–19843).
-
Palette — Saharia, C., Chan, W., Chang, H., Lee, C., Ho, J., Salimans, T., … & Norouzi, M. (2022, July). Palette: Image-to-image diffusion models. In ACM SIGGRAPH 2022 Conference Proceedings (pp. 1–10).
-
TimeGrad — Rasul, K., Seward, C., Schuster, I., & Vollgraf, R. (2021, July). Autoregressive denoising diffusion models for multivariate probabilistic time series forecasting. In International Conference on Machine Learning (pp. 8857–8868). PMLR.
-
AlphaFold 3 — Abramson, J., Adler, J., Dunger, J., Evans, R., Green, T., Pritzel, A., … & Jumper, J. M. (2024). Accurate structure prediction of biomolecular interactions with AlphaFold 3. Nature, 630(8016), 493–500.
-
SMCDiff — Trippe, B. L., Yim, J., Tischer, D., Baker, D., Broderick, T., Barzilay, R., & Jaakkola, T. (2022). Diffusion probabilistic modeling of protein backbones in 3D for the motif-scaffolding problem. arXiv preprint arXiv:2206.04119.
-
DiffTraj — Zhu, Y., Ye, Y., Zhang, S., Zhao, X., & Yu, J. (2023). DiffTraj: Generating GPS trajectory with diffusion probabilistic model. Advances in Neural Information Processing Systems, 36, 65168–65188.
-
DiffUFlow — Zheng, Y., Zhong, L., Wang, S., Yang, Y., Gu, W., Zhang, J., & Wang, J. (2023, October). DiffUFlow: Robust fine-grained urban flow inference with denoising diffusion model. In Proceedings of the 32nd ACM International Conference on Information and Knowledge Management (pp. 3505–3513).
-
SpecSTG — Lin, L., Shi, D., Han, A., & Gao, J. (2025, June). SpecSTG: A fast spectral diffusion framework for probabilistic spatio-temporal traffic forecasting. In 2025 International Joint Conference on Neural Networks (IJCNN) (pp. 1–10). IEEE.
-
EDiffSR — Xiao, Y., Yuan, Q., Jiang, K., He, J., Jin, X., & Zhang, L. (2023). EDiffSR: An efficient diffusion probabilistic model for remote sensing image super-resolution. IEEE Transactions on Geoscience and Remote Sensing, 62, 1–14.
-
DiffCR — Zou, X., Li, K., Xing, J., Zhang, Y., Wang, S., Jin, L., & Tao, P. (2023). DiffCR: A fast conditional diffusion framework for cloud removal from optical satellite images. arXiv preprint arXiv:2308.04417.
-
DDPM-CD — Bandara, W. G. C., Nair, N. G., & Patel, V. M. (2022). DDPM-CD: Denoising diffusion probabilistic models as feature extractors for change detection. arXiv preprint arXiv:2206.11892.