Wiki GenAI
4 生成式AI与GeoAI

这个问题没有简单的答案,但它引导我们进入一个激动人心的领域:生成式人工智能(Generative AI)。
在接下来的内容中,我们将探索这个领域的基本概念、发展历程和核心技术,并尝试理解为什么“创造”可能是“理解”的更高形式。
什么是生成式 AI?#
从无到有#
“从无到有”听起来像哲学命题,但在生成式 AI 中,它有着精确的技术含义。
让我们通过一个思想实验来理解——想象你面前有一个空白画布,没有参考图,没有底稿,只有一句描述:
一只穿着太空服的柯基犬在月球表面漫步,远处是蓝色的地球。
一个传统的图像处理系统会束手无策:尽管它的数据库里可能有柯基犬的照片以及太空服的图片,但它并不知道如何将这些图片融合成一个全新的、从未存在过的场景,并确保光影一致、透视准确、细节逼真。
生成式 AI 能够做到这一点是因为它在学习“图片的生成过程”。
这就像一个画家,通过多年的训练,内化了光影、色彩、构图的规律,即使面对从未见过的场景,也能凭借这些规律创作出合理的作品。

理解与重组#
生成式 AI 并非简单地记忆训练数据,然后拼接复制;它学习的是数据的分布,即“什么样的数据是合理的、常见的、符合某种规律的”。
假设我们训练一个学习人脸图像的模型,它不会记住每一张具体的脸,而是学会了“眼睛通常在鼻子上方”“人脸大致呈椭圆形”“不同肤色有不同的色调分布”等抽象规律。
当需要生成新人脸时,它将这些规律重新组合,创造出现实中并不存在但看起来真实的面孔。
这种能力类似于人类的“创意联想”:一个作家可能从未经历过星际旅行,但通过对物理学、人性和文学的理解,能够写出引人入胜的科幻小说。
生成式 AI 也在做类似的事情,只不过它的“理解”是通过统计学习获得的。
条件可控#
现代生成式 AI 的一大进步,是实现了高度的可控性。
用户可以通过自然语言、草图、参数调节等方式,精确指定想要生成的内容。
以 OpenAI 的 Sora 为例。你不仅可以描述“一个女孩在雨中奔跑”,还可以细化为“一个穿着红色雨衣的女孩在广州街头的雨中慢跑,镜头从她身后跟随,黄昏时分,霓虹灯初亮”。
Sora 会根据这些详尽的指令,生成一段高度符合预期的视频。
这种可控性来源于条件生成机制。
模型并非盲目地生成随机内容,而是将用户的指令作为“条件”融入生成过程,确保输出与需求一致。
这让生成式 AI 从实验室玩具变成了实用工具。
多样性#
给定相同的输入,生成式 AI 可以产生多个不同但都合理的输出。
这与判别式 AI 形成鲜明对比——判别式模型对同一输入通常只给出一个确定的答案。
在创作场景中,多样性至关重要。
一个广告设计师可能需要生成十种不同的海报方案供客户选择;一个游戏开发者可能希望程序自动生成数千种不重复的 NPC 对话。
生成式 AI 的随机性赋予了它无限的创造可能。
什么不是生成式 AI?#
为了更清晰地理解生成式 AI 的边界,我们需要明确哪些系统不属于这个范畴:
-
简单的模板填充: 例如自动邮件回复系统,虽然能生成文本,但只是将预设的模板与变量组合,没有真正的“创造”过程。
-
数据库检索: 搜索引擎能找到相关内容,但它只是在已有数据中查找匹配项,并不生成新内容。
-
规则驱动(Rule-Based)的系统: 传统的专家系统通过人工编写的规则做出决策,这些规则是固定的、明确的,缺乏从数据中自主学习的能力。
理解生成式 AI:从历史视角到现代范式#
理解生成式 AI 的本质,常常需要从一个经典却有限的理论框架出发。
在传统统计学习理论中,模型通常被区分为判别式模型与生成式模型。
这一划分源于概率建模方式的根本差异,在早期机器学习中具有重要的教学与概念澄清意义。
需要强调的是:这种二分法有助于理解基础思想,但并不完全对应当代生成式 AI 的成功机制。
当前主流的大语言模型与扩散模型,其能力更多来自大规模自监督训练、深层表示学习与条件生成机制,而非传统意义上的“显式联合分布建模”。
尽管如此,这一经典框架仍然是理解现代范式的重要起点。
判别式模型关注的是“如何判断”。
其目标是在给定输入 X 的条件下,预测输出 Y,即学习条件概率:
典型任务包括图像分类、垃圾邮件识别与情感分析等。
此类模型的核心在于学习决策边界,而不关心输入数据本身的生成机制。
生成式模型则试图回答“数据如何产生”。
它们通过建模数据的统计结构来合成新样本,学习的对象是联合分布 P(X,Y) 或边缘分布 P(X)。
经典例子包括朴素贝叶斯、高斯混合模型(GMM)与隐马尔可夫模型(HMM)。
这些模型试图刻画数据在特征空间中的整体分布规律。

数学本质:为什么生成式建模更“完整”?#
让我们用数学语言精确地表述这一核心区别。
根据概率论的基本定理,贝叶斯定理揭示了两者的关系:
这个公式说明:如果我们知道联合分布 P(X,Y),就可以通过简单的边缘化和条件化推导出任何条件概率 P(Y\mid X)。
具体来说:
-
通过 P(X)=\sum_Y P(X,Y) 可以得到边缘分布 P(X)。
-
通过 P(Y\mid X)=P(X,Y)/P(X) 可以得到条件分布 P(Y\mid X)。
但反过来不成立: 仅知道 P(Y\mid X) 无法唯一确定 P(X,Y),因为我们缺失了关于 P(X) 的信息。
这就像你知道“在下雨的条件下带伞的概率”,但无法推断出“下雨且带伞”的联合概率,因为你不知道“下雨本身”的概率。
从信息量来看,生成式模型在理论上捕获的信息上界更高。
联合分布 P(X,Y) 包含了:
- 输入的边缘分布 P(X): 数据本身的统计规律。
- 标签的边缘分布 P(Y): 类别的先验知识。
- 输入与标签的关联 P(X\mid Y): 给定类别如何生成数据。
而判别式模型只捕获了条件分布 P(Y\mid X)。
用信息熵的语言说,生成式模型建模的是联合熵 H(X,Y),而判别式模型建模的是条件熵 H(Y\mid X)。
二者的差异正是输入的熵 H(X)——这是生成式模型在理论上可能学到的“额外信息”。
需要强调的是: 这一信息量上界的差异在理论上成立,但在实践中,模型是否真正学到这些信息,取决于训练目标、模型容量与数据质量。
现代判别式模型结合自监督学习(如对比学习),同样能够隐式地学习输入分布的结构。
因此,目标函数的形式本身并不能完全决定模型最终学到的表示质量。
这些就是传统生成式模型的概率论基础。
它们通过显式或隐式地建模数据分布,为后续的生成式 AI 发展奠定了理论根基。
难题:如何建模数据的分布?#
但如果仔细审视现代生成式 AI,如 LLM、VLM 的工作机制,会发现一个有趣的现象:这些模型在训练过程中并没有“显式建模概率密度函数”。
生成式的终极训练目标是逼近数据联合分布 p(x),但在真实尺度的数据空间中,直接显式地建模高维随机变量的联合概率分布几乎是不可行的。
设想一个看似简单的情形:对一张 256×256×3 的自然图像进行建模。
即便每个像素只取有限离散值,其联合分布也定义在维度超过二十万的空间中。
无论是参数规模、样本复杂度,还是对数似然的数值稳定性,直接为这一联合分布构造封闭形式的概率密度函数,都会迅速超出可计算与可学习的范围。
在这一背景下,现代生成式模型通过不同的分解、重参数化或隐式学习策略,绕开对联合分布的直接刻画,以可训练的方式逼近其生成能力。
以自回归语言模型为例,GPT-3 并非直接估计整个序列的联合概率 P(x_1,x_2,\ldots,x_n),而是利用概率论中的链式法则,将其分解为一系列条件概率:
在训练过程中,模型只需解决一个相对局部、结构明确的问题:在给定历史上下文的条件下预测下一个符号。
联合分布并未被显式参数化,而是通过这一可计算的条件分解被间接地刻画。
从数学上看,这与联合分布建模是等价的;从学习与优化的角度看,则显著降低了问题难度。
扩散模型(下文有详细讲解)采取了另一条路径:学习其对数密度的梯度,即所谓的得分函数:
通过在不同噪声尺度下训练网络预测“去噪方向”,模型在连续的反向扩散过程中逐步将随机噪声映射回数据分布。
这里,真实分布从未以显式公式的形式出现,但其局部几何结构——体现在概率密度的梯度场中——被有效地捕捉并用于生成。
生成对抗网络(GAN)则将这种“间接性”推向极端。
模型既不定义显式密度,也不进行似然计算,而是通过判别器提供的对抗信号,使生成分布 P^G 在样本层面逐步逼近真实数据分布 P^{Data}。
虽然我们无法写出生成分布的解析形式,但在分布匹配意义下,生成器仍被驱动去覆盖真实数据所处的高维流形。
现代生成式 AI 的成功,根源并非传统意义上的“建模联合分布 vs. 建模条件分布”的数学形式,而是生成任务本身对模型能力提出的特殊要求。
当我们要求 AI 从零创造一张图像、生成一段文本时,我们实际上在迫使它学习数据的深层结构化表示——这种表示必须足够丰富、足够全面,才能支撑“创造”这一复杂目标。
正是这种“生成目标倒逼深度表示学习”的机制,在经验上展现出了超越传统判别式方法的能力。
这也引出了另一个问题的思考:
如果生成任务能够倒逼出如此强大的知识表示,那么这些表示是否也能反向应用于判别、检索、分类等“理解”任务?
答案出人意料——我们将在下文“意外的发现”中看到,学会“创造”的 AI,往往也更擅长“理解”。
这一现象在当前的大规模预训练模型中得到了充分体现,尽管其背后的理论机制仍在探索之中。
发展的脉络#
要理解今天生成式 AI 的强大能力,我们需要回顾它的发展历程。
这不仅是技术进步的编年史,更是人类对“创造”本质认识不断深化的故事。
每一次技术突破,都代表着我们对“什么是创造”这一根本问题的认知跃迁。
一个重要的说明: 本文采用“认知隐喻”作为叙事工具,用“导航”“对抗”“渐进”“融合”等概念帮助理解技术本质。
但需要明确:这些技术路线是并行演进、互相融合的,而非简单的线性替代关系。
从数学本质看:
-
VAE、Flow、Diffusion、AR(自回归)是显式或近似显式的概率模型,它们明确定义或近似数据的概率密度函数 p(x)。
-
GAN 是隐式分布匹配模型,通过对抗训练直接优化分布距离,而不显式建模概率密度。
-
Diffusion / Score-Based 模型还可被理解为在样本空间中定义的随机/确定性动力系统。
-
Transformer 是一种高效的函数逼近架构,可服务于多种生成范式(AR、Diffusion、GAN 等),而非独立的生成路径。
它们共同构成了现代生成式 AI 的技术基础。
让我们沿着这条演进主线,重新审视生成式 AI 的历史。
路线一:潜变量建模的神经网络化(2014)#
从经典统计到深度生成#
2014 年之前,生成建模领域已有长期积累。
隐马尔可夫模型(HMM)、高斯混合模型(GMM)、潜在狄利克雷分配(LDA)等经典方法在语音、图像聚类、主题建模等任务中取得成功。
潜变量(Latent Variable)的概念更可追溯至因子分析(1904)、主成分分析(PCA,1901)等统计学方法。
然而,这些经典方法面临一个共同困境:难以在连续、高维、复杂结构的数据空间(如自然图像)中实现可控生成和语义插值。
自编码器(Autoencoder)虽在1980年代提出,但缺乏概率框架,难以从潜在表示中采样生成新样本。
变分自编码器(VAE)的出现,为这一问题提供了突破性解决方案。
VAE(Kingma et al., 2014)本质上是将潜变量模型与神经网络、变分推断三者结合,实现了一种近似显式的概率生成模型。
它显式建模数据分布 p(x) 和潜在后验分布 q(z\mid x),但由于精确后验 p(z\mid x) 难以计算,使用变分推断进行近似。
显式概率建模与变分推断#
VAE 的核心思想是学习数据在“潜在空间”(Latent Space)中的概率分布。
系统由两个神经网络组成:
-
编码器(Encoder)q_\phi(z\mid x): 将高维数据(如256×256图像,65,536维)映射到低维潜在表示(如128维向量)的近似后验分布。这个过程提取数据的统计规律,而非简单降维。
-
解码器(Decoder)p_\theta(x\mid z): 从潜在表示重建回原始数据的条件概率分布。训练充分后,即使潜在空间中的点从未在训练集出现,解码器也能生成合理样本。
数学框架: VAE 通过变分推断,显式建模潜在变量的后验分布 q_\phi(z\mid x) 和先验分布 p(z)(通常为标准正态分布)。
训练目标是最大化证据下界(ELBO),同时优化重建质量和分布正则化:
第一项鼓励准确重建,第二项(KL 散度)确保后验分布接近先验分布,使潜在空间具有良好的结构化和连续性。
“近似显式”的含义:VAE 是显式概率模型,因为它明确定义了:
但由于积分难以计算,使用变分推断来近似优化。
路线二:隐式分布匹配的对抗学习(2014–2016)#
VAE 通过显式建模数据分布 p_\theta(x) 实现生成,但这要求计算或近似似然函数(Likelihood),在高维空间中计算成本高昂。
生成对抗网络(GAN)提出了一种全新思路:不显式建模概率密度函数,而是通过对抗训练隐式地匹配生成分布与真实分布。
对抗训练的隐式优化#
GAN(Goodfellow et al., 2014)采用双网络博弈机制实现隐式分布匹配:
- 生成器(Generator)G: 从随机噪声 z\sim p_z 生成假样本 G(z)。
- 判别器(Discriminator)D: 判断样本是真实数据还是生成样本,输出“真实”概率。
从数学上,训练过程等价于求解极小极大优化问题:
- 判别器试图最大化目标函数(正确分类)。
- 生成器试图最小化目标函数(欺骗判别器)。
当判别器最优时,生成器的优化等价于最小化生成分布 p_G 与真实分布 p_{\mathrm{data}} 之间的 Jensen-Shannon 散度(Goodfellow et al., 2014):
但值得注意的是,这意味着 GAN 并非“不做概率建模”,而是隐式地进行分布匹配。
它通过对抗机制优化分布间的概率距离,但不显式定义或计算 p_G(x) 的密度函数形式。
后续的 Wasserstein GAN(WGAN)进一步改用 Wasserstein 距离,缓解梯度消失问题。

路线三:基于分数(Score-Based)的渐进生成(2020)#
扩散模型是一种显式概率模型,通过变分下界精确建模数据似然 p(x)。
同时,它还可被理解为在样本空间中定义的随机/确定性动力系统。
其核心思想源自:
-
Langevin 动力学(1908): 通过随机梯度上升采样概率分布。
-
分数匹配(Score Matching,Hyvärinen, 2005): 学习数据分布的梯度场:
- 噪声条件分数网络(NCSN,Song & Ermon, 2019): 多尺度噪声条件下的分数估计。
正向扩散过程:马尔可夫链与随机动力系统#
如今大家熟知的去噪扩散概率模型(DDPM)(Ho et al., 2020),将连续时间的随机微分方程(SDE)离散化为可训练的深度网络流程,使得 Score-Based 方法在工程上高效可行。
其正向过程定义了一个马尔可夫链,逐步向数据添加高斯噪声,直到完全破坏其结构:
其中 \beta_t 是预设的噪声调度。
经过 T 步(如 T=1000),x_T 近似纯高斯噪声 \mathcal{N}(0,I)。
从动力系统上看,这一过程可被视为在数据流形上定义的随机微分方程(SDE):
其中 w 是维纳过程(布朗运动),f 和 g 决定漂移和扩散项。
逆向去噪过程:时间反演与概率建模#
训练神经网络 \epsilon_\theta(x_t,t) 预测每一步添加的噪声(等价于学习分数函数 \nabla_{x_t}\log p(x_t)),从而学习逆过程——SDE 的时间反演:
采样时,从纯噪声 x_T\sim\mathcal{N}(0,I) 开始,逐步去噪:
每步都是小幅修正,T 步累积后,噪声演化为清晰图像。
扩散模型既是显式概率模型(通过 ELBO 优化 p(x)),又是动力系统(正向 SDE 的时间反演)。
技术路线的互补与融合#
要说明的是,VAE、GAN、扩散模型并非前后替代关系。
从这三条技术路线的数学原理来看,会发现它们的本质是针对生成分布建模的三种策略:
-
VAE:显式近似。 通过变分推断近似难以计算的后验分布,显式建模 p(x) 和潜在变量分布,提供概率解释。
-
GAN:隐式匹配。 不显式建模 p(x) 的密度函数,而是通过对抗训练隐式优化生成分布与真实分布的距离。
-
扩散模型:动力系统演化。 既是显式概率模型(通过 ELBO),又可理解为样本空间中的随机/确定性动力系统(SDE/ODE),通过渐进去噪逼近分布。
而这三种策略奔向的是同一个目标:
学习世界的统计结构,并能从中采样出新的、合理的、有意义的样本。
因此,在生成式 AI 的语境下,模型架构往往服务于生成目标下的学习范式。
无论是采用 CNN、RNN 亦或 Transformer 的框架,首先要明确的是,你想从数据中得到什么?以及在这个目标下,数据之间会存在哪些隐性的特征与关系。
有趣的现象:生成式 AI 的“反向”能力#
近年来一个令人惊讶的趋势出现了:当前最优秀的嵌入模型,往往继承自生成式语言模型的预训练表示,而非从零训练的判别式模型。
例如:
-
OpenAI 的 text-embedding-3: 基于 GPT 系列的预训练 Backbone,在多语言理解、语义搜索等任务上全面超越 BERT 家族。
-
Cohere 的 Embed 模型: 同样继承自生成式预训练,在大规模文本嵌入基准上长期占据榜首。
-
对比: 直接训练的 BERT-like 模型在规模相当的情况下,往往落后于这些继承生成式预训练表示的嵌入系统。
这一现象引发了深刻的思考:
为什么专注于“生成”的模型,在“判别”任务上也能表现优异,甚至超越专门为判别设计的模型?
为什么生成式 AI 能“弯道超车”?#
需要澄清一个关键问题:生成式模型在判别任务上的优势,并非直接源于其概率建模形式(即是否建模联合分布),而是源于生成任务对表示学习提出了更高、更全面的要求。
这一优势目前主要表现为经验性观察(Empirical Observation),而非严格意义上的理论保证。
换句话说:优势并非源于“建模方式”本身,而是“生成目标”倒逼出了更通用、更鲁棒的知识表示。
生成任务作为“最强约束”#
现代生成式 AI 的核心优势,来自于生成任务的特殊性质:
-
完整性约束: 生成需要“从零创造”,无法通过局部特征取巧,必须理解全局结构。
-
一致性约束: 生成的内容必须在多个层次(语法、语义、逻辑、常识)保持一致。
-
多样性约束: 既要符合分布又要避免模式崩溃,要求模型捕获数据的完整变化空间。
-
可解释性压力: 生成的“可检验性”迫使模型学习可复用的中间表示。
这些约束共同作用,使得生成式预训练在经验上成为一种极为有效的表示学习方式。
它不仅学会了“判断什么是对的”,更学会了“如何从零构造对的东西”。
后者在统计学习意义上是更高维度的能力。
需要澄清的限制#
在了解生成式 AI 优势的同时,我们也需要保持清醒的认识。
1. 这一优势主要在特定条件下观察到
目前生成式模型的领先表现,主要集中在:大规模预训练(数十亿至数千亿参数)、极其多样化的数据分布(全网文本、海量图像),以及充足的计算资源支持。
而在小规模、特定领域、计算受限的场景下,专门设计的判别式模型仍可能更高效。
2. 判别式 + 自监督也能学习深层表示
现代判别式方法,如 SimCLR、MoCo、CLIP,通过对比学习等自监督目标,同样能够学习到输入数据的深层结构。
这或许说明:“生成目标”并非学习深层表示的唯一途径,关键在于训练目标是否迫使模型捕获数据的全局结构。
3. 目标函数形式与实际学到的表示存在差距
一个模型的训练目标是 P(X\mid Y),不代表它一定学到了 P(X) 的完整结构;同样,训练目标是 P(Y\mid X),也不意味着它没有隐式建模 P(X)。
深度神经网络的中间层表示往往超越其显式优化目标。
因此,更准确的表述是:在当前的大规模预训练范式下,生成任务展现出了学习通用表示的显著优势,但这一优势的理论边界与适用条件仍在探索之中。
从语言的层面来看,要生成连贯的文本,模型不仅需要知道哪些词汇常见(表面统计),更需要在表征层面捕获语法结构、逻辑关系、上下文语义,甚至常识知识。
例如,要续写“太阳从东方升起,傍晚时分……”,模型必须在其内部表示中编码时间流逝、地理方位、自然现象等概念的结构性规律。
而这种深层的结构表征正是判别任务所需要的。
因此,当模型学会了“创造”文本,它实际上已经在功能层面内化了语言的方方面面,这些知识表示自然可以迁移到分类、匹配、检索等判别任务中。
生成与理解#
回到文章的开头:“凡我不能创造的,我尚未真正理解。”
费曼的这句话在 AI 领域得到了意外的验证。
生成式 AI 的成功表明,“创造”可能是“功能性理解”的更高形式。
当一个模型能够从零生成逼真的图像、流畅的文本或动听的音乐时,它必须已经在表征层面捕获了这些数据的深层统计规律。
这种“理解”是隐性的、分布式的、统计学意义上的,体现在模型的亿万参数之中,而非显式的符号规则或语义解释。
但正因其在功能层面的全面性和深度,它能够支撑各种下游任务——无论是生成还是判别。
对于如何通往通用人工智能(AGI)仍存在不同的声音,但只有当 AI 能够“创造”世界(生成图像、模拟物理、推演逻辑)时,它才在功能意义上“理解”了世界的运作规律。
当然,其他路径,如强化学习 + 规划、神经符号系统,也在并行探索之中。
一个小实验:观察“创造性”#
从“生成模糊图像”到“生成高清视频”,从“无条件生成”到“精确可控生成”,从“单一模态”到“多模态融合”,技术在不断飞速发展,应用也层出不穷。
请你选择任意一个工具,用相同的提示词重复生成3–5次,观察结果的差异。
你会发现:
- 每次生成的内容都不完全相同。
- 有些版本可能更符合你的期望,有些则可能出现意外的惊喜。
- 这种多样性正是生成式 AI 的特点——并非机械地输出固定结果,而是在合理的范围内进行创造性探索。
尝试思考:
这种随机性是缺陷还是特性?在什么场景下,你需要确定性的输出?在什么场景下,你更希望看到多样的可能性?
生成式地理空间智能:当时空的约束进入生成模型#
读到此处,你也许已经有了一个疑问:
GIS 的传统核心是空间统计与空间分析,即把空间对象与过程转化为可计算的量,进而做出预测、做评估和解释;而生成式 AI 的核心并不是给出一个确定答案——那么,为什么要在生成式范式下讨论地理空间智能?
我们的理解是:
- 在应用层面: 隐私受限、样本稀缺与情景推演,确实构成了对合成数据与生成能力的直接需求。
- 在研究范式层面: 生成式模型提供的是关于“空间表示与空间建模”的一种理解。
经典 GIS 统计和预测给出一个“最可能的点估计”,GeoAI 的出现并不会改变这一点,而是将可计算这件事通过深度学习的方法推进到了更强的函数逼近能力上,学习数据“可能如何出现”的统计规律,也就是对数据分布的拟合与采样。
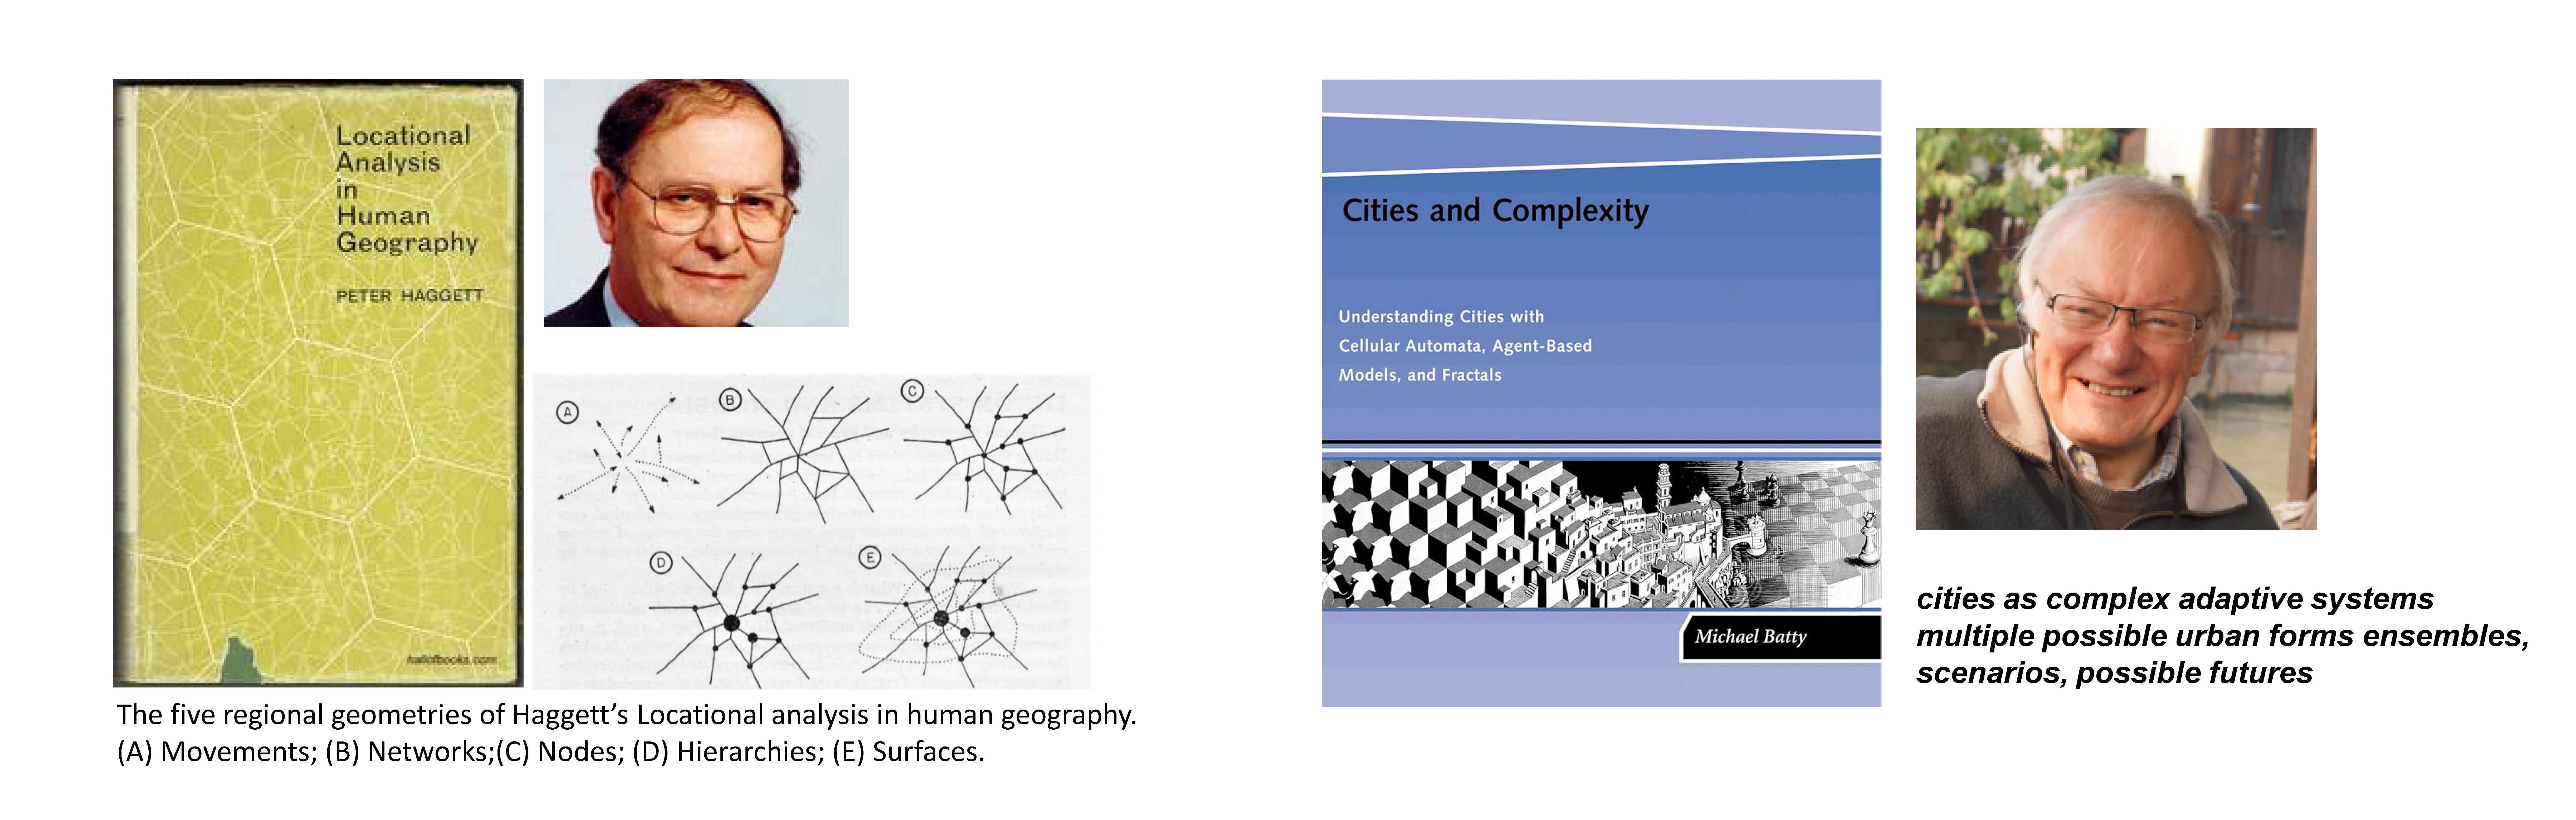
回望空间科学长期关注的基础特性,如空间异质性、空间依赖性、尺度效应等,会发现很多地理空间现象并不天然收敛到唯一答案。
在相同的约束条件下,一座城市可能存在多种同样合理的道路组织;在相似的用地与供给结构下,人群活动也可能呈现多种模式变体。
由此,相较于“把答案算得更准”,生成式地理空间智能(Generative GeoAI)将回答从单一最优值延伸为:
在既定的时空结构与约束下,系统可能出现哪些可行形态,这些形态如何分布,以及在情景扰动下系统如何变化与迁移。
这里的关键词是:
可行形态集合 + 情景推演 + 不确定性刻画。
空间问题的多解性往往来自约束下的组合空间,而生成式建模恰好擅长刻画这种可能性的集合。
时空约束下的数据生成#
然而,“分布拟合与采样”一旦进入地理空间,就必须被更精确地理解。
语言生成允许相当程度的自由:你可以编造一句话,只要语法大体通顺,读者往往还能理解其意图。
空间对象则不同。
以道路为例,新增道路不仅要在局部形态上像道路,更必须与既有网络的连通关系相容,并受地形、用地边界、道路等级与通行规则等约束。
如果忽略这些约束,结果即便局部“像”,也可能在连通性或可达性上明显失真。
换言之,地理空间中的生成难点在于结构一致性:
几何、拓扑、语义与时间组织必须同时成立。
因此,Generative GeoAI 可以被更明确地表述为:模型如何学习“约束条件下的样本分布”,并在采样过程中持续尊重客观环境中的时空结构与规则。
这里所谓“约束进入生成过程”,并不等同于生成后再做修补,而是指:生成的每一步都要受到结构条件的引导,使不可行的局部细节不至于扩散为全局失真。
一个例子:等高线的生成#
为了让这一点更直观,可以从等高线,这个测绘和制图中最经典且生成逻辑清晰的例子入手。
想象你手里已有一组离散的高程观测点,或者一个栅格化的 DEM,那么生成等高线的第一步首先是构建一个连续高度场:
这一步的本质是插值或拟合:无论采用三角网、样条、径向基函数还是克里金,都在做同一件事——用一个带先验的模型去填补未知区域,让 h(x,y) 在空间上保持合理的连续性与相关性。
这里的“合理”并非指审美,而是对地形这一物理对象的结构性要求,如近邻相关、方向性变化,以及测量不确定性的传播方式,都被构造进了插值核或协方差结构之中,即建立自洽的空间状态。
得到连续场 h(x,y) 之后,第二步则是结构抽取。
给定一组阈值 c,等高线集合就是:
在栅格上,常见做法是逐格检查角点相对阈值的组合,决定线段穿越方式并拼接为连贯曲线。
关键在于,线的拓扑连通由连续场的局部变化决定:只要高度场在局部自洽,连通结构会自然出现。
反之,若高度场被噪声或不合理拟合破坏,等高线就会出现毛刺、断裂、伪闭合圈等结构性瑕疵,问题往往首先暴露在“场”的构建质量上。
最后一步进入表达层面的约束:抽稀、平滑与层级表达,使结果满足地图作为信息载体的可读性规范。
例如去掉细碎曲线、避免近距离挤压、保证主次等高线层级清晰。
到这里可以看到,一个典型的空间“生成过程”并不只是产出对象,还需同时服从物理/几何约束与表达约束:
它先生成一个“状态”,再从状态中抽取结构,最后把结构压缩为可读表达。
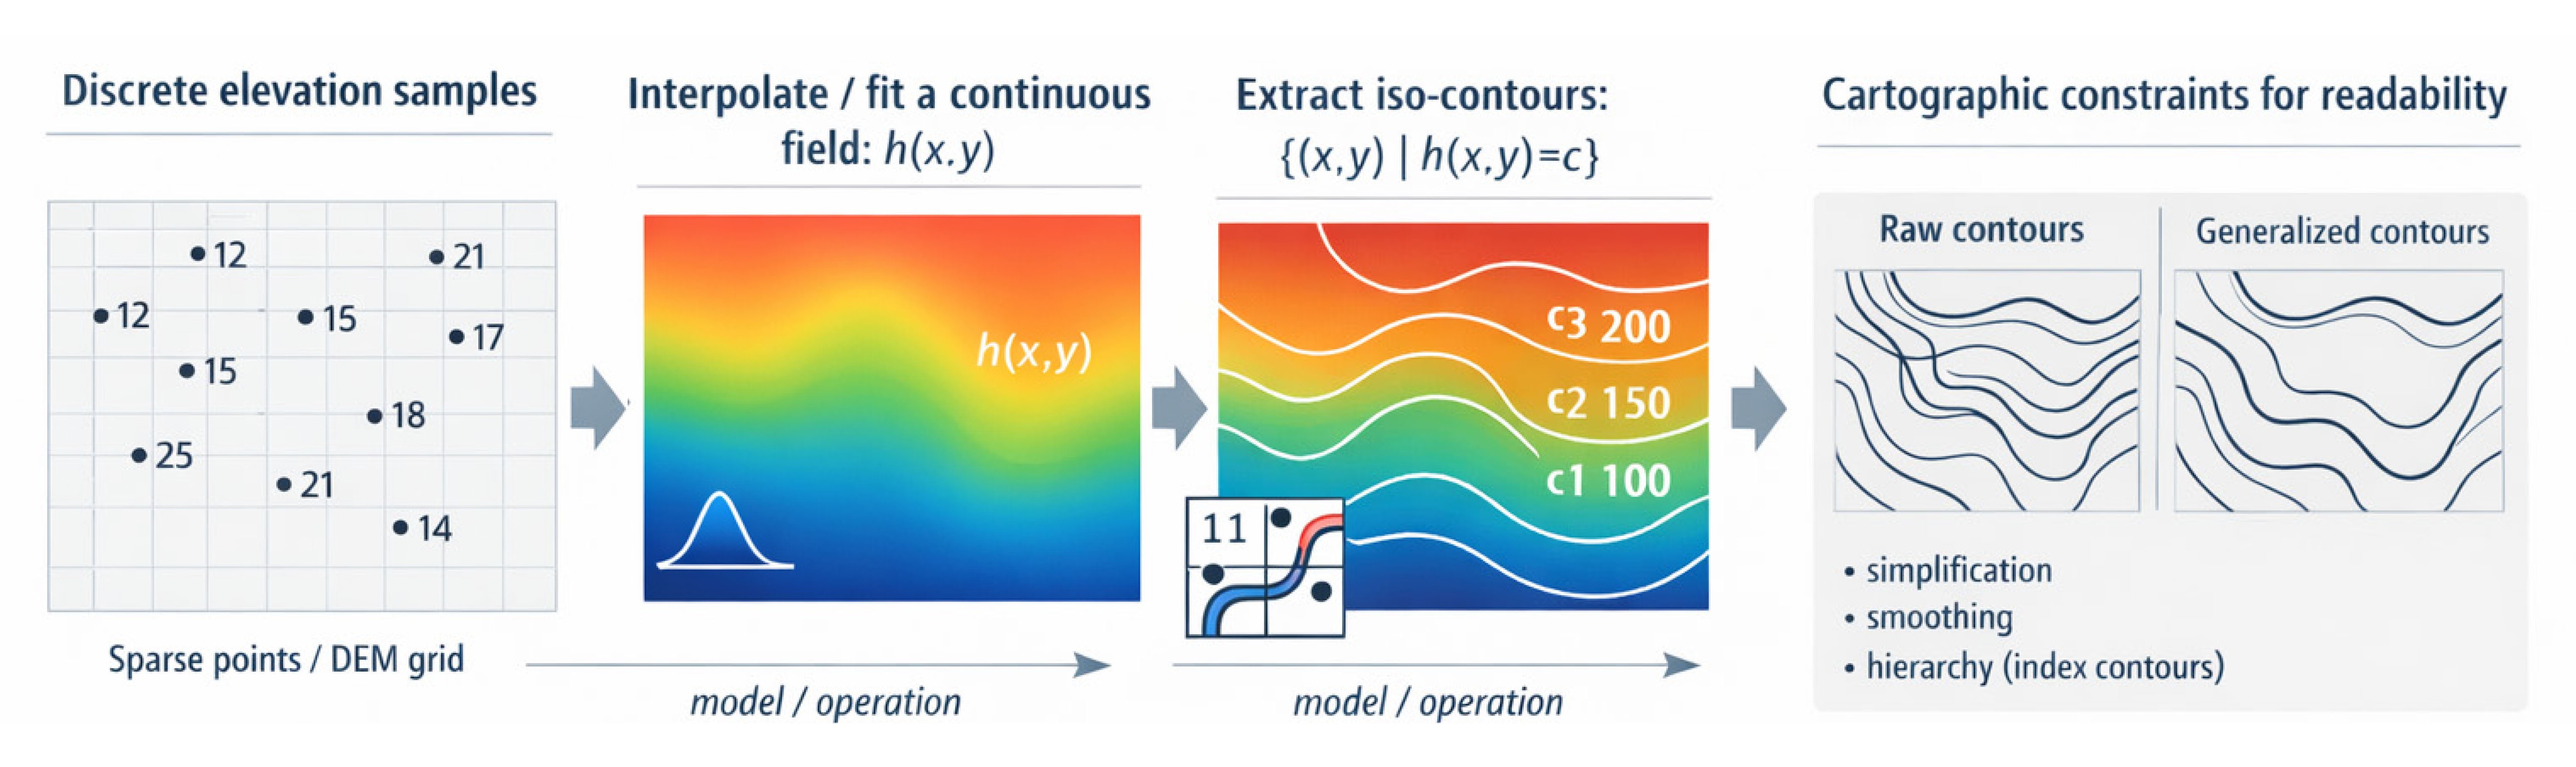
这个等高线生成的例子说明,许多空间对象或现象都可以理解为某种空间状态和潜在结构的外显结果。
线只是对高度场的等值切片,其连通与形态首先由场的连续性与空间相关性决定。
传统等高线绘制流程里,潜在场 h(x,y) 来自你选定的插值模型与少量参数。
而在 Generative GeoAI 中,这类潜在结构不再完全由人工指定,模型会从观测中学习更一般的空间状态。
同时,在生成的每一步,采样也并非是在分布中随机抛点:空间关系约束、拓扑规则与尺度层级需要持续发挥作用,抑制不可行细节的扩散,维持整体结构的稳定性。
因此,Generative GeoAI 关心的是在满足一组空间与时间结构条件时,空间对象可能呈现出的“整体形态集合”。
虽然并非所有空间对象都有类似地形这样明确的物理场,但很多对象都隐含某种“约束下的状态空间”。
例如,道路网络可以被看作一种“可达性—成本场”在离散空间上的结构化;城市功能区则是人口、就业、服务供给等潜在因素叠加后的稳定格局;人群移动既受空间可达性约束,也受时间与活动链结构约束。
如果只拟合长度分布、角度分布或局部密度这类边缘统计,可能会得到局部相似却全局失真的样本。
而能否在全局连通、跨区可达与层级组织等结构指标上同时保持一致,更能区分模型是“学到结构”还是在“拼贴外观”。
所以,在多数地理空间生成问题中,决定其结果是否成立的并非是对象的表面形态,而应该是其所代表的空间状态的自洽性与约束满足情况。
读者也可以联系上文提到的 VAE、GAN 与 Diffusion 的基本思路,把它们粗略理解为:模型先学习“什么是可能的”,再通过某种生成过程去“从可能性里抽取一个样本”。对地理空间而言,关键差异在于:“可能性”的边界主要由时空约束决定。那么,“时空约束”究竟应如何被编码、如何在采样中发挥作用?
处于统一的空间参照下#
生成式建模提供了一种统一的组织语言:
它不要求每种模态先被压成同一种格式,而是要求它们在同一时空参照与空间关系下形成一致表征,使跨模态一致性或互补性成为可学习、可检验的对象。
因此,遥感影像、路网、轨迹序列、POI 语义、气象与社会经济等数据可以被纳入统一的基础模型框架,共同构成一个地理空间多模态体系。
因为它们共享位置、邻接、连通、尺度与时间上下文等同一套时空参照与空间关系。
沿着这一思路,Generative GeoAI 更像是在为智能时代下的多模态空间感知与分析补上“可推演”的一环,而不只是新增一个“生成应用”的分支。
这也与本书前文讨论的 Tokenization 与 World Model 形成呼应:只有当空间被转译为可组合、可推理的内部表示时,约束才可能进入生成过程本身,而不是停留在事后修补。
当然,这种范式也带来新的难题:
时空结构的一致性如何被度量?
如果模型生成的道路在视觉上合理,却改变了网络连通与功能可达,那么它在空间意义上就失去了可用性。
这就意味着 Generative GeoAI 的评价体系无法停留在像素、坐标或局部统计上,而是回到数据所承载的空间本体信息:
连通性、可达性、层级结构、时间耦合,以及多尺度特性等。
基于这一点,后续章节无论讨论具体对象(道路、用地、轨迹)还是具体基础模型(如地球观测表征),核心都可以统一为同一个问题:
不同空间对象对应哪些结构条件,生成结果应如何检验其空间意义上的成立性。
附录:推荐几个简单易用的工具#
为了让你真正体验生成式 AI 的魅力,我们精选了一些上手简单、效果出色的工具。
无论你想生成图像、视频还是音乐,都能找到合适的选择。
文生图工具#
国外产品
-
Stable Diffusion Web UI: 开源社区的明星项目,可在线使用或本地部署。提供极高的自由度和可控性,是专业用户的首选。访问 Stable Diffusion Web 即可体验在线版。
-
Midjourney: 以艺术风格著称的文生图工具,生成的图像极具美感。通过 Discord 使用,付费订阅制(原稿标注为 $10/月起)。
-
DALL-E 3: OpenAI 开发,与 ChatGPT 深度集成。理解复杂提示词的能力很强。
国内产品
-
文心一格(百度): 国内较早推出的文生图服务之一,支持中文提示词,生成速度快。yige.baidu.com
-
通义万相(阿里): 阿里云推出的 AI 绘画平台,支持多种风格切换(国风、二次元、写实等)。通义万相
-
可图(字节跳动): 抖音背后的技术团队出品,特别擅长生成适合短视频的封面图和插画。微信搜索“可图 AI”小程序即可使用。
-
6pen: 主打艺术创作风格,提供丰富的艺术家风格模板(如梵高、莫奈风格)。6pen.art
-
意间 AI: 专注于商业设计场景,提供产品图、营销海报等模板,对商业用户友好。yjai.art
视频生成工具#
国外产品
-
Sora(OpenAI): 文生视频模型,支持基于文本等方式生成视频内容。
-
Runway: 专业级视频创作平台,支持文生视频、图生视频、视频编辑等多种功能。runwayml.com
-
Pika: 简单易用的视频生成工具,特别适合快速制作短视频。pika.art
国内产品
-
即梦 AI(字节跳动): 字节旗下的视频生成平台,生成速度快,支持多种视频风格。即梦 AI
-
可灵 AI(快手): 快手推出的视频生成工具,擅长生成具有连贯动作的短视频片段。
-
PixVerse: 支持图生视频和文生视频,操作界面友好,适合新手。pixverse.ai
AI 音乐生成工具#
国外产品
-
Suno: 被誉为“音乐界的 ChatGPT”,只需输入文字描述就能生成完整歌曲(包括人声、歌词、伴奏)。suno.ai
-
Udio: 与 Suno 类似但更注重音质,支持更精细的风格控制。udio.com
国内产品
-
天工 AI 音乐(昆仑万维): 国内较早推出的 AI 音乐生成平台,支持中文歌词生成,曲风覆盖流行、民谣、摇滚等。tiangong.cn
-
网易天音: 网易云音乐推出的 AI 作曲工具,适合生成背景音乐和纯音乐。
3D 场景生成工具#
-
Luma AI: 可以通过上传手机拍摄的视频生成 3D 模型。lumalabs.ai
-
CSM(Cube Scene Maker): 用于快速生成简单 3D 场景的工具,适合游戏原型设计。
作者信息与参考来源#
香港科技大学(广州),2025级城市治理与设计专业博士研究生。
研究方向:GeoAI、GenAI。
本科毕业于山东大学,现为深圳大学城市空间信息工程系,2023级人工智能专业硕士研究生。
研究方向:GeoAI、Geospatial Data Representation Learning。
深圳大学城市空间信息工程系,2022级博士研究生。
研究方向:GeoAI、Geospatial Tokenization、Human Mobility Generation、Geospatial Data Representation Learning。
本章节由王世琦、李国隆、黄菲负责编写,含 AI 工具辅助,文中所用插图部分来源于网络。
参考来源#
-
Ho, J., Jain, A., & Abbeel, P. (2020). Denoising diffusion probabilistic models. Advances in Neural Information Processing Systems, 33, 6840–6851.
-
Kingma, D. P., & Welling, M. (2022). Auto-encoding variational Bayes. Foundations and Trends in Machine Learning, 14(4), 307–392.
-
Radford, A., Metz, L., & Chintala, S. (2016). Unsupervised representation learning with deep convolutional generative adversarial networks. International Conference on Learning Representations (ICLR).
-
Radford, A., Narasimhan, K., Salimans, T., & Sutskever, I. (2018). Improving language understanding by generative pre-training. OpenAI Technical Report.
-
Ramesh, A., Dhariwal, P., Nichol, A., Chu, C., & Chen, M. (2022). Hierarchical text-conditional image generation with CLIP latents. arXiv preprint arXiv:2204.06125.
-
Rombach, R., Blattmann, A., Lorenz, D., Esser, P., & Ommer, B. (2022). High-resolution image synthesis with latent diffusion models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 10684–10695.
-
Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S., & Poole, B. (2021). Score-based generative modeling through stochastic differential equations. International Conference on Learning Representations (ICLR).
-
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30, 5998–6008.