Wiki Foundations
3 AI基础概念与框架
在深入探索人工智能那令人眼花缭乱的结构之前,让我们先回到那个实现关键飞跃的起点。在这里,一个看似朴素的结构——多层感知机(Multi-Layer Perceptron, MLP)——完成了至关重要的一步。它犹如神来之笔,首次为算法注入了理论上无限的表达能力,将一片广阔的“应许之地”展现在我们面前。而指引我们穿越这片土地,从数据中汲取智慧的,正是其背后强大的引擎——反向传播(Backpropagation)。本章我们将一同解构这两个最基础的概念。它们是开启后续所有复杂模型大门的钥匙,也是理解人工智能如何从有限的规则走向无限创造力的关键。无论未来的建筑多么宏伟,它们都建立在同样坚实的地基之上。
搭建智能的第一块积木:多层感知机(MLP)#
历史的有趣之处在于,许多当代的伟大创新,其思想的种子往往埋藏在遥远的过去。现代深度学习的这第一块积木——多层感知机(MLP)正是如此。它如今是构建一切复杂模型的基础,但它的名字和最初的灵感,却源于上世纪一个宏伟但一度失败的构想。
感知机,从生物启发和伟大愿景开始#
“感知机(Perceptron)”这个词诞生于上世纪50年代,其命名巧妙地融合了它的生物学灵感和时代技术背景,我们可以将其拆解为两部分来理解。
1. “Percept”(知觉 / 感知物)
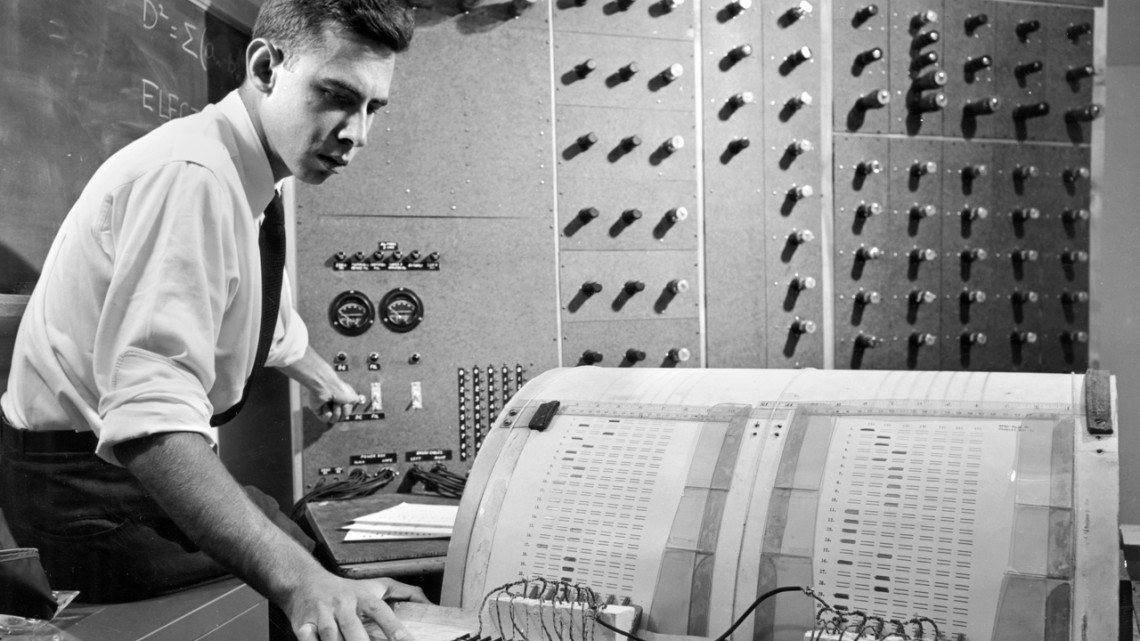
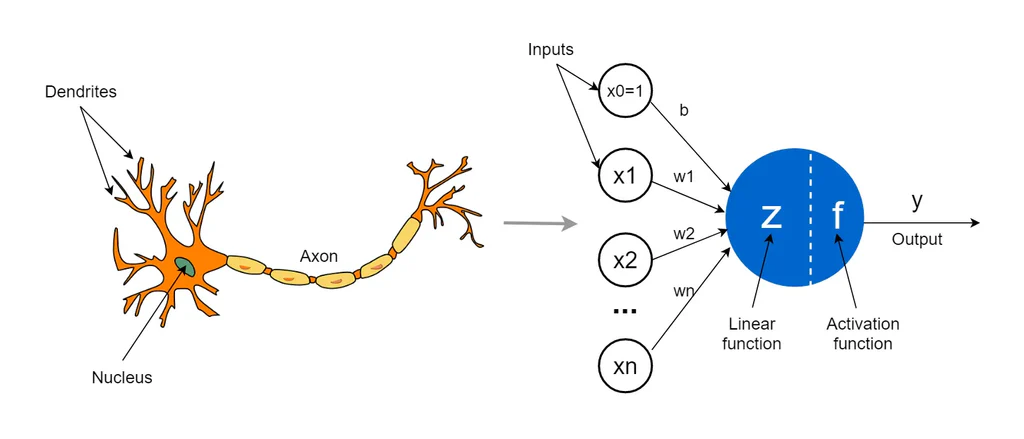
这部分源于心理学,是整个命名的核心。发明者弗兰克·罗森布拉特(Frank Rosenblatt)是一位心理学家,他的宏伟构想并非简单地制造一个计算器,而是要用电子电路来模拟生物大脑神经元的学习过程。在认知科学中,“Percept”指的是生物通过感官(如视觉、听觉)接收信息,经过大脑处理后形成的内部认知或印象。罗森布拉特创造的机器,其目的正是要模仿这个过程:接收原始输入数据,然后学习如何将其分类。因此,“Percept”作为词根,对应了这台机器的核心功能——模拟生物的感知与识别能力。
2. “-tron”(电子设备)
这是个极具时代特色的后缀。在20世纪中叶,随着电子技术和原子能的飞速发展,“-tron”成了一个非常时髦的词尾,专门用于命名那些听起来很前沿、很强大的电子或科学设备,例如“电子(Electron)”、“回旋加速器(Cyclotron)”等。给自己的发明加上“-tron”的后缀,能立刻赋予其一种高科技、未来感的光环。
因此,将这两部分结合起来,Percep-tron 的意思就非常清晰了:一个用于实现感知的电子机器。这个名字不仅精准地描述了它的功能,也深深烙上了那个对电子大脑充满无限乐观与想象的时代的印记。
然而,与美好想象对应的是它的悲催命运:1969年,马文·明斯基(Marvin Minsky)和西摩·帕普特(Seymour Papert)合著的《感知机:几何计算》(Perceptrons: An Introduction to Computational Geometry)指出,这类网络不可能学习异或函数。这一盆冷水直接浇灭了大家对「神经网络」的热情,相应的研究资助几乎完全冻结,也将AI的研究方向引至符号主义长达十余年之久。
构成MLP的组件和原理#
最初的感知机,其结构可以理解为一个线性层紧跟着一个阶跃函数(Step Function)。然而,研究者们发现,阶跃函数自身存在一些关键的局限性(我们将在后续关于反向传播的部分详细探讨),这阻碍了模型向更复杂、更深层的结构发展。为了突破这些限制,一系列关键的改进催生了我们今天所熟知的MLP。其核心构造单元主要包括四个部分:基础的线性层、赋予模型非线性能力的激活函数、实现网络深度的堆叠方式,以及一个用于整合信息并输出结果的最终层。
一个基本的MLP接受输入数据(一个代表我们研究对象的属性向量,通常表示为 x),然后对它进行处理。MLP通常这样组成:
1. 线性层
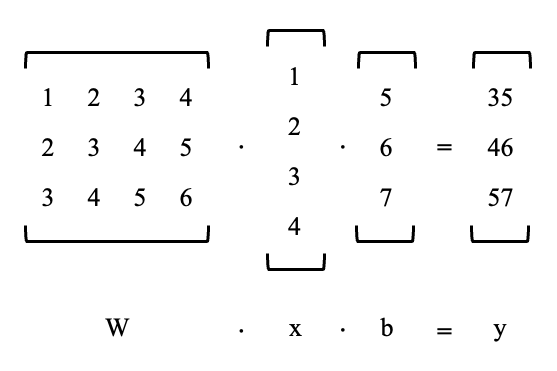
对数据进行线性变换,可以理解为线性函数 y=kx+b 的矩阵升级版。其通用公式为:
2. 非线性激活函数
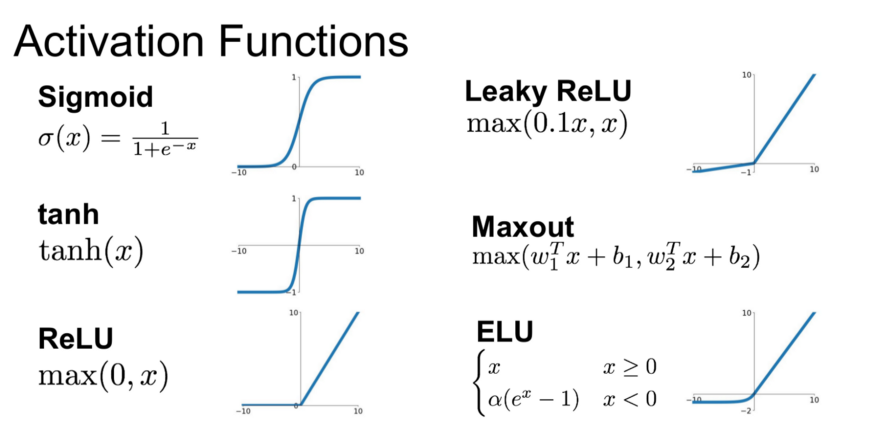
对前一步的结果进行简单或复杂的非线性变换,为模型引入非线性能力,从而能够学习和拟合远比线性模型复杂的函数。常见的激活函数包括:
- 最经典的 Sigmoid
- 简单而常用的 ReLU
- 还有更多种类的激活函数
3. 堆叠
第1点和第2点的 线性层 → 非线性激活 组合可以被看作一个基本的网络层。通过将这个组合堆叠和重复多次,就可以构建一个“深度”神经网络,用来处理从简单到复杂的层级化关系。
4. 最终的线性层
在经过一系列隐藏层后,通常会再接一个最终的线性层。它的作用是整合网络前面学到的所有高级特征,并将其映射到任务所需的最终输出维度(例如,在分类任务中输出每个类别的得分)。
魔法的核心:非线性带来了什么区别?#
线性层负责主要的线性变换,而非线性激活函数在它的基础上作裁剪,为什么我们不能只用线性层?为什么必须在中间加入那个非线性激活函数?
答案就藏在名字中——非线性。一个单纯的线性层,虽然其中的变换已经很复杂,但无论将它重复堆叠多少次,其最终效果等同于只用一个线性层,参考下面的推导:
两个线性层(Linear)直接堆叠会发生什么?
这说明堆叠的两个线性层,实际上表达能力等价于标准的、单一的线性层。
如果在中间加入非线性激活函数(Activation),情况就完全不同了:
由于中间的非线性激活函数,这个式子再无法被化简成一个简单的线性层了。
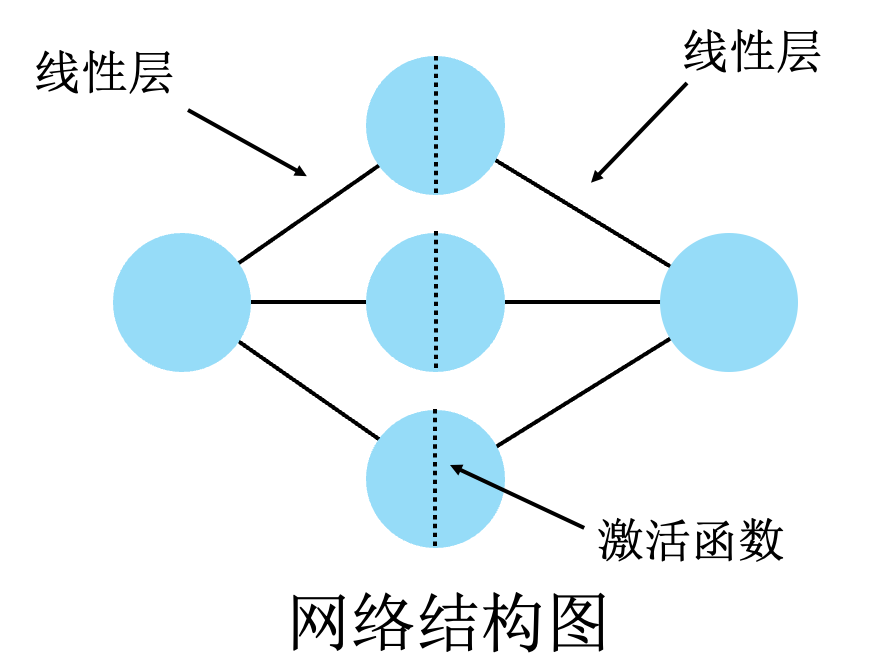
让我们用一个线性函数的例子来感受一下引入非线性激活函数后模型表示能力的差异:
- 线性函数 y=kx+b 给了我们一条条无限延伸的直线。
- 非线性激活函数,比如常用的 ReLU 函数,对这些直线进行截断,将它们的一部分变为0,另一部分等价于一条射线。
- 现在,我们拥有了大量的、可以自由组合的射线。使用另一个线性变换将这些射线巧妙地变形、求和,从而拼接起来,我们就能得到一条折线。
- 而一条拥有足够多拐点的折线,就可以无限地逼近任何我们想要的曲线。
- 将线性函数 y=kx+b 推广到高维的 y = Wx + b,虽然看起来变得抽象了,但是实际上只是从线变成了“超平面”,依然可以用类似的方式逐渐描摹复杂的函数关系。
- 需要注意的是,这里的例子仅针对ReLU激活函数。使用其他非线性激活函数时,对直线的弯折方式不同,可能不那么直观,但本质是一样的:将直线(线性映射)弯折成非线性映射,从而能够跳出“直线的组合还是直线”的漩涡,实现对各种曲线关系的拟合。
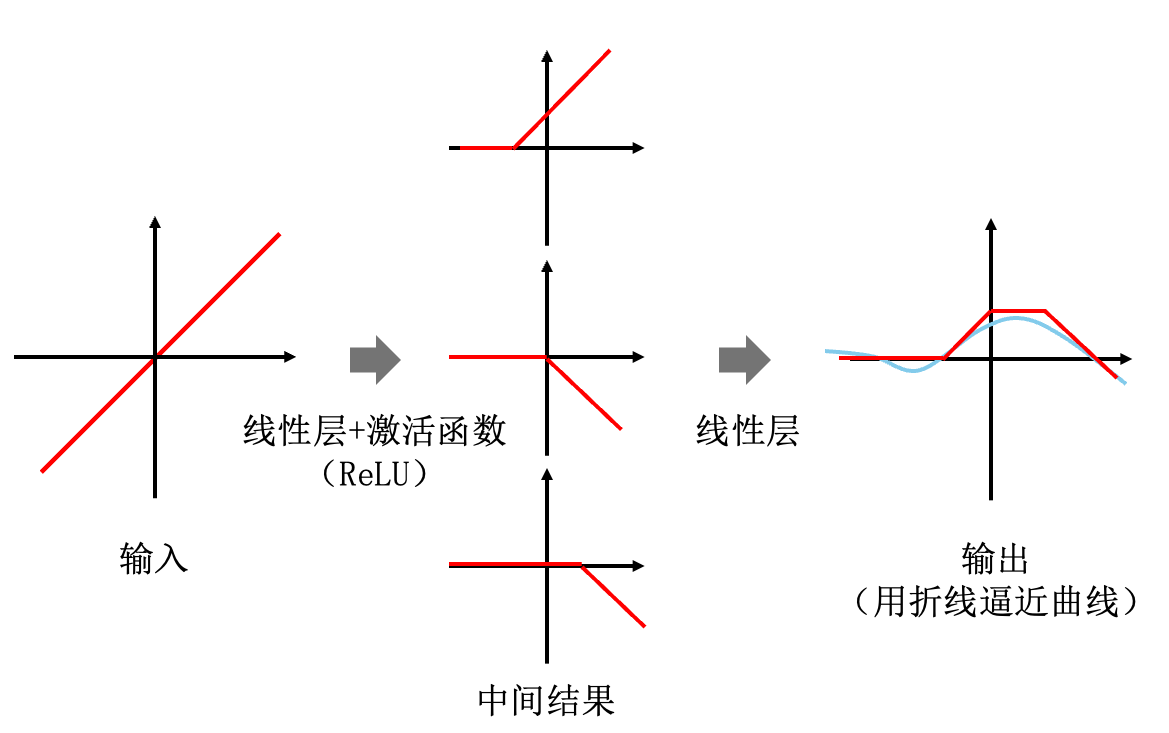
这就是非线性带来的变化,直线的叠加依然是直线,但射线(或者使用其他激活函数时产生的曲线)的组合,可以一笔一笔地近似描绘出曲线,而我们遇到的大多数问题,都不只蕴含线性关系,复杂的问题更是呈现出深刻的非线性关系。
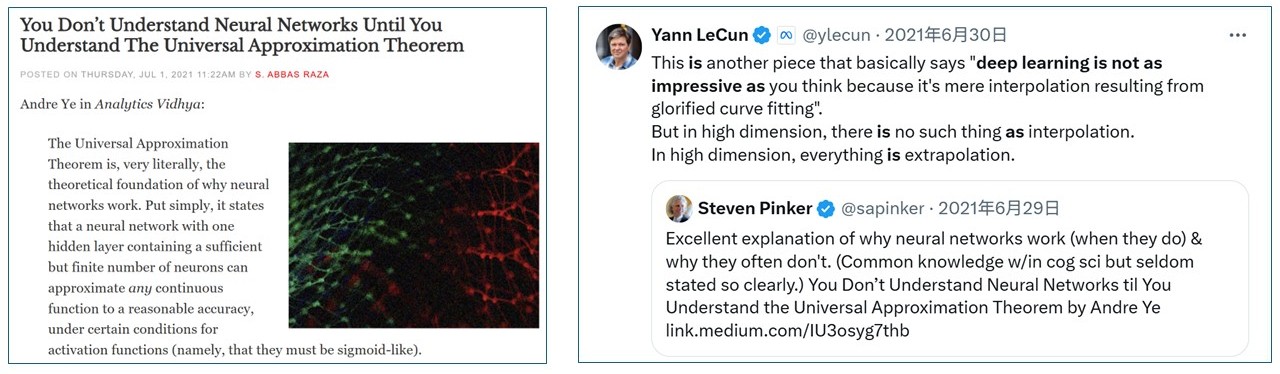
实际上,在“折线描绘曲线”这一简单比喻背后,有一个威力无穷的数学原理——万能近似定理(Universal Approximation Theorem,又译作通用近似定理)。这个定理告诉我们:
理论上,仅包含一个隐藏层的神经网络(即我们介绍的线性层-激活函数-线性层网络),只要我们给予它足够多的神经元(宽度无限,而不是示例中的3个)并使用非线性激活函数,它就拥有了模拟任何复杂连续函数的能力,且可以达到我们想要的任何精度。
当然,宽度无限只是一个美丽的理论。在现实中,不可能使用一个拥有无限参数的线性层,因为计算和存储资源都是有限的。但这并不妨碍MLP成为一个极其有用的基础工具。回到例子里,现实情况无非是,我们能使用的拐点数量变少了。这仅仅意味着,我们的折线对原始曲线的近似效果没有理论上那么完美而已。在大多数情况下,这种足够好的近似已经能出色地完成任务。接受一些无法避免的误差,人生和建模都还是要继续下去的,不是吗?
基于反向传播学习的引擎:模型是如何变聪明的?#
到目前为止,基于这个MLP的静态骨架,希望大家已经理解了它为何有潜力拟合复杂函数。但是,这里还有更重要的一环:这些参数该怎么设定?如果从随机的初始化开始,一个网络该如何通过接触数据,一步步自我调整,最终学会解决问题?
不需要艰深数学知识,这一节中我们可以直观地感受参数是如何互相合作,最终组合成一个强大的引擎,呈现出预测目标能力的。
损失函数(Loss Function):衡量与目标接近程度的记分牌#
首先,模型需要知道自己做得好不好,以及好的标准是什么。我们需要一块记分牌来量化它的表现。那么,我们该如何设计这块记分牌呢?假设我们正在做一个简单的预测任务:根据一系列条件,预测一个目标数值。我们手里的模型给出了它的看法,即预测值,正嗷嗷待哺,等待着我们的反馈:预测得怎么样?需要如何调整?我们手头有这个问题的正确答案,即真实值,我们该怎么通知模型?
我们可以把这个任务转化为一个目标,即给到模型一个“分数”,它的任务是让这个分数尽可能地小。一个最直接的想法,就是计算误差的绝对值,即 |预测值 - 真实值|。假设真实值是10,模型的预测值是8,那么这次的估计错误(通常称为“损失”)就是2。
但我们还可以想得更深一层:一个损失为4的离谱错误,其严重性真的只是一个损失为2错误的两倍吗?或许,我们希望模型对犯下这种重大错误感到极度的恐惧。我们希望更严厉地惩罚那些大的误差。可以通过平方将离谱的错误进一步放大:把“错误分数”定义为 (预测值 - 真实值)²:
- 一个大小为 2 的误差,错误分数是 2^2 = 4。
- 一个大小为 4 的误差,错误分数是 4^2 = 16——严重性变成了 4 倍!
通过平方,这块记分牌就变得对重大失误更敏感,从而迫使模型在学习过程中,优先去避免那些最离谱的预测。
除了平方操作之外,一般而言,我们还会让模型同时对一组数据进行计算,求出它们的平均误差。就这样,将平均和平方操作结合,我们共同设计出了一种在机器学习中极为常用且强大的损失函数。它有一个正式的名字:均方误差(Mean Squared Error, MSE)。它的核心思想,就是通过不成比例地惩罚大误差,来定义一个更合理的学习目标。在MSE之外,针对不同类型的任务,还有各类不同的损失函数。例如,在处理分类问题时,普遍使用交叉熵损失(Cross-Entropy Loss);而不进行平方操作的平均绝对误差(MAE),则在另一些场景下因其对异常值不那么敏感而备受青睐。当然,还有更多针对特定任务设计的复杂损失函数,它们背后的智慧与巧思都等着你的探索。
反向传播:一个逐层传递的指令传达系统#
好了,我们有了一个总目标(让分数变小),但一个网络里有成千上万个参数,到底该调整谁?又该怎么调呢?
这就需要一个高效的指令传达系统。在深度学习中,这个系统就是大名鼎鼎的反向传播。
请不要被这个名字吓到,我们可以极其直观地理解它的功能:它是一个从最终得分出发,层层反推,最终告知网络中每一个参数“你下一步是该变大一点,还是该变小一点”的自动化过程。
想象一个庞大的团队在合作一个项目。老板(优化器)在审查最终结果后,只给出了一个总评价:“不行,这个最终指标离目标差太远(损失值太大)!”
反向传播,就如同一个神奇的内部指令系统,能瞬间将这个模糊的总评价,在每一层分解,并传递给下一层的每一个参与者。这个改进的压力传到每一位小组长那里时,都会发生一个精妙的过程:
-
分析与定策: 首先,小组长查看自己的计划,并根据上级的目标,迅速判断出自己负责的各项数值中,哪些对最终结果的负面影响最大。他心里会形成一个初步的想法:“要让总指标变好,我的A部分数值需要调高,B部分数值需要调低,且调整B的优先级更高。”
-
调整自身: 随后,他根据这个判断,立刻调整自己计划里的A和B数值,这个过程在技术上称为更新参数。
-
向下传达: 小组长心里清楚,自己的计划是建立在下属提交的方案之上的。因此,在调整自己方案的同时,他必须向下属传递更具体的指令,告诉他们如何调整,才能让自己的新方案变得更优。这时,指令就变成了:“嘿,为了让我这里的新方案能达标,你的方案给出的xx数值需要变小一些,这对我的帮助最大!”
-
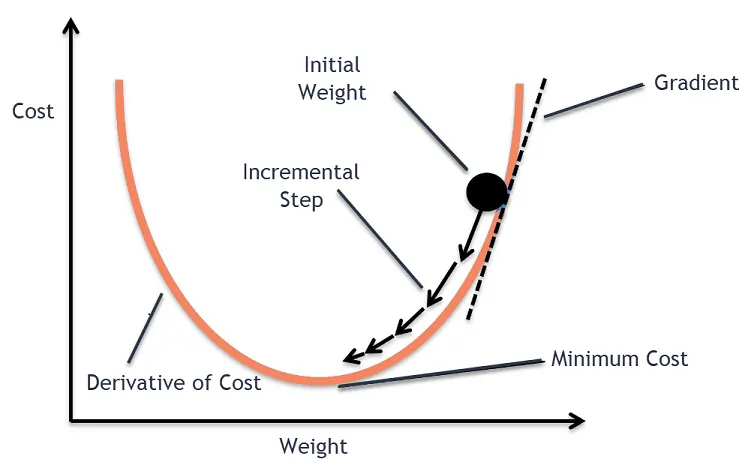
重复调整: 这一轮调整并非一劳永逸,而是持续优化的开始。这正是下图梯度下降(Gradient Descent) 的精髓:整个团队会不断重复“接收反馈、全体微调”的循环,就像一个小球不会一步跳到谷底,而是在每一步都先判断出降低损失的方向(计算梯度),然后朝着该方向滚一小步(更新参数)。通过成千上万次这样的迭代,团队的方案最终会被打磨到接近完美的状态。
一场“反向传播”派对,谁没有收到邀请?#
这个神奇的指令传达系统要想顺利工作,必须遵守一条黄金规则:
网络中所有的计算操作,都必须是可微的(Differentiable)。
上一章提到的小组长,正是通过微分(Differentiation) 这个数学工具,精确地计算自己的微小变动会对最终结果产生什么影响。这个影响的大小和方向,就是斜率,也正是它制定调整策略的依据。
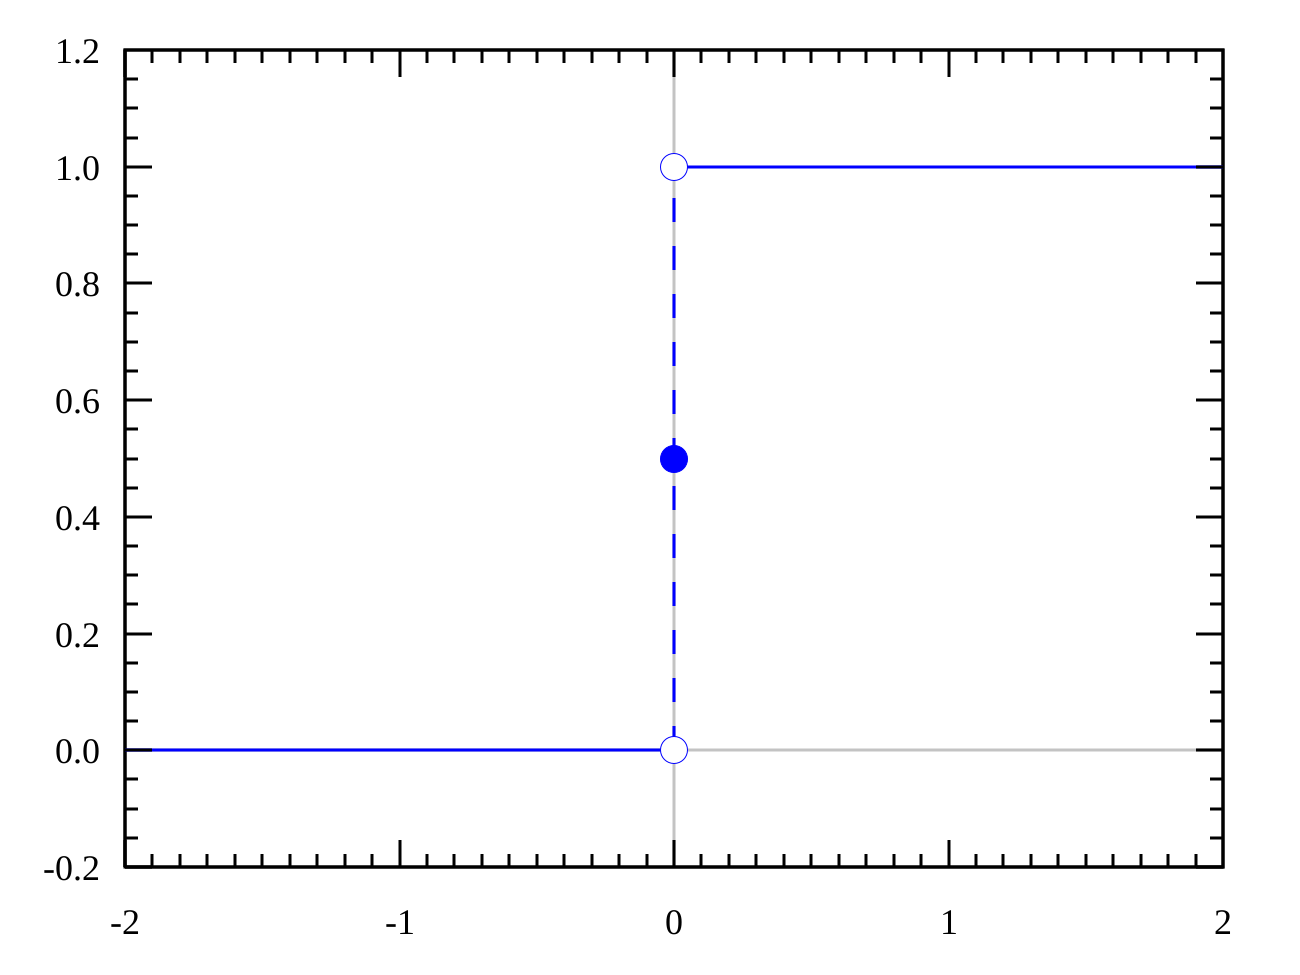
现在,让我们再来看四舍五入这个例子。假设一位“四舍五入”小组长希望使用微分计算自己组内的参数该如何修改,它会发现:
- 在绝大多数情况下,计算出的斜率永远是0。这个数学结果等于在告诉它:“你的任何微调都对最终结果没有丝毫影响。”指令系统因此陷入沉默,完全不知道该往哪走。
- 而在那些极其罕见的临界点(比如在3.5的位置),斜率会瞬间变为无穷大。这个信号过于暴力,足以让整个指令系统直接“宕机”。
因此,四舍五入的问题在于,它提供的反馈要么是无效的静默信号(斜率为零),要么是毁灭性的错误信号(斜率无穷大),导致指令传达系统被完全阻断。
与此形成鲜明对比的是我们常用的 ReLU 激活函数。它对于所有大于零的输入,都提供了一条斜率恒定为1的、通畅的高速公路。这意味着指令总能得到一个清晰、稳定、有效的反馈。虽然信号在小于零的部分会被截断——而它的改进版,如 Leaky ReLU,则更进一步,为这部分也提供了一个极其微小的斜率,确保指令永不失联——关键在于,ReLU家族至少保证了指令有路可走,而四舍五入则把所有的路都堵死了。
这恰恰就是那个初代“感知机”失败的根本原因。它用Heaviside阶跃函数——一个最纯粹的、硬性的“悬崖”作为激活函数,这种设计使得基于梯度的学习方法在当时根本无法实现,直到后来被 Sigmoid、ReLU 等其他更合适的函数所取代,深度学习的火种才被重新点燃。
最后,值得强调的是,这场名为“反向传播”的盛大派对,并非只为MLP这一位嘉宾举办。事实上,它是整个深度学习领域的通用庆典。所有我们未来将要见到的、用于处理图像、声音和文字的更复杂的模型,无论它们外形多么奇特,都渴望获得一张进入这场派对的“邀请函”。而可微性,就是印在每一张邀请函上的、必须遵守的着装要求。理解了这一点就明白了,为何尽管模型架构日新月异,但其背后的学习原理却惊人地统一。
强大,万能,但是还不够#
恭喜你!如果一路跟随到这里,你已经穿越了深度学习最核心、也最容易产生困惑的概念腹地。快速梳理一下:我们认识了作为基础构件的多层感知机(MLP),并理解了它的力量源泉并非来自单一组件,而是来自线性层与非线性激活函数的交替叠加。这个简单的思想,让模型获得了以折线拟合任意曲线的潜力,其背后是强大的万能近似定理。同时,我们为这个模型装配了一个完整的学习引擎:通过设计损失函数来定义“好坏”,利用反向传播来高效地将总误差分配给每一个参数,再借助梯度下降的策略,让模型在数据中一步步地自我完善。而可微性,则是保证这套复杂系统能够运转起来的底层游戏规则。但还有一些问题:明明MLP已经很“万能”,但为什么我们的派对中还有其他来宾?为什么Steven Pinker在推文中提到,万能近似定理的保证下,神经网络仍然“经常不起作用”?
既然一个足够强大的MLP(由“万能近似定理”所保证)能够拟合任意复杂的函数,而世间万物的问题最终都可以归结为复杂的函数关系,那么MLP究竟是不是解决一切问题的终极答案?
——理论上是的。但在实践中,故事却远非如此简单。就像20世纪初的物理学一样,看似完美的理论之上,也漂浮着属于它的“乌云”。在接下来的2.1节,我们会揭晓答案:以图像为例,MLP在强大的理论保证背后,又在实践中遇到了哪些瓶颈。我们将引出为解决这些局限而生的经典结构——卷积神经网络(CNN),并一同见证它如何开启了由ImageNet竞赛引爆的深度学习黄金时代。随后的章节中,我们将进一步探索,看看针对不同类型的问题,深度学习又是如何演化出更多特别的结构。
作者信息与参考来源#
本科毕业于山东大学,现为深圳大学城市空间信息工程系,2023级人工智能专业硕士研究生。
研究方向:GeoAI、Geospatial Data Representation Learning。
本章节由李国隆负责编写,含AI工具辅助(Google Gemini 2.5 Pro),文中所用插图部分来源于网络。
参考来源#
-
Jadon, S. (2018). Introduction to Different Activation Functions for Deep Learning. Medium.
-
Wikipedia. (n.d.). Step Function. Retrieved September 7, 2025.
校稿:黄菲