Wiki Foundations3 Concepts and Frameworks of AI
3.1 卷积神经网络
演化的历史,总在不经意间重复。5亿多年前,寒武纪的生命大爆发,其关键催化剂之一是视觉的诞生。当生命第一次睁开眼睛,一场认知能力的“军备竞赛”随之开启,最终塑造出复杂的大脑。数亿年后,2012年,AlexNet在ImageNet的图像识别挑战中取得突破性胜利,深度学习(当时以计算机视觉为主导)从此站在了聚光灯下,走向自己的“寒武纪时刻”。这似乎是一个横跨数亿年的惊人巧合,视觉成了为点燃“奇点”的火花。
从MLP早已习惯的、那些特征分明且各自为政的结构化数据,一头扎进由高维像素构成的色彩世界,就像爱丽丝掉进了兔子洞——一个原有规则和秩序瞬间失效的奇境。在这里,每一个像素点都像是一个沉默的卡牌士兵,孤立存在时毫无意义,但其排列组合中却隐藏着整个王国的秘密。我们为旧世界打造的精良工具,此刻显得笨拙而无力,因为它们面对的不再是若干清晰的“特征”,而是一片混沌又充满关联的像素海洋。本章,让我们走进奇妙的兔子洞,一起探索卷积神经网络(Convolutional Neural Network, CNN)如何成为早期人工智能“看见”世界的“眼睛”。
卷积神经网络:从视觉神经元到深度学习的开端#
我们在上一章的结尾留下了一个核心问题:既然“万能近似定理”从理论上保证了 MLP 的强大能力,为何它面对图像这类问题时却显得力不从心,需要新的结构进行处理?Ian Goodfellow等人在其经典的《深度学习》一书中直接回答了这个问题:
万能近似定理意味着无论我们试图学习什么函数,我们知道一个大的MLP一定能够表示这个函数。然而,我们不能保证训练算法能够学得这个函数。
怎么理解这个情形?想象这次我们的MLP模型需要回答一个问题:给定的 128 \times 128 图像主体是一朵花,还是其他什么东西?
一个MLP模型需要首先将图像展开为 128 \times 128 = 16384 维,然后对其中的内容从细节开始进行识别与组合——某一搓像素组合形成边缘,一些边缘组合形成花瓣,花瓣按照某种关系组合成花,再配合花茎、花蕊等,模型能够确信,这幅图是一朵花,而不是一棵草或者一只猫。
这个问题本身已经足够复杂了,但除此之外,MLP还需要解决两个困难:
- 相邻的像素按照某种模式排布可能意味着拐角或边缘,而分散在各处的像素有这样的组合可能不意味着什么——模型需要在海量无效的尝试中学习到哪些维度相邻而联系更大,哪些维度的组合意义不大。
- 花瓣之所以是花瓣,主要与这些像素的组合模式有关,与它出现在图的左上角还是右下角关系较小——MLP不同维度的参数没有共享机制,这意味着它需要为图的几乎每一个位置都独立构建起识别能力,哪怕这些识别能力是相似甚至相同的。
这两个困难并非对万能近似定理提出挑战,而是对学习过程提出了挑战——理想情况下,我们应该告诉模型相邻的维度相关性强、同一个识别能力可以复用在不同位置,而不需要它自行学习这个事实。实际上,可以这样表述它们:
- 空间局部性(Locality): 像素间的关系并非是平等的,一个像素的意义主要与其邻近的像素相关。
- 平移对称性(Translational Symmetry): 图像中的一个组合模式,无论出现在哪个位置,它本身的主要含义不会改变。
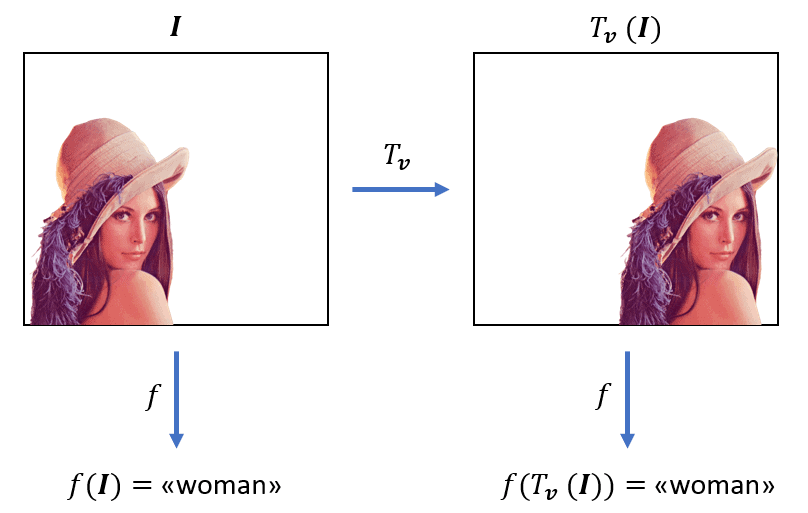
我们用来处理图像的神经网络,其结构得直接回应上面的要求,从而先天地将图像数据的规律注入到模型之中。该怎么做呢?幸运的是,神经生物学几十年前的发现早已为我们指明了方向。
神经生物学研究启发的卷积操作#
神经生物学家大卫·休伯尔(David Hubel)和托尔斯滕·威泽尔(Torsten Wiesel)在20世纪60年代的开创性研究中发现,当猫看到不同物体时,其视觉皮层的神经元会对特定区域的特定模式产生反应(Hubel等,1962)。比如,有的神经元对垂直线条特别敏感,有的则对水平线条更敏感。更有趣的是,这些神经元只关注视野中的一小块区域,而不是整个视野,这种特性被称为“感受野”(Receptive Fields)。这项发现后来为他们赢得了1981年的诺贝尔生理学或医学奖。
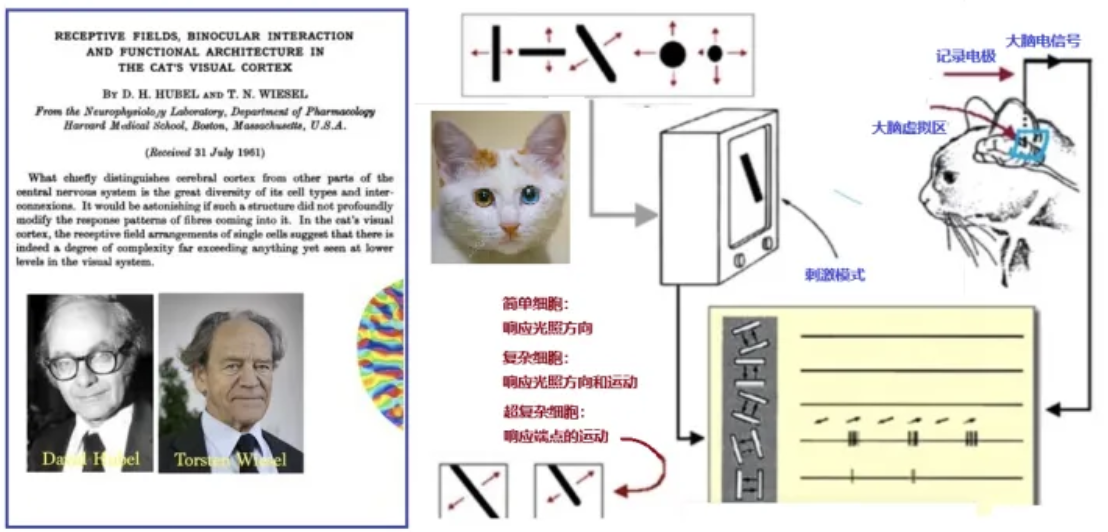
受到这一生物学发现的启发,1989年,杨立昆(Yann LeCun)及其团队首次提出了用于手写字符识别的卷积神经网络(Convolutional Neural Network, CNN)。到1998年,他们开发出了更成熟的LeNet-5模型,这被认为是现代CNN的奠基之作。
CNN的设计巧妙地模仿了生物视觉系统的三个关键特点:
- 局部感受野: 为了匹配图像空间局部性特点,每个神经元只需要关注图像的一小块区域,就像我们看图片时也是一块块地观察,而不是一次性处理所有细节。例如,当CNN识别一只猫时,它可能先发现一个毛茸茸的耳朵,再看到胡须,最后才组合成完整的猫脸。
- 权值共享: 为了匹配图像的平移对称性特点,CNN中的同一个特征检测器(称为卷积核,Kernel)可以在图片的不同位置重复使用。就像我们识别猫耳朵的能力不会因为耳朵出现在图片的左上角还是右下角而改变。这大大减少了网络的参数量:原本检测器需要在各个位置都配备一套,现在共用一套就够了。
- 池化操作: CNN会定期对特征图进行压缩,保留重要信息的同时降低数据量。这就像我们看东西时,不需要记住每个细节,而是抓住关键特征。例如,不管猫耳朵是稍微向左还是向右,我们都能认出那是猫耳朵。
这三大创新共同构成了CNN的核心优势,回应了我们在上一节提到的规律。具体而言,局部感受野的设计,使网络得以高效地处理图像的空间局部信息;权值共享通过在各个位置复用卷积核,则将模型的参数量按照数量级尺度降低;而池化操作则通过保留关键特征,进一步增强了网络对物体微小位移、形变的抗干扰能力。
正是这样的设计,让CNN特别擅长处理具有空间特征的数据。它不仅能“看懂”图片,还能像生物视觉系统一样,逐层学习从简单到复杂的特征。基于这样的启发和探索,CNN极大地拓宽了神经网络的能力范围,并带来了象征着深度学习诞生的魔幻时刻。
1. LeNet-5#
LeNet-5由Yann LeCun团队在1998年提出,其主要设计目标是解决手写数字识别任务。相较于我们上一章提到过的MLP结构,LeNet-5可以视作“卷积特征提取器 + MLP决策器”,其中“卷积特征提取器”结合局部感受野、权值共享、池化操作,有效地将图像中的信息压缩为相对简洁的向量表示,从而MLP不再需要直面复杂的图像数据,可以专心进行决策。
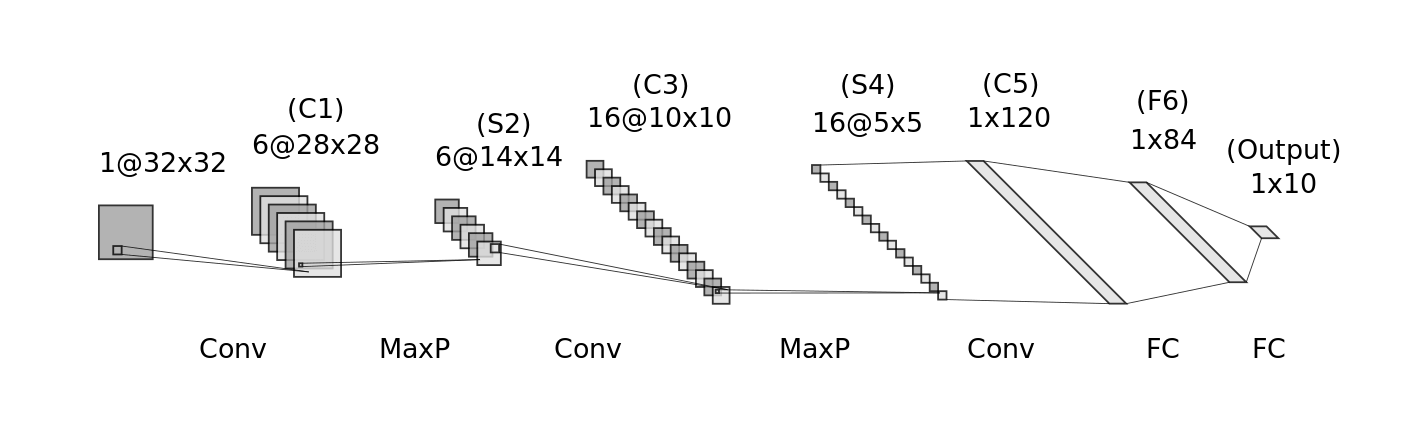
值得一提的是,LeNet-5并非纯粹的学术模型。作为第一个被投入大规模商业应用的CNN,它在90年代曾成功帮助银行识别了海量手写支票,是神经网络在早期商业化的一次成功尝试。然而,在那个更青睐传统机器学习方法的时代,LeNet-5的成功并未立刻引发该领域的广泛跟进。在证明了CNN的潜力之后,这一技术路线在十余年间未得到充分发展,直到2012年,这一局面迎来了决定性的转折……
2. AlexNet:一个时代的交汇点#
从2009年起,由李飞飞团队发起的ImageNet大规模视觉识别挑战赛(ILSVRC),因其巨大的数据规模和挑战难度,成为了评估计算机视觉算法性能的权威基准。该竞赛要求算法将数百万张真实世界的照片,准确分类到1000个不同的类别中,这与LeNet-5面对的10个手写数字相比,复杂性呈指数级增长。
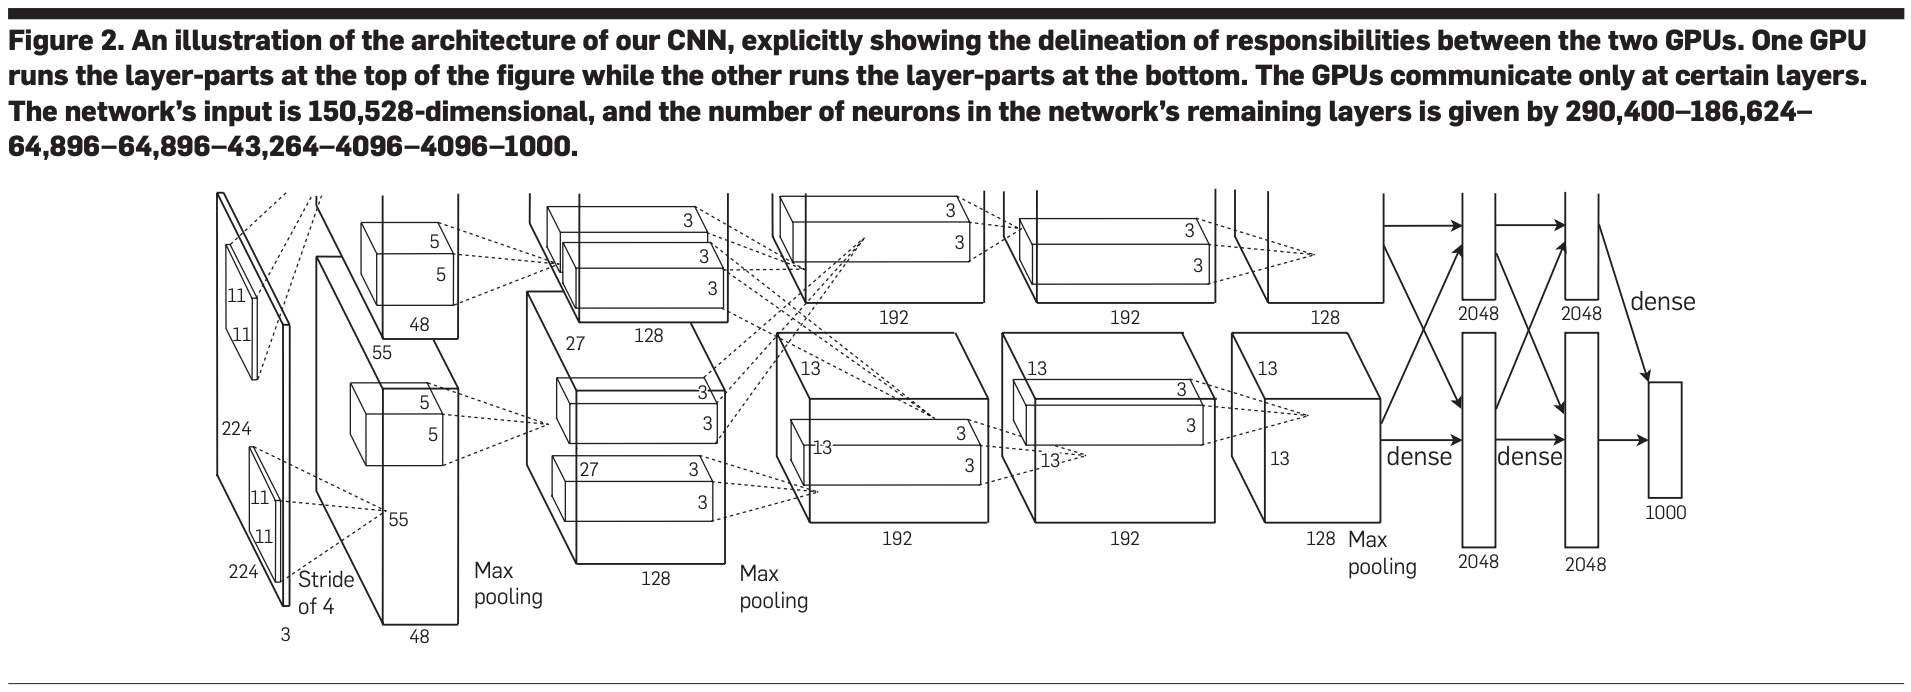
在2012年的竞赛中,AlexNet登场了!它沿袭了LeNet-5开创的CNN思想,但构建了一个更深的网络结构(5个卷积层和3个全连接层),以应对ImageNet更复杂的任务。其竞赛结果产生了决定性的影响:AlexNet的Top-5错误率仅为15.3%,而使用传统方法的第二名高达26.2%。如此显著的性能优势,证明了深度学习方法在复杂视觉识别任务上的潜力。
AlexNet的胜利首先是CNN架构的胜利。AlexNet的战绩证明,LeNet所奠定的“卷积特征提取器 + MLP决策器”这一设计范式,在扩展到更大规模和更深层次后,依然是解决复杂图像问题的正确答案。
然而,AlexNet的特殊意义远不止于此。它的成功,是多个关键因素共同作用的结果,标志着现代深度学习研究范式的正式确立。除了更深的CNN架构,AlexNet还将主要用于图形渲染的GPU创新性地用于神经网络计算,为训练更大、更深的模型提供了前所未有的算力支持。
同时,它的成功也离不开一系列关键训练技巧的成熟与应用:它使用了ReLU激活函数以加速训练,并引入了Dropout正则化技术以防止模型过拟合。不可忽视的是,ImageNet的大规模开源数据在这里起到了决定性的驱动作用。它不仅为模型的训练提供了海量的“养料”,更重要的是,它验证并确立了“数据驱动”(Data-Driven)这一深度学习研究的核心方法。
那么,让我们将目光拉回到CNN本身,先看看它具体用了什么组件来回应图像数据的需求。
CNN架构剖析:两大核心模块的协同#
从生物学的第一性原理出发,我们理解了CNN为何要那样设计。现在,我们将切换到工程师的视角,像解剖一台精密的机器一样,看看这些思想在实践中,如何通过具体的组件,协同组成一条从像素到洞察的高效流水线。
在许多经典的教科书或教程中,一个CNN常被描述为由“输入层”、“卷积层”、“池化层”、“全连接层”和“输出层”等一系列部件串联而成。这套命名体系诞生于CNN研究的早期,当时为了凸显其与传统MLP的巨大差异,研究者们为这些新出现的图像处理组件赋予了独特的名称。
然而,在深度学习模块化思想日益普及的今天,这套历史命名反而容易造成不必要的困惑。例如,“输入层”和“输出层”的叫法,只描述了它们在流程中的位置,却没有体现其计算本质——前者实际上是未经处理的原始数据,而后者通常只是分类器的最后的线性变换和概率化步骤。
同样,“全连接层”这个名字,过分强调了它与“局部连接”的卷积层的差异,反而掩盖了它的真实身份——我们早已熟知的、负责最终决策的MLP模块。这种基于历史惯例的命名,割裂了CNN作为一个完整系统的功能逻辑,可能不再适用于现在。
因此,让我们暂时忘掉这些束缚,采用一种更宏观、也更贴近其功能本质的视角来解构CNN,也就是我们提到过的“卷积特征提取器 + MLP决策器”。
输入数据#
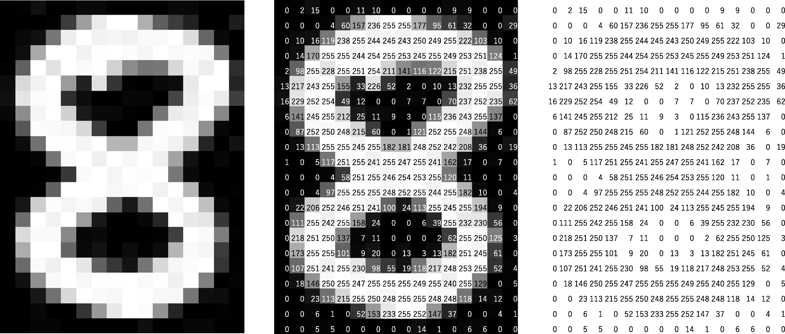
我们这条流水线的起点,是数字化的原始图像。无论是手写数字还是街景照片,在计算机眼中,它们都是由像素值构成的数字矩阵(或称为“张量”),比如一个 28 × 28 × 1 的灰度图矩阵。这便是我们即将加工的原材料。
卷积特征提取器#
这是CNN的灵魂所在。它的唯一使命,就是将原始的像素矩阵加工成一个包含了丰富高级信息的特征向量(Feature Vector)。这个模块主要由两种可重复堆叠的组件构成:
1. 卷积组件(Convolutional Component)
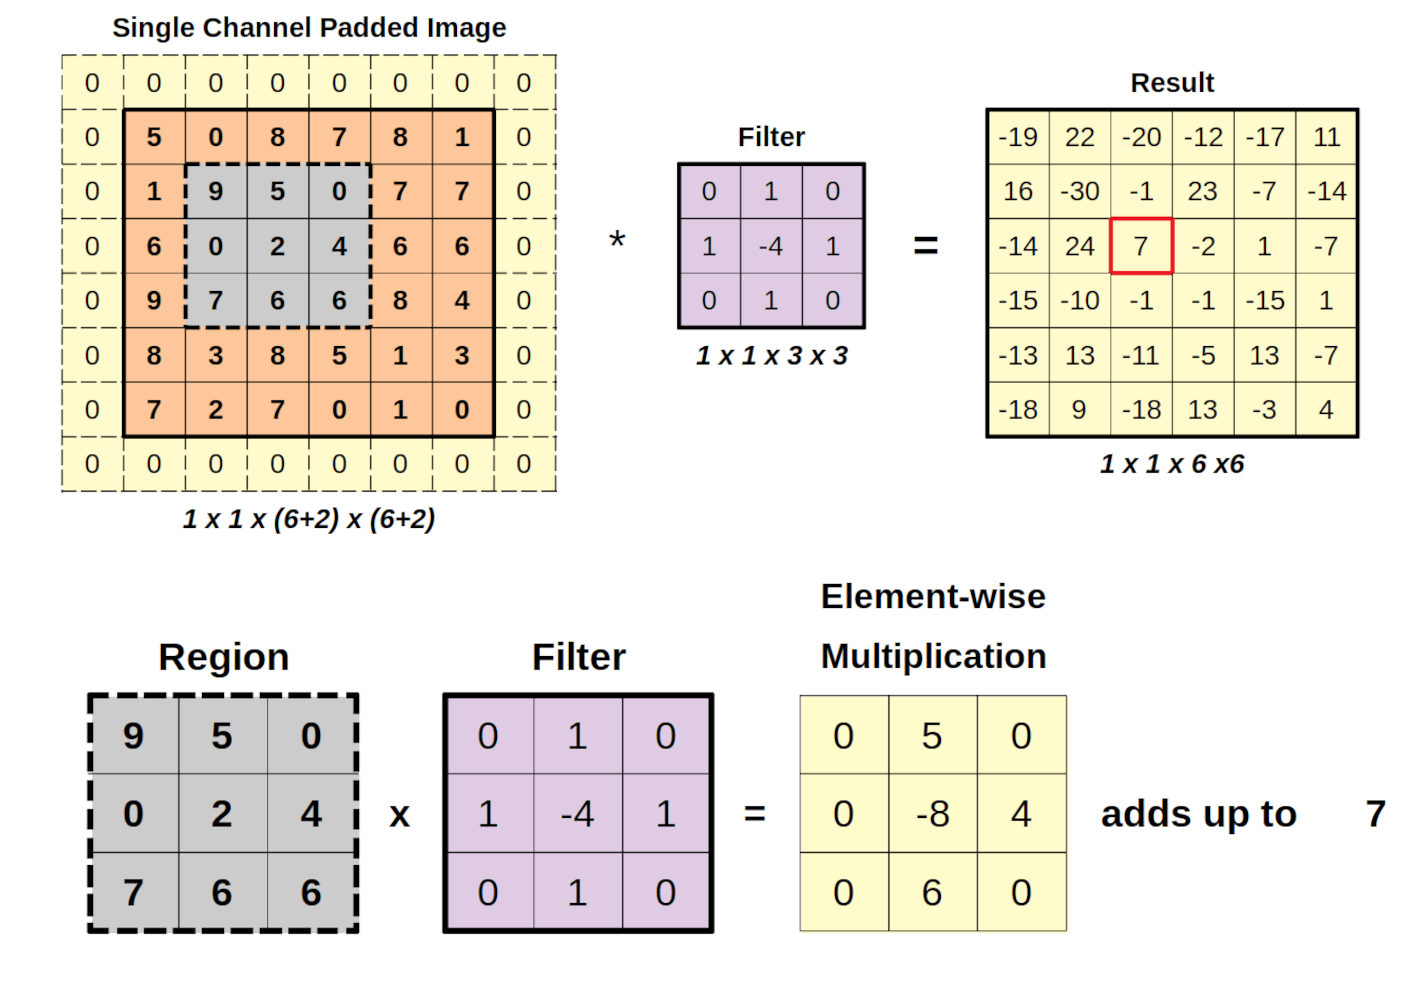
这是特征提取的绝对主力。它通过多个小型的、共享的局部模式探测器(即卷积核Kernel/Filter),在图像上滑动扫描,以识别出边缘、角点、纹理等基础模式,并生成一系列特征图(Feature Map)。
2. 池化组件(Pooling Component)
这是特征提取的得力助手。它通过对特征图进行“智能压缩”(如最大池化),保留下最显著的特征信号,同时减少数据量,并赋予模型对物体微小位移和形变的宽容度(鲁棒性)。
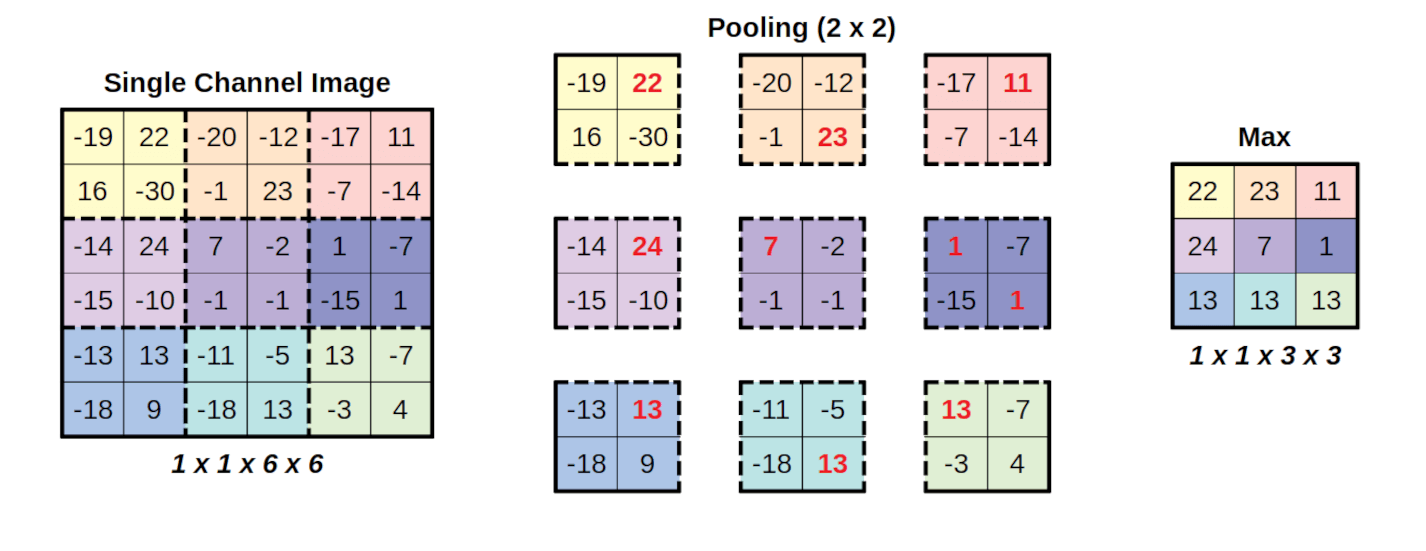
真正的魔法,在于堆叠本身所涌现出的力量。当我们将这些相对简单的“卷积-池化”模块一次次地堆叠起来时,一种奇妙的层次依赖现象便诞生了:
- 浅层的卷积组件,可能只能识别出基础的“边缘”和“短线”。
- 中层的卷积组件,则能将它们组合成“圆弧”或“拐角”。
- 深层的卷积组件,则能将“圆弧”和“拐角”进一步组合成物体的某个部件,比如一个“闭合的圆环”。
这种核心组件的堆叠数量,被称为网络的深度(Depth)。通过层层深入的雕琢,特征提取器最终输出一整套高度抽象、包含了丰富信息的半成品向量表示,为后续的决策提供依据。
MLP决策器#
当特征提取器完成了它的分析工作,这个高度抽象的特征向量就被传递给了我们的老朋友——MLP决策器。它的任务非常纯粹:接收特征提取器送来的“分析报告”,并基于这些高级特征,学习如何做出最终的判断。
以数字分类为例,特征提取器递交的报告写着:“我在这张图的上半部分,识别出了一个‘闭合圆环’的特征;在下半部分,也识别出了一个‘闭合圆环’的特征……” MLP分类器在阅读这份报告后,将发挥它最擅长的特征解读能力,进行综合判断,并输出一个代表着各个类别“可能性得分”的打分向量(Logits)。
例如,它可能会在代表数字8的那个神经元上,给出一个非常高的分数。
概率化输出#
MLP给出的打分虽然能体现各类别的相对可能性,但不够直观。如果6和8分别是46、58分,那意味着什么?为了回答这个问题,我们通常会在最后应用一个独立的Softmax函数。它的功能是将原始的、任意范围的分数,转化为一个总和为1的、清晰的概率分布。
例如,模型最终会告诉你:“我认为这个数字是‘8’的概率是98%,是‘6’的概率是1%……因此,最终判断它是8。”
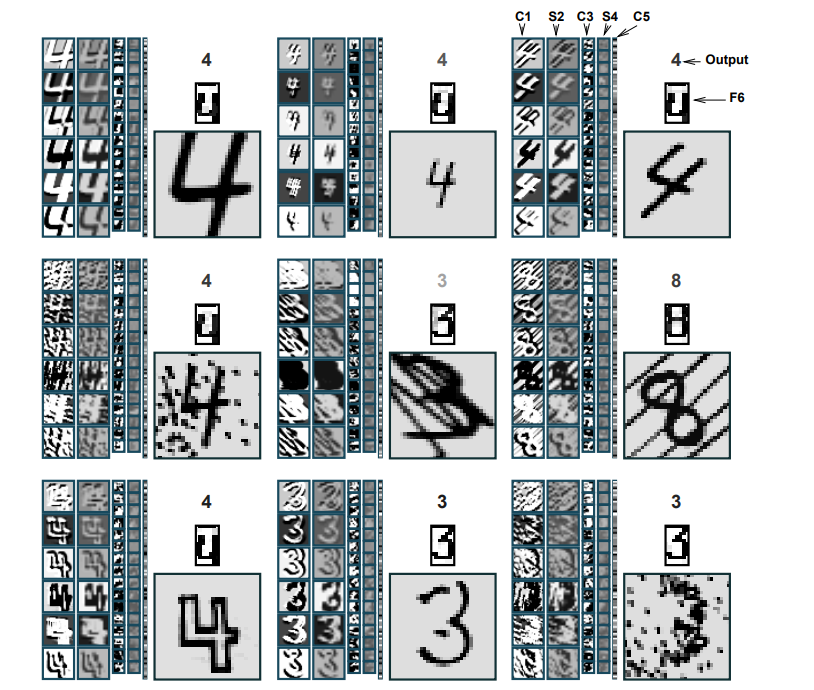
现在,你已经了解CNN模型的基础结构和运作方式。但正如前文所提及的,AlexNet能在ImageNet这样包含上千个类别的大规模图像分类任务中表现出色,很大一部分功劳归结于数据量级、网络规模(宽度和深度)、以及计算能力的巨大飞跃。
有趣的是,站在今天的大模型时代回看,同样是互联网上的海量文本以及千亿级模型参数造就了ChatGPT,规模法则(Scaling Law)之下涌现出的“智能”。
然而,在AlexNet刚刚崭露头角的年代,深度学习的基础设施尚不完备,如何有效训练一个“更深,参数量更大”的网络,其理论和方法都远未明确。当时的研究者们不禁抛出疑问,我们是否可以比AlexNet更进一步?是否有可能通过不断加深网络,最终触及图像数据的“真谛”?
VGG和ResNet:一场“深度”探索之旅#
在AlexNet之后,研究者们将“增加网络深度”确立为提升模型性能的核心方向之一,对深度网络架构展开了集中探索。在这之中,VGG和ResNet的出现,为如何构建和训练深度CNN提供了关键的方法论。
1. VGG:模块化深度的系统性尝试#
在AlexNet之后,牛津大学的VGG(Visual Geometry Group,视觉几何组)团队选择了一条直接且规整的道路来探索深度。VGG的设计哲学是简洁与统一,它证明了仅通过连续堆叠小尺寸(3×3)的卷积核这种标准化的“积木块”,加上深度,就能构建出非常强大的网络。这种优雅的模块化思想至今仍是许多网络设计的基础。
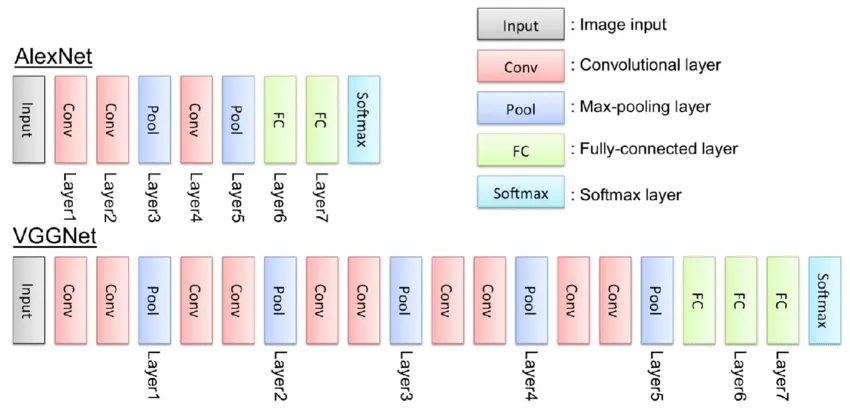
VGG的结构在2014年的ImageNet竞赛中取得了巨大成功。然而它最大的贡献或许在于揭示了“深度”的瓶颈。当研究者们尝试将VGG的结构堆到更深时(例如超过20层),一种令人费解的网络退化现象出现了:更深的网络表现反而比相对较浅的网络更差。
这并非简单的过拟合,而是深度本身带来了训练上的根本性困难。VGG的实践清晰地将这个矛盾摆在了所有研究者面前。
2. ResNet:解决深度训练的结构性创新#
VGG所遇到的网络退化问题,其背后一个主要原因是梯度消失。在我们之前讨论的指令传达系统(反向传播)中,当网络层数过多,从终点传回起点的指令信号会逐层衰减,导致起始部分的网络层无法得到有效更新。
面对这个难题,当时还在微软亚洲研究院的何恺明团队提出了一个创新的解决方案:ResNet(Residual Neural Network,残差神经网络)。
他们认为,让一个网络层去学习一个全新的、复杂的变换(从输入A到输出B)是困难的;但如果让它去学习一个微小的修正量(即A和B之间的“残差”),则要容易得多。
为了实现这个学习修正量的思想,ResNet引入了跳跃连接。它创建了一条直接通道,将前一层的输入原封不动地“跳”过中间层,并与下一层的输出相加。这条直接通道,保证了信息和梯度可以无损地在网络中前后流动,从而缓解了深度网络中的梯度消失和退化问题。
在这里,我们有必要澄清一个重要的概念:ResNet本身并非一种全新的卷积神经网络,其核心创新——“跳跃连接”(Skip Connection)——也并非CNN的专属结构。它是一种更具普适性的、可以应用于多种神经网络的通用架构思想。然而,正是这个通用的思想,在当时被巧妙地应用于深度卷积网络之上,才一举解决了困扰整个领域的“深度诅咒”。
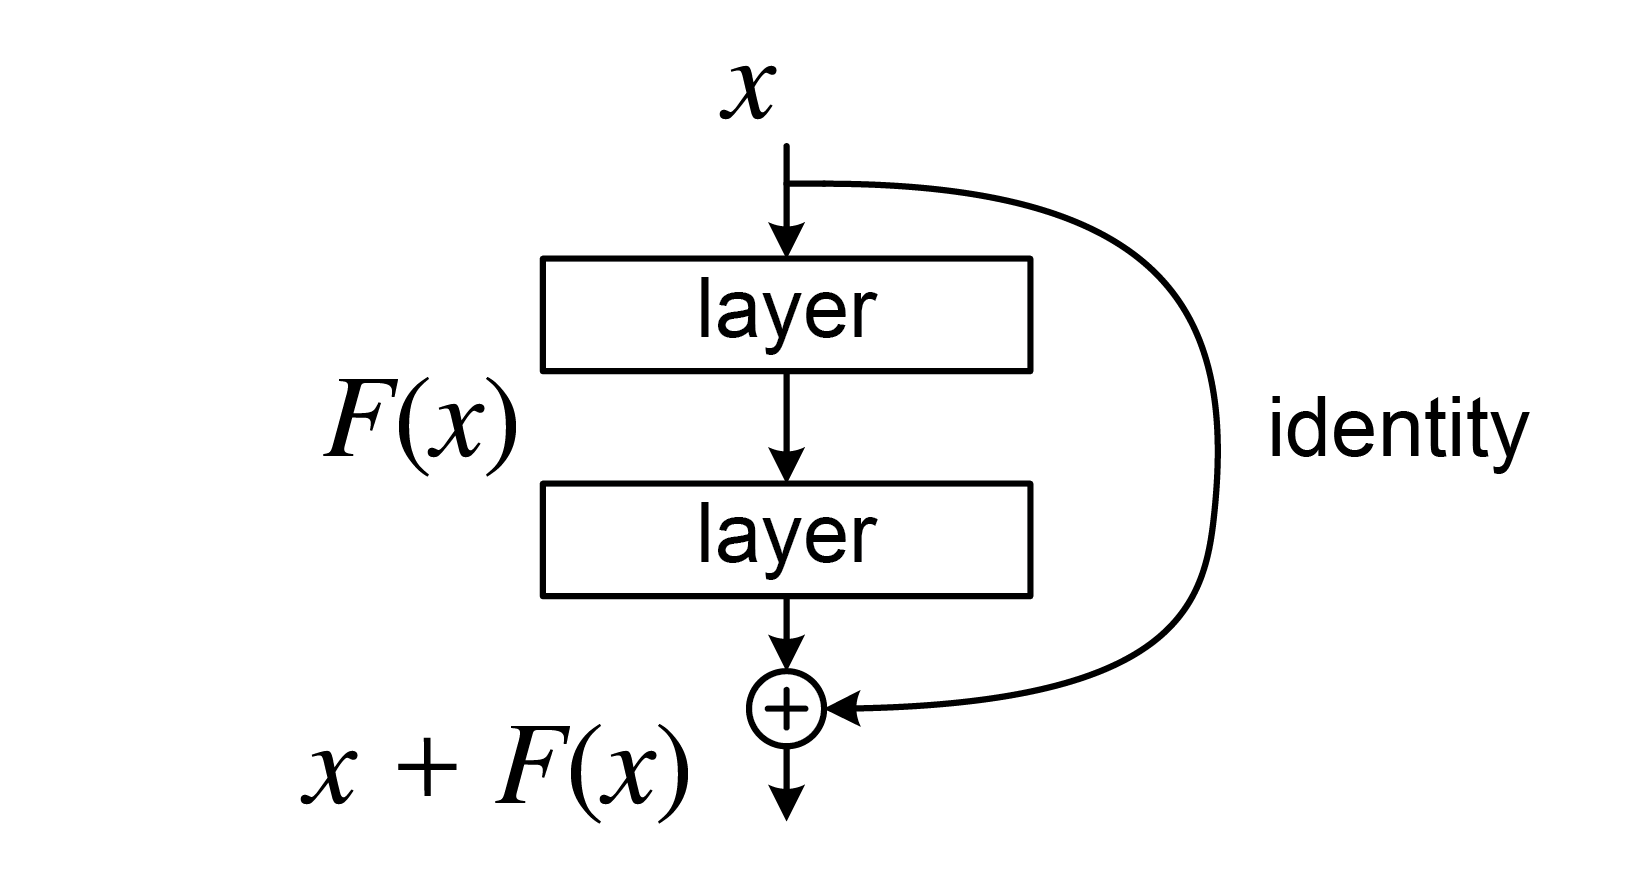
ResNet的诞生,打破了网络深度的限制,使得构建上百乃至上千层的超深网络成为了可能。它没有停留在简单地增加层数,而是从根本上回答了“如何有效构建深度”的问题。
VGG的探索定义了问题,而ResNet的智慧给出了答案,这两者的对话,构成了深度学习架构演进史中的关键篇章。
CNN的边界与新的地平线#
到这里,我们已经走过了深度学习发端的关键旅程:从MLP的“万能拟合”理论,到CNN对图像数据的精妙适配,再到通过加深网络来探索性能的极限。与我们日常接触的计算方法相比,这套体系已经足够,甚至可以说是过分复杂了。
然而,旅程已经结束了吗?哪怕只限定于图像问题,我们手中的“利器”——深度卷积神经网络——就真的无懈可击了吗?不知是幸运还是不幸,答案是否定的。当我们站在更高的山峰回望时,会发现前方的地平线上浮现出新的挑战,这促使我们提出几个根本性的问题:
1. 关于“视野”的局限性
CNN的基石是局部性原理——它假设相邻像素的关系最为重要。卷积核就像一个探照灯,其大小决定了视野范围,而网络的深度则让这些局部视野层层叠加,最终“看”到整张图。
但这引出了一个问题:“局部”的边界在哪里?猫的头和尾巴在像素上相距甚远,但在概念上却紧密相连。CNN这种固守于局部邻域的设计,是否会成为它理解这类长距离依赖关系的天然桎梏?如果我们能设计一种机制,让模型自主学习在何处聚焦局部细节、又在何处建立全局联系,它是否能获得超越固定卷积的、更强大的视觉理解能力?
2. 关于“时间”的缺席
CNN的战场是空间,它擅长解析像素在二维平面上的布局。然而,世界并非静止。如果我们的数据本身就带有时序性,例如一段视频、一段语音或一串文字,这时时间维度便成了主角。
像素的排列顺序决定了一张图片,而单词的排列顺序则决定了一句话的含义。面对这种序列数据,仅仅依靠MLP进行孤立的判断,或是用CNN来处理固定的“时间窗口”,是否会丢失信息流动的关键上下文?是否需要一种全新的结构,一种能够记忆过去并预测未来的网络,来专门应对时间的挑战?
3. 关于“领域”的差异性
即便同为图像,其内在特性也千差万别。LeNet-5处理的是结构单一的手写数字,ImageNet包含的是千万张自然图像,而地理空间分析面对的则是具有独特尺度和纹理的街景与遥感影像。
我们能否用一套统一的CNN架构来应对所有挑战?还是说,不同领域的图像数据呼唤着更具针对性的模型设计?
对于第三个问题,我们将在下一节进行详细的解读。至于前两个悬念——关于空间上的全局视野和时间上的记忆与预测能力——让我们在后续更加激动人心的章节中寻找答案。
CNN在空间数据处理中的应用#
在深度学习快速发展的浪潮中,CNN可以说是地理空间数据分析迈入深度学习时代的起点。它在遥感和街景影像等典型的图像类空间数据处理任务中率先展现出巨大潜力,不仅显著提升了遥感和街景图像的处理精度,也促使学界开始思考:地理空间数据是否应区别于计算机视觉中的自然图像,发展出更符合空间数据特性的图像处理方法?
接下来,我们以两类重要的图像类空间数据为例,介绍CNN在空间数据处理中的典型应用。
CNN在街景影像处理中的应用#
在日常生活中,我们常见的以单一物体为主的图片,比如一只猫、一朵花或一辆汽车,这类图片通常只关注“是什么”,即物体本身的外观特征。
街景影像同样来自“人眼视角”,但内容不再局限于单一对象,而是整个城市场景:道路、建筑、树木、车辆、行人等同时出现,由装着相机的汽车或行人拍摄,记录下街道及街道两侧的真实影像。
在处理街景影像时,不仅要识别其中的元素,还要理解它们之间的空间关系。
例如,同样是一辆车,停在路边和行驶在车道上所承载的语义就不同;同样是一栋楼,面向马路还是背街小巷,对街道氛围的影响也大相径庭。
一张街景图里,行人走在人行道上、自行车停放在路边、街道两边商铺林立,这些组合让人立刻感受到这是一个繁华的街区。
CNN擅长从街景图像的复杂像素里“拆场景”,把原本杂乱的画面转成可计算的要素与指标,从而支持公共空间规划与城市治理等领域的研究与实践。
看见“有什么”——目标检测#
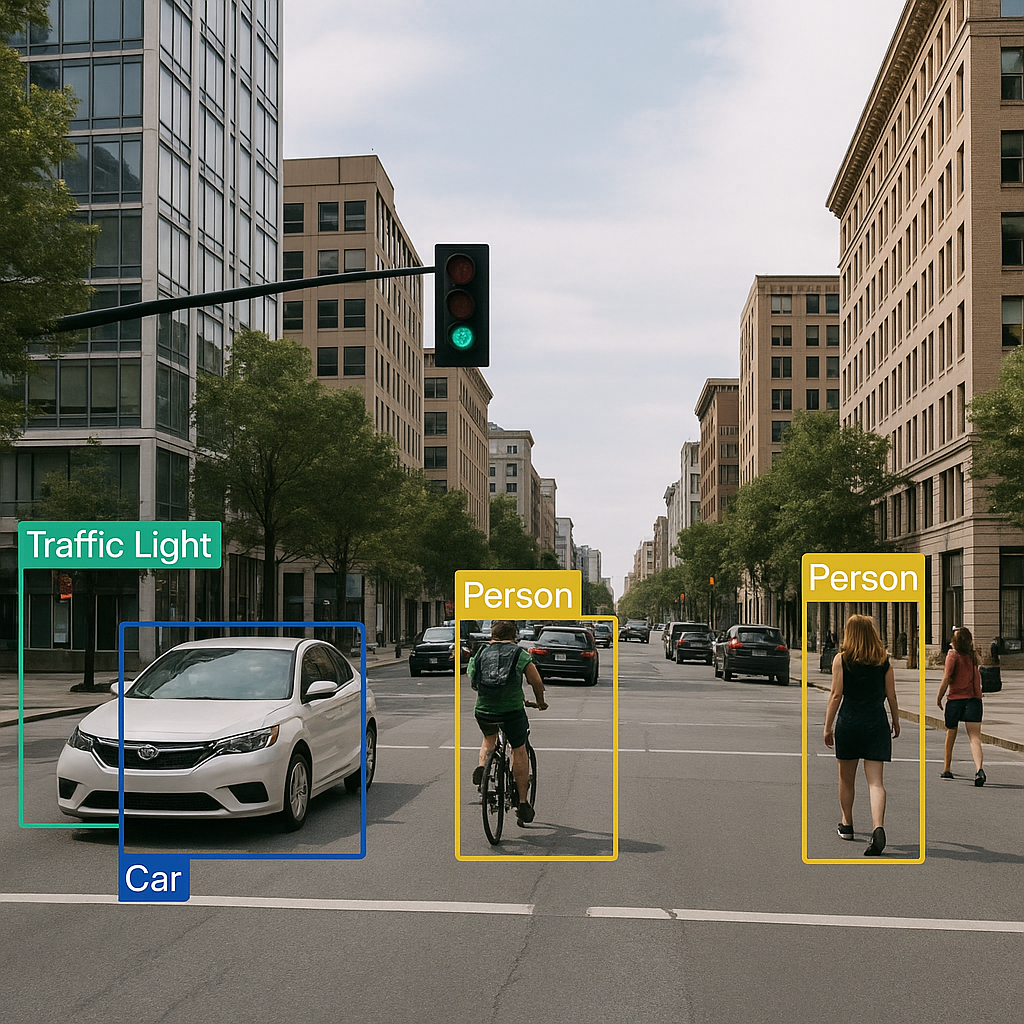
街景影像处理最基础的任务,就是看清楚画面里“有什么东西”,即目标检测。这就像我们走在街道上,会自然分辨出“这里有车、有人、还有一盏路灯”。
借助CNN模型(例如,经典的YOLO模型),计算机可以自动识别街景影像中的各种元素,例如车辆、行人、红绿灯、路牌等,并把它们一个个“框”出来(图左)。这样原本杂乱的街景画面,就被转化成了一份详细的“物品清单”。
这些结果不仅能帮我们统计交通流量,还能用于监测人行道是否畅通、评估街道的安全性,甚至为自动驾驶提供实时感知能力。
看清“哪里是哪里”——语义分割#
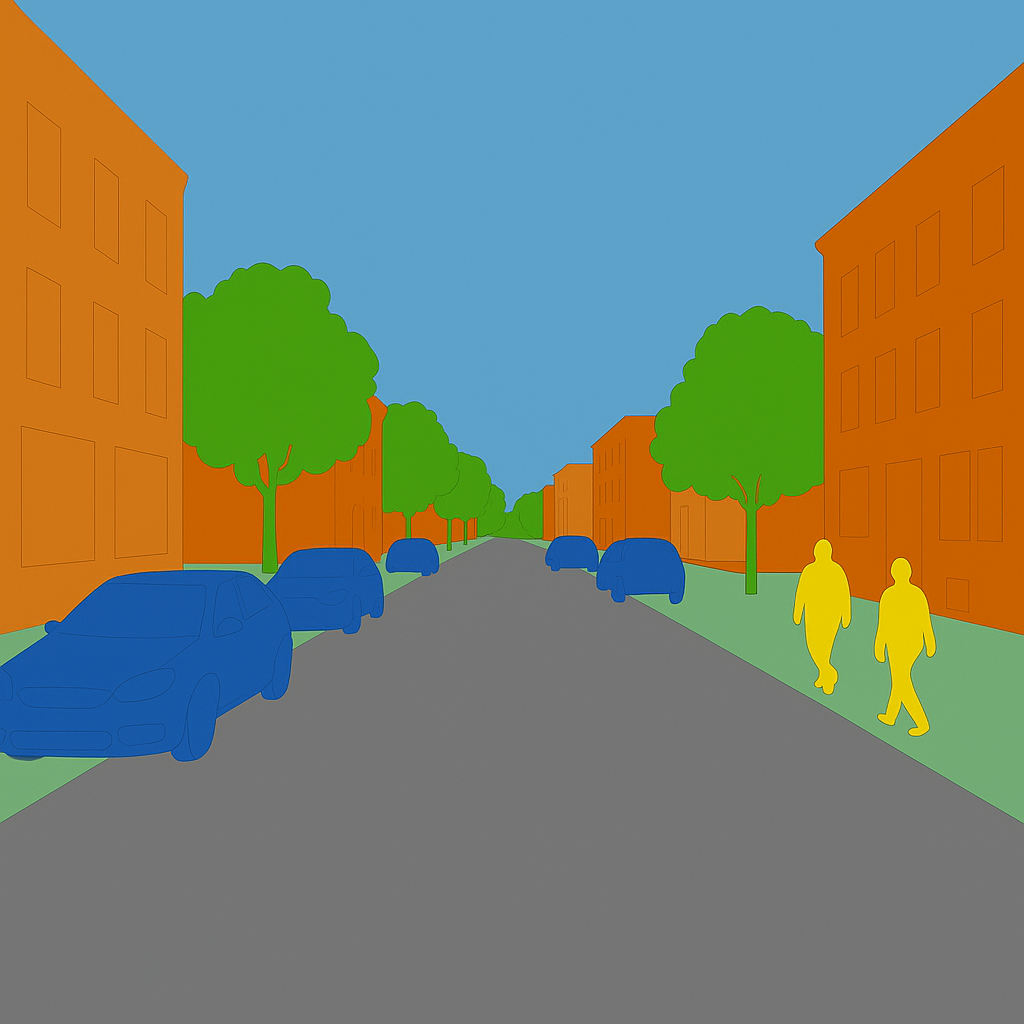
如果说目标检测是在“数清楚街上有哪些东西”,那么语义分割就是在“给街道涂色”,清晰地画出“道路的边界在哪里”。
借助CNN模型(例如,经典的U-Net模型),街景影像中的每一个像素都会被分类成道路、人行道、建筑、天空或植被等类别(图右),结果是一幅高精度的“城市语义地图”。这幅地图能帮助我们直接计算道路的连通性、人行道的无障碍连续性、街道的绿化覆盖率等。
语义分割只能区分类别,但不能区分同类中的不同个体。比如,街道上两辆车都会被标注为“车辆”,但无法区分哪一辆是A,哪一辆是B。
为了解决这一问题,就需要进一步的实例分割。它不仅对像素进行分类,还能进一步区分同类别下的不同个体,可以理解为,实例分割结合了目标检测的“区分个体”能力与语义分割的“像素级精细分类”能力。这使得街景分析更加精细,也能更好地服务于交通监控和自动驾驶等应用。
值得一提的是,Meta AI于2023年开源了通用分割模型 Segment Anything Model(SAM)。SAM展现了惊人的“万物分割”能力,理论上它可以从图像分割并识别出任何一个对象或区域,无论是常见的车辆、行人,还是不规则的树冠、天空,甚至是地砖的缝隙。
此外,SAM在动态的空间深度/距离估计方面也展现出优异的性能。SAM官网提供了在线 Demo,读者也可自己上传图片体验一番“分割万物”。
当然,在惊叹SAM的同时,我们或许也需要思考,计算机领域已经开发出如此强大的模型,能够准确、通用地识别和分割出街景甚至遥感影像中的物体,接下来我们应该做些什么呢?
理解几何与空间关系#
目标检测能告诉我们“街上有什么”,语义分割能进一步划分“哪里是哪里”。但仅仅知道“有车有路”还不够,我们还想知道“车和路的关系是什么”。这就需要理解空间关系。
理解空间关系的关键,在于把街景看作一个立体的场景,而不仅仅是一张平面的照片。比如,同样是一辆车,如果出现在机动车道上,就意味着正常行驶;如果停在人行道上,就代表着潜在的阻碍与风险。
建筑与道路的组合方式会直接影响街道氛围,高大楼宇紧密围合时,街道往往显得狭窄逼仄;而低矮建筑或开阔的间距,则会带来开敞感和舒适感。
绿化的分布更是如此,头顶有浓密的树荫和两侧的绿带,能显著提升步行的舒适性,而零散的植被往往无法发挥同样的作用。
在技术上,这类分析通常依赖深度估计(从二维图像中推测远近关系)和三维重建(恢复街道的立体几何结构)。借助这些方法,可以计算街道的开敞度、围合度、绿视率等指标。
这些空间关系不仅决定了人们的日常体验,还与交通安全、环境宜居性和公共空间治理紧密相关。因此,理解空间关系是街景影像分析最为核心的地方,它让我们从“街上有什么元素”到“明白这些元素如何共同构成一个城市空间”。
CNN在遥感影像处理中的应用#
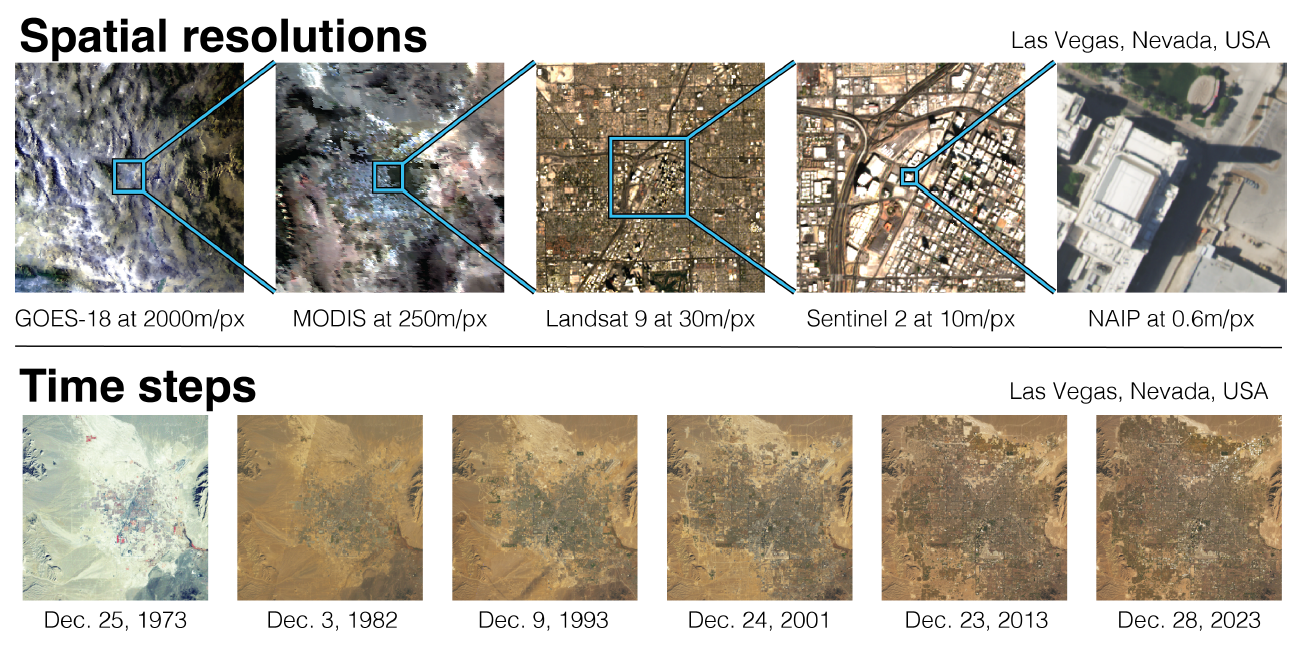
自然图片和街景影像多是近距离的“人眼视角”,而遥感影像多为俯视的“上帝视角”,一景影像往往覆盖从街区到整座城市,甚至数百平方公里的区域。
面对从卫星、航空飞机、无人机等平台拍到的覆盖范围广、尺度跨度大的影像数据,模型要解决的问题,与识别一只猫或一辆车有显著差异。
遥感影像的语义不仅由图像纹理决定,还受光谱与时间信息、以及空间环境的共同约束,例如红树林多分布于热带潮间带,而冰雪覆盖区不会出现在低纬度地区。
因此,深度学习模型在遥感影像处理中的应用经历了一个逐步“空间化”的演进过程,这个过程可以大致概括为:从最初仅凭局部图像特征进行学习,逐步转向利用空间上下文信息隐式地捕捉空间关系,再进一步发展为明确引入地理坐标和空间关系归纳偏置的空间显式模型。
从局部特征学习到空间显式建模#
1. 早期CNN:依赖局部特征的学习
在深度学习刚开始应用到遥感图像处理时,主要依靠局部卷积核提取图像特征。虽然随着网络层数增加,感受野会逐渐扩大,但模型获取的信息仍局限于有限的邻域范围。
在自然图像分类中,这种逐层堆叠的方式能够较好地捕捉局部纹理和形状特征。然而,对于覆盖范围广、结构复杂的遥感影像而言,许多语义并不仅依赖于局部纹理,而是与更大尺度的空间关系密切相关。
受限于有限的感受野,早期CNN往往难以捕捉跨区域的全局依赖,从而导致对空间结构的刻画不完整。
2. 利用更丰富的空间上下文信息:像素级语义分割与多尺度建模
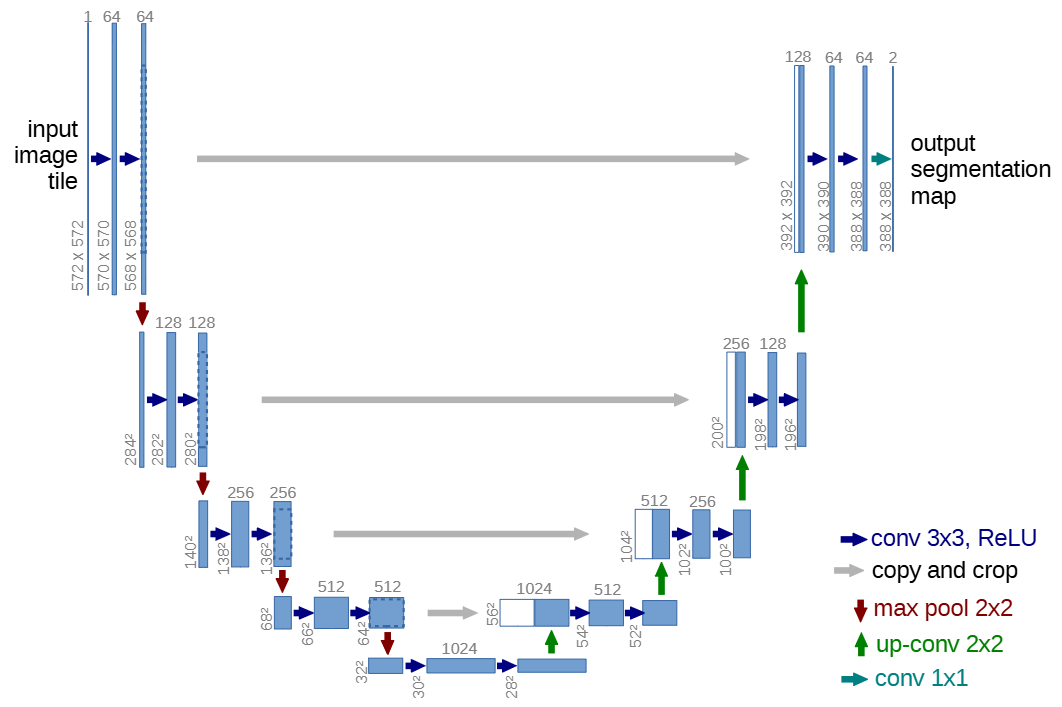
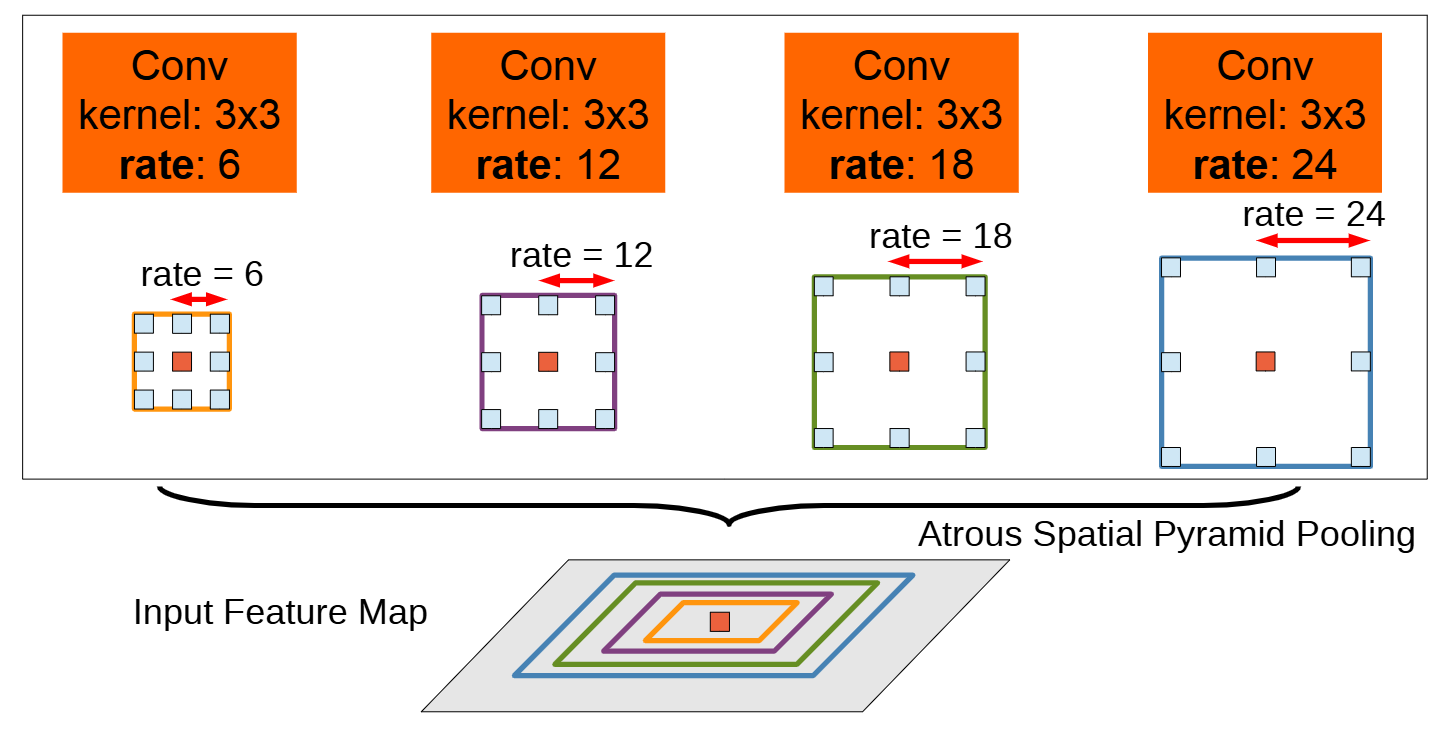
通过多尺度特征融合和扩大感受野来捕捉更大范围的空间信息。典型代表是U-Net,其编码器—解码器结构与跳跃连接结合了局部细节和整体语义(图左);DeepLab则利用空洞卷积和空间金字塔池化,在不同尺度上同时观察场景(图右)。
这些方法让模型不再局限于“放大镜式”的局部观察,而是好比同时具备了“微距镜头”和“广角镜头”,从而更完整地捕捉多尺度空间语义。
不过,这一阶段的空间关系仍然是隐式学习的,模型能区分建筑和道路,但还无法显式理解它们之间的地理联系,例如连通性或地形约束。
3. 把地理知识显式融入模型
随着遥感影像处理任务的逐渐复杂,大家开始意识到,深度学习模型要真正适用于遥感,还需要“理解空间”。换句话说,结果不仅要“看上去准确”,更要“在空间上合理”,例如河流不能随意中断,道路应当保持连通。
在CNN的输入中拼接地理先验特征通道,是“把地理知识融入模型”的早期探索。例如,在输入影像的RGB或多光谱通道之外,拼接经纬度坐标,使网络能够利用绝对位置来学习地物的分布模式。
除了绝对位置之外,还引入地形特征(数字高程、坡度、坡向),以及预先计算的空间关系栅格(如到道路、河流、海岸线或居民点的距离)。
这样,模型不仅依赖图像的光谱与纹理模式,还能够利用地理空间约束来改进预测。
由于卷积本质上依赖局部感受野,它在建模长距离依赖和拓扑关系时存在固有局限。正是这些局限,推动了研究者不断探索新的方法,从图卷积神经网络,到注意力机制,逐渐形成了更丰富的架构体系。(关于图卷积、注意力机制,请参考后续章节……)
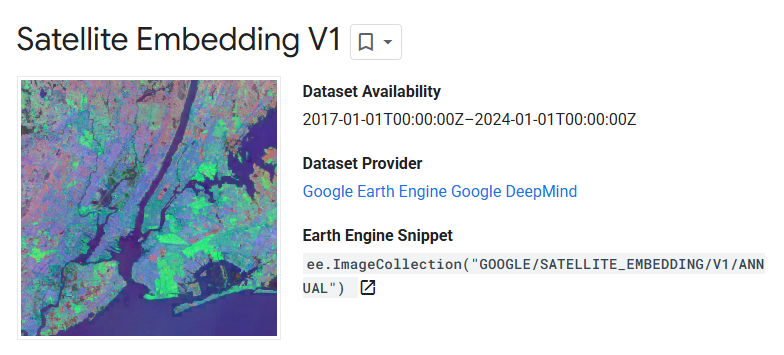
近期,Google DeepMind发布的AlphaEarth Foundations把遥感图像处理推向了新的高度。它不再针对单一任务(如建筑物提取或土地分类)训练,而是通过对海量多源遥感数据(包括光学影像、雷达影像、气候和地形数据等)的预训练,学习到一个通用的“地球表征”。
作为一个面向地理空间数据的基础模型,AlphaEarth Foundations展示了在标注稀缺场景下的强大泛化能力,也预示着遥感智能正迈向通用化与多模态融合的新阶段。
这里我们以AlphaEarth Foundations作为引子,更进一步的相关工作将在后续章节一一展开介绍。
除了空间特征的建模之外,时间序列的变化同样是遥感影像数据的关键维度。
正如前文所提到的,如果仅停留在“空间快照”,模型就可能错失地物随时间演变的脉络,很多实际应用(如农作物长势监测、地表覆盖动态监测、灾害演变模拟)都依赖于对时间序列的建模。
循环神经网络(Recurrent Neural Network, RNN)能够记忆过去并预测未来,是处理时序数据的重要工具。下一章,我们将首先介绍RNN的基本原理及其相关拓展方法,再讨论它在多时序遥感影像处理中的应用,以及更广泛的地理空间数据(如轨迹数据)处理中的应用。
作者信息与参考来源#
本科毕业于山东大学,现为深圳大学城市空间信息工程系,2023级人工智能专业硕士研究生。
研究方向:GeoAI、Geospatial Data Representation Learning。
深圳大学城市空间信息工程系,2022级地理信息与智慧城市硕士研究生(已毕业)。
研究方向:人口属性空间化。
博士毕业于中国科学院地理科学与资源研究所,现为深圳大学建筑与城市规划学院博士后。
研究方向:基于时空大数据的贫困与社会不平等研究。
本章节由李国隆、陈倩婷、胡姗负责编写,含AI工具辅助,文中所用插图部分来源于网络。
封面图片由即梦AI合成,prompt为:马赛克画,图片被密密麻麻的彩色马赛克分割,复古,抽象,油画印象,浓烈色彩对撞,复古,模糊细节。洞口的仰视视角,洞壁开满鲜花。洞口的中世纪机器人,俯身,正面,洞口仰视脸部特写。
参考来源#
-
Goodfellow, I., Bengio, Y., Courville, A., & Bengio, Y. (2016). Deep learning (Vol. 1, No. 2). Cambridge: MIT press.
-
Baeldung. (2024). Translation Invariance and Equivariance in Computer Vision. Baeldung.
-
Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). Imagenet classification with deep convolutional neural networks. Advances in neural information processing systems, 25.
-
Wikipedia. (n.d.). Convolutional neural network. Retrieved September 14, 2025
-
LeCun, Y., Bottou, L., Bengio, Y., & Haffner, P. (2002). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278-2324.
-
NehaCkumari. (n.d.). MNIST-Handwritten-Digit-Recognition-using-CNN. GitHub.
-
Wikipedia. (n.d.). Residual neural network. Retrieved September 14, 2025
-
Rolf, E., Klemmer, K., Robinson, C., & Kerner, H. (2024). Mission Critical–Satellite Data is a Distinct Modality in Machine Learning. arXiv preprint arXiv:2402.01444.
-
Ronneberger, O., Fischer, P., & Brox, T. (2015, October). U-net: Convolutional networks for biomedical image segmentation. In International Conference on Medical image computing and computer-assisted intervention (pp. 234-241). Cham: Springer international publishing.
-
Chen, L. C., Papandreou, G., Kokkinos, I., Murphy, K., & Yuille, A. L. (2017). Deeplab: Semantic image segmentation with deep convolutional nets, atrous convolution, and fully connected crfs. IEEE transactions on pattern analysis and machine intelligence, 40(4), 834-848.
-
Brown, C. F.、Kazmierski, M. R., Pasquarella, V J.、Rucklidge, W. J.,Samsikova, M.、Zhang, C.、Shelhamer, E.、Lahera, E.、Wiles, O.、Ilyushchenko, S.、Gorelick, N.、Zhang, L. L., Alj, S.、Schechter, E.,Askay, S.、Guinan, O.、Moore, R.、Boukouvalas, A.,& Kohli, P. (2025). AlphaEarth Foundations: An embedding field model for accurate and efficient global mapping from sparse label data. arXiv preprint arXiv:2507.22291.
校稿:黄菲