Wiki Foundations3 Concepts and Frameworks of AI
3.3 Transformer
从彻底改写自然语言处理,到重塑计算机视觉,Transformer架构的成功毋庸置疑。然而,与CNN和RNN直观的设计哲学(如空间局部性、线性时序)相比,Transformer的架构伴随着一种令人望而生畏的复杂性:它由自注意力、多头机制、位置编码等一系列看似零散的组件构成,常令初学者难寻其精髓。
本章的使命,正是要拨开这层迷雾。我们将揭示,Transformer并非一个固定的“万能钥匙”,而是一个极其灵活的“设计平台”。理解其“弱偏置、强通用性”的设计内核,不仅能解答它为何强大,更是我们将其“Transform”(改造)并应用于地理时空等特定领域、使其重新融合关键先验知识的理论基石。希望本章的探索,能为读者提供改造和应用这一强大架构的启示。
Transformer——基于注意力的全新架构#
前一章我们在介绍RNN的注意力机制之后,留下了一个悬而未决的问题:如果注意力机制本身就足以捕捉长距离依赖,我们是否还需要RNN那套固有的循环结构?
Transformer的诞生,是对这个问题最响亮、最彻底的回答。2017年的开创性论文《Attention Is All You Need》,以其极具宣言意味的标题,宣告了一个新时代的到来。它完全摒弃了RNN串行的循环结构,以一个纯粹的、可高度并行的自注意力机制为核心,并结合了恰当的位置信息注入方法。
由此诞生的Transformer架构,不仅在机器翻译等任务上取得了革命性的性能和效率突破,更重要的是,它向整个领域证明了一个颠覆性的思想:序列的本质,或许并非“循环”,而仅仅是“关联”。
构建通用的关系推理引擎,Transformer模块详解#
Transformer发现“关联”的强大能力,源于其可重复堆叠的核心模块(即Transformer Block)的精巧设计。
这个模块通过几个关键组件的协同工作,优雅地回答了数据表示在计算更新过程中“如何在庞大的信息集合中,高效地发现关系并更新自我认知”这一关键问题。
自注意力机制(Self-Attention):在全局视野中动态捕捉关联#
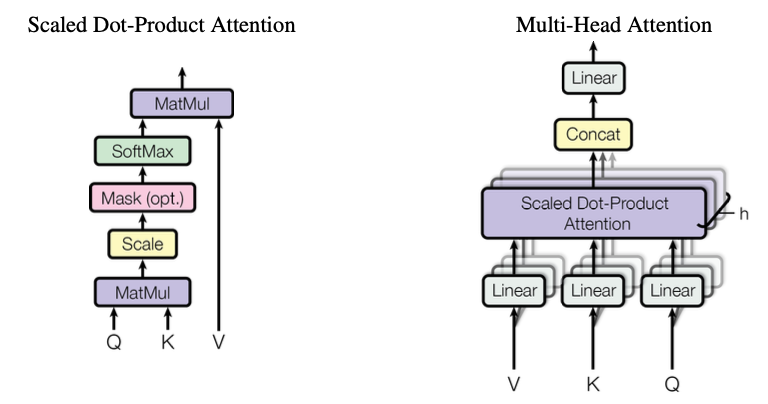
这是新范式的绝对核心。它赋予了模型一种前所未有的能力:在一次计算中,审视序列中的所有元素,并动态地为任意两个元素之间的关联性打分。
其核心思想,是让序列中的每一个元素都同时扮演三个角色:查询(Query, Q)、键(Key, K) 和 值(Value, V)。
我们可以想象一个“头脑风暴”的会议场景。当一个参会者(一个输入元素 \mathbf{x}_i)准备发言时,它会:
- 提出一个议题(Query, q_i): 这是它内心想要了解和关联的信息,即“我关心什么?”。
- 亮出一个标签(Key, k_i): 这是它自身信息的“关键词”,用于告诉别人“我代表什么?”。
- 准备一份资料(Value, v_i): 这是它实际拥有的、准备分享给相关者的信息内容。
这三个角色向量,都是由原始的元素向量 \mathbf{x}_i 经过一次独立的线性变换(乘以可学习的权重矩阵 W^Q, W^K, W^V)得到的:
随后,“关联”的过程正式开始。
为了更新自己的信息,第 i 个元素的查询向量 q_i 会去“审视”会场上所有元素(包括它自己)的键向量 k_j,通过计算点积来判断两者的“匹配度”。
这个匹配度分数经过缩放和Softmax归一化后,就变成了一组权重,代表了第 i 个元素应该从其他所有元素身上“汲取”多少注意力。
最后,用这些权重对所有元素的值向量 v_j 进行加权求和,就得到了一个专属于第 i 个元素的、融合了全局上下文信息的新表征。
这个过程用矩阵形式一次性为所有元素并行完成,其计算公式简洁而强大:
多头注意力(Multi-Head Attention):从多个子空间中综合洞察#
现实世界的关系是多维度的。例如,两个词之间可能同时存在“主谓”的句法关系和“同义”的语义关系。如果只用一套Q、K、V,模型可能会顾此失彼。
多头注意力的思想,就是引入一个“专家小组”来取代原先的“单人决策”。
它不再只进行一次注意力计算,而是将Q、K、V通过线性变换后,在维度上切分成多个独立的“头”(例如8个)。
每个头都在一个不同的“子空间”中,并行地、互不干扰地进行各自的注意力计算,就像让句法专家、语义专家、指代关系专家同时审视序列,并给出各自的分析报告。
最后,将所有专家的“分析报告”(即每个头的输出向量)拼接并经过一次最终的线性融合,就得到了一个综合了多个视角、信息更丰富的最终输出。
这种机制极大地增强了模型捕捉不同类型复杂关系的能力。
信息处理与稳定化:前馈网络与“三明治”结构#
在通过多头注意力汇集了丰富的全局关系信息后,模型还需要一套流程来“消化”这些信息,并确保整个深度网络的稳定。
这由Transformer Block中另外两个关键组件完成:
-
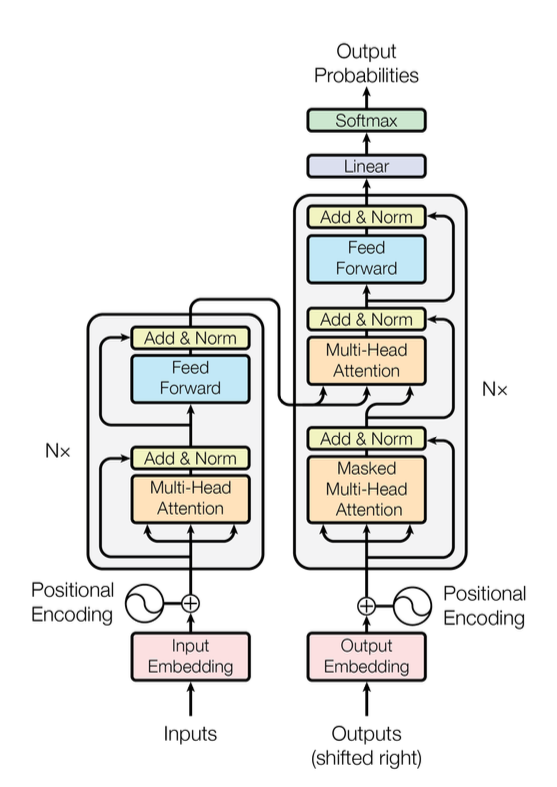
前馈神经网络(Feed-Forward Network): 每个元素在经过注意力层后,都会独立地通过一个小型的前馈网络(通常是两层MLP)。它像一个“信息精加工站”,对融合了上下文的新表征进行一次非线性变换,从而加深理解,并增强模型的表达能力。
-
“Add & Norm”稳定结构: 为了让信息在数十甚至上百层的深层网络中有效传递而不发生退化,每个主要计算单元(多头注意力和前馈网络)都被包裹在一个“三明治”结构中。这个结构由残差连接(Add)和层归一化(Norm)组成。残差连接构建了一条“信息高速公路”,将输入直接连接到输出,确保原始信息不丢失;层归一化则在每一步后对数据进行“校准”,防止数据分布出现剧烈波动。
自注意力、多头机制,以及由前馈网络和 “Add & Norm” 构成的稳定更新流程,这三者共同构成了Transformer Block这个强大而可重复堆叠的“乐高积木”,为构建深度、强大的关系推理网络奠定了基础。
深入理解了构成Transformer Block的核心组件后,下一步便是探索这些模块如何被组装和应用。
一个最基础也最关键的区别,源于注意力机制本身的方向性。根据信息流动的规则,注意力可以被分为两种主要形式:
- 双向注意力(Bidirectional Attention): 序列里的任何一个元素都可以关注其他所有元素。
- 单向或因果注意力(Unidirectional / Causal Attention): 元素只能关注位于其之前的元素。
为了首先理解Transformer架构最纯粹的全局关系建模能力,我们将从更直观、更通用的双向注意力开始。
这种允许任意元素间直接交互的思想,其有效性很快在两大主流AI领域得到了验证。
在自然语言处理领域,以BERT为代表的模型正是利用了深度的双向注意力机制,使其能够同时融合一个词左右两侧的全部上下文信息,从而在文本理解任务上取得了革命性的突破。
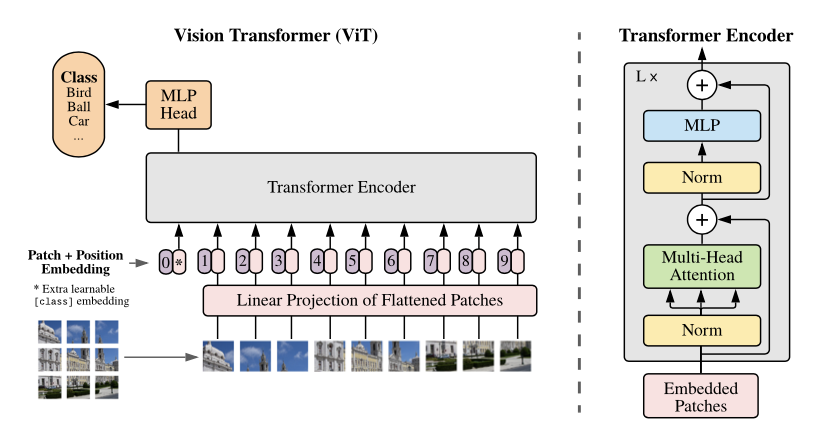
几乎在同一时期,计算机视觉领域也迎来了Vision Transformer(ViT)的挑战。
ViT将图像切分为一系列“图像块”(patches),并将其视为一个序列送入Transformer。实验证明,在足够的数据规模下,这种纯粹的注意力模型,其性能足以媲美甚至超越此前由CNN主导的图像识别任务。
BERT和ViT的成功,有力地证明了Transformer核心思想的强大通用性。
位置感知打破置换不变性#
然而,在这巨大成功的背后,纯粹的注意力机制也暴露了一个根本性的局限——置换不变性(Permutation Invariance)。
由于模型对所有元素一视同仁地计算两两关系,它天然地无法感知元素的顺序。这意味着,对于模型而言,“我吃苹果”与“苹果吃我”在结构上是无法区分的。
这个局限显然是致命的,因为在绝大多数真实世界的数据中,顺序和位置都是决定语义的核心。
因此,为了让Transformer在实践中真正有效,一个关键挑战便是打破这种置换不变性,让模型以某种方式“感知”到元素的位置。
对此,研究者们探索了两条主要的技术路径。
第一条路径是位置嵌入(Positional Embedding)。
其核心思想是在数据输入模型之前,为每一个元素额外叠加一个代表其位置的向量。
例如,最初的Transformer论文采用固定的正弦位置编码(Sinusoidal Positional Embedding),根据元素在序列中的绝对位置,通过不同频率的正弦和余弦函数计算出一个独特的位置向量。
对于位置为 pos、维度为 i 的编码,其计算方式为:
这种方法的可扩展性强,随着语言的长度变化,总能计算出一个对应的位置嵌入。
ViT等模型则采用了可学习的绝对位置嵌入,让模型在训练中自行决定如何注入不同patch的位置信息。
第二条路径是直接改造注意力计算过程。
既然最终目的是让注意力分数随位置变化,为何不直接改造注意力计算过程本身呢?
这类方法不再修改输入,而是直接在计算注意力分数时,融入元素间的相对位置信息。其中的两个典型代表是 ALiBi 和 RoPE。
ALiBi(Attention with Linear Biases)
ALiBi通过在注意力分数上直接叠加一个与元素间距离成正比的、固定的偏置项,使模型天然地、隐式地更关注近邻。
其注意力分数的计算可以概念性地表示为:
RoPE(Rotary Positional Embedding)
RoPE则通过将位置信息编码为旋转矩阵,在计算点积前对Query和Key向量进行“旋转”。
其精巧之处在于,两个经过绝对位置旋转后的向量的点积,等价于其中一个向量与一个仅依赖于相对位置的旋转矩阵作用后的点积。
对于位于 m 和 n 的两个元素,其分数计算满足:
这意味着注意力分数天然地成为了相对位置的函数,且随着距离增大,其内积的周期性变化会自然地引入一种衰减效应。
这些方法共同解决了位置感知的核心问题。
但从本质上看,无论是改造输入还是改造计算过程,它们都是为了“修补”纯粹注意力机制的置换不变性。
于是,第三条更激进的路径应运而生:如果数据的内在规律极强(例如,鲜明的周期性),我们何不干脆将通用的注意力引擎,替换为一种更具针对性的全局信息混合机制呢?
这类方法借鉴了信号处理的思想,将目光投向了频域。
例如,Autoformer专为具有明显周期性的时间序列数据设计,它用一种新颖的自相关(Auto-Correlation)机制替代了自注意力。该机制能高效地在频域中发现序列的主要周期,并据此进行信息聚合,做到了“专业的人干专业的事”。
另一类方法如AFNO(Adaptive Fourier Neural Operator)则更直接,它通过傅立叶变换将数据切换到频域,直接对全局频率分量进行处理和混合,尤其擅长处理像气象数据这样具有平滑连续特性的网格化数据。
这些方法牺牲了部分通用性,换来了在特定类型数据上更高的效率和性能。
当Transformer的核心引擎不再是我们熟知的“点积注意力”,而被替换为自相关机制或傅立叶变换等全新机制后,我们不禁会陷入一种“忒修斯之船”式的哲学思辨:一个被替换了核心引擎的Transformer,还应该被称为Transformer吗?
或许答案并不重要。
重要的是,这三类方法的探索共同证明了,Transformer不仅仅是一个固定的模型,更是一个极其成功的通用设计平台。
它提供了一套行之有效的模块化设计理念(如残差连接、层归一化、多头思想等),允许研究者们像组装电脑一样,根据具体任务,灵活地插入、修补甚至替换其核心组件,从而在通用性与特异性之间取得理想的平衡。
FFN与Normalization层的演进#
在解决了位置感知这一核心问题后,我们暂时将视线从注意力机制上移开。
一个完整的Transformer Block不仅包含注意力这个核心引擎,还包括前馈网络(FFN)和归一化层(Normalization)这两个关键的支撑组件。
虽然它们不像注意力机制那样引人注目,但对它们的持续优化,同样是提升模型性能、稳定训练过程的重要一环,也体现了研究者们对细节的极致追求。
前馈网络(FFN)的优化#
标准的Transformer FFN是一个简单的两层MLP,通常使用ReLU作为激活函数。
后续研究发现,通过引入更先进的激活函数和结构,可以显著提升模型的性能。
1. 从ReLU到更平滑的激活函数
研究者们发现,像GELU(Gaussian Error Linear Unit)这样更平滑的激活函数,相比于ReLU的硬拐点,能为模型优化带来更好的表现。
GELU成为了BERT和GPT系列等早期大型模型中的标准配置。
2. 门控线性单元(Gated Linear Units, GLU)家族
这是近年来最重要的FFN演进方向。
其核心思想是为信息流引入一个“门控”机制,让网络可以动态地、基于输入内容来控制哪些信息可以通过。
其中,SwiGLU是目前最成功和流行的变体之一。它将输入线性投射为两部分,一部分经过Swish激活函数处理后,作为“门”去乘以另一部分。
这种门控结构被证明比传统的ReLU/GELU更有效,能够用更少的参数达到更好的性能,已成为许多先进大模型(如Llama系列)的标配。
3. 混合专家模型(Mixture of Experts, MoE)
这是一种更激进的架构改造。
它不再让所有输入都通过同一个FFN,而是在模型中设置多个并行的FFN“专家”。
对于每一个输入,一个轻量的“路由”网络会决策将其发送给哪一个或哪几个专家进行处理。
核心优势: MoE允许模型的总参数量达到惊人的规模,但在处理单个输入时,实际激活的计算量却保持不变。这是一种在不增加推理成本的前提下,极大扩展模型容量的有效方法。
近年来,许多领先的开源模型都采用了这一架构,例如DeepSeek-V3等模型便以其高效的MoE设计作为核心创新之一。
归一化(Normalization)层的改造#
标准的层归一化(Layer Normalization, LayerNorm)对于稳定Transformer的训练至关重要。
但研究者们也探索了更高效或功能更强大的替代方案。
RMSNorm(Root Mean Square Norm)
这是对LayerNorm的一种简化。
它在计算时移除了re-centering的环节,只通过输入的均方根进行缩放。
这在数学上简化了计算,减少了运行时间,同时实验证明,它在保持甚至提升模型性能和稳定性方面,与LayerNorm表现得同样出色,因此在许多现代大模型中被广泛采用。
自适应归一化(Adaptive Normalization)
这类方法本身并非一种全新的归一化算法,而是对现有归一化层的一种功能扩展,主要用于条件注入。
例如adaLN(Adaptive LayerNorm),其核心思想是:不再使用固定的、可学习的缩放和偏移参数,而是让一个小型网络根据外部条件(如扩散模型中的时间步 t、或类别标签 c)来动态地预测这些参数。
这使得归一化层本身就成为了一个可以接收指令、调整模型行为的“控制阀”,是一种极其高效的条件控制技术。
因果注意力:生成式任务的基石#
在展示了双向注意力的强大通用性后,我们现在回到本节开头提及的另一种形式——单向注意力(Unidirectional Attention)。
其核心机制非常简单:通过在注意力计算中引入一个“遮罩”(Mask),强制每一个元素在进行信息交互时,只能“看到”已经存在的、位于它“之前”的元素,而无法看到“之后”的元素。
这种单向的结构,与语言生成等任务的需求天然契合。
语言的生成很大程度上是一个自回归(Autoregressive)的过程:我们总是在已有词语的基础上,逐一预测并写下下一个词。
因果注意力正是对这一过程的完美数学实现。它的“遮罩”机制,确保了模型在预测第 t 个词时,只能利用前 t-1 个词的信息,这恰好就是在建模条件概率 P(x_t \mid x_{<t})。
同时,这种由因果注意力驱动的自回归范式是通用的,不止于一维的文本。
例如,在图像生成领域,iGPT(Image GPT)等模型就将这一思想实例化:它们首先将图像像素或图像块(patches)按照固定的扫描顺序(例如,从左上到右下)排列成一个序列,然后便可以像生成文本一样,使用因果注意力逐一预测下一个元素。
乍一看,这种无法“全面考虑”的单向机制,似乎比能够融合全局上下文的双向注意力要弱。
然而,这种信息的“枷锁”,或许成为了它在生成式任务中无可比拟的优势。
原因在于:
从“理解者”到“创造者”
双向注意力是一个强大的“关系理解者”,它擅长在已有信息的全景图上进行填空或改写。
而因果注意力的限制,则迫使模型必须学会从无到有地进行“创造”。
它在每一步都必须基于已知对未知进行概率预测,这天然地就是在学习一个生成过程,即学习数据的因果依赖关系。因此,它也被称为因果注意力(Causal Attention)。
除了这一根本性的转变,我们还可以从另外两个更具体的角度,来理解因果注意力在训练层面的独到之处:
1. 更高的训练效率
在BERT式双向注意力的掩码语言建模(MLM)中,通常只有一小部分(如文本中约15%,图像中可能高达75%)的输入单元被遮盖,并对模型训练产生贡献。
而在自回归建模中,借助一种名为teacher forcing的技巧,序列中的几乎每一个元素都可以作为一次独立的“预测练习”,为模型优化提供梯度信号。
这意味着在处理同样的数据量时,因果注意力模型的学习信号密度通常高于掩码模型。
2. 更难的任务,更强的表示
因果注意力在预测时,可依赖的上下文更少,这意味着它的预测任务本身难度更高。
这种“戴着镣铐跳舞”的高难度训练,被认为可能迫使模型学习到更强大、更泛化的特征表示。
虽然这仍是一个活跃的研究领域,但一个值得注意的趋势是,近年来,越来越多的研究开始使用基于因果注意力训练的解码器模型作为强大的通用嵌入模型,其在部分基准上的表现甚至超越了传统的MLM模型。
这从侧面印证了,更具挑战性的因果预测任务,或许确实能锤炼出更优质的底层表示能力。
规模的奇迹:从因果注意力到智能涌现#
上一节我们详细探讨了因果注意力为何是生成式任务的基石。
现在,我们将目光聚焦于这一思想最辉煌的结晶——大型语言模型(Large Language Models, LLM)。
正是这些以因果注意力为核心的庞大模型,将人工智能推向了一个全新的高度。
在深入探讨LLM的崛起之前,有必要先厘清一些历史术语。
最初的Transformer论文是为机器翻译任务设计的,继承了当时主流的编码器-解码器(Encoder-Decoder)架构。
其中,编码器采用双向注意力来“阅读”和“理解”整个源语言句子;解码器则采用因果注意力,在“参考”编码器信息的同时,逐词“生成”目标语言句子。
后续的研究者们发现,这两个组件可以被灵活地拆分单用,从而形成了两条主要的技术路线:
-
Encoder-only路线: 以BERT为代表,其核心是双向注意力,天生擅长深度理解上下文,因此主导了自然语言理解(NLU)领域。
-
Decoder-only路线: 以GPT系列为代表,其核心是因果注意力,天然适合进行自回归式的“创作”,因此主导了自然语言生成(NLG)领域。
尽管“Encoder-only”和“Decoder-only”的称呼非常流行,但鉴于其字面上的“编码/解码”内涵已不完全符合当今模型的实际功能,我们在后续将主要从“双向”和“因果”注意力的角度来讨论。
为何是生成式模型?#
随着模型规模的不断扩大,研究者们逐渐发现,基于因果注意力的生成式模型,在性能和通用性上开始展现出远超预期的惊人表现。
它们不仅能生成前所未有地流畅、连贯、且富有逻辑的长篇文本,更重要的是,在没有任何针对性训练的情况下,它们开始自发地展现出解决多样化任务的潜力。
这种现象的冲击力是巨大的,它促使学界和业界将目光的焦点,
这一转变引出了一个深刻且关键的问题:为何是基于因果注意力的“生成式”模型,而非基于双向注意力的“理解式”模型,最终通向了通用人工智能的道路,展现出惊人的通用能力?
答案可能在于任务本身的通用性与开放性。
BERT的“完形填空”任务相对封闭,它极其擅长在已有的上下文关系中进行推断。而GPT的“文本补全”任务,即预测下一个词,本质上是一个极其开放的框架。
无论是回答一个问题、翻译一句话、写一段代码,还是进行逻辑推理,所有这些复杂的任务,都可以被巧妙地转化为“给定一段前文(prompt),预测最合理的后文(completion)”这一种形式。
更深层次的原因是,“预测下一个词”这个看似简单的任务,实际上是一个强大的代理任务(Proxy Task)。
为了能够准确地预测海量、多样化的人类文本中的下一个词,模型被迫去学习和内化这些文本背后所描述的整个世界的规律、知识和逻辑。
要补全一句关于物理定律的描述,它必须“理解”物理;要续写一段代码,它必须“学习”编程。
因此,因果注意力驱动的生成任务,驱使模型在内部构建了一个庞大而复杂的世界模型(World Model)。
我们所观察到的强大能力,正是这个内部世界模型的外在体现。
缩放定律与能力的涌现#
LLM革命真正的导火索,并非某项全新的算法,而是一个被称为缩放定律(Scaling Laws)的惊人发现。
研究表明,当Transformer模型的参数量、训练数据量和计算量同时、协同地跨越某个巨大的临界点后,模型的性能不仅会可预测地持续提升,更重要的是,它会开始自发地“解锁”在小模型上完全不存在的全新能力。
这种“量变引起质变”的现象,被称为智能的涌现(Emergent Abilities)。
以GPT-3的发布为标志,研究者们发现,这些超大规模模型在没有经过任何特定任务微调的情况下,仅仅通过“预测下一个词”的训练,就自发地学会了:
-
上下文学习(In-Context Learning): 无需更新模型权重,仅通过在提示中给出几个示例(few-shot),模型就能学会并完成全新的任务。
-
思维链(Chain-of-Thought, CoT)推理: 在面对复杂问题时,模型能自主地将问题分解为一步步的推理过程,并最终给出答案,极大地提升了其逻辑和算术能力。
-
指令遵循(Instruction Following): 模型能够理解并执行以自然语言形式给出的、复杂的指令。
这些涌现出的能力,证明了大规模的因果注意力模型,已经从一个单纯的“文本生成器”,质变为一个具备初步通用问题解决能力的“原始智能体”。
然而,这种智能是被动而未经雕琢的,它虽然蕴含着巨大的潜力,却还不会主动地、可靠地以人类期望的方式提供帮助。
而要完成这一转化,将“原始智能”塑造为可用工具,研究者们开发了一套被称为“对齐”(Alignment)的核心技术流程。
对齐:将涌现智能塑造为可用工具#
对齐的第一步是指令微调(Instruction Tuning)。
这一阶段通过在数以万计的高质量“指令-回答”数据集上进行监督微调(Supervised Fine-Tuning, SFT),来教会模型理解并遵循人类指令的格式。
其核心目标是将一个只会“续写”的预训练模型,改造为一个懂得如何以问答、摘要、创作等形式与人交互的“助手”模型。
在此基础上,第二步基于人类反馈的强化学习(Reinforcement Learning from Human Feedback, RLHF)则旨在使其输出更符合人类细微、复杂的偏好。
该过程通过训练一个“奖励模型”(Reward Model)来模仿人类的判断标准,再利用强化学习算法让语言模型以最大化奖励评分为目标进行自我优化,从而学会生成质量更高、更受人类偏爱的内容。
对齐的最终目标是让模型成为能解决实际问题的智能体(Agent)。
这除了要求模型能精确遵循指令外,通常还通过赋予模型使用外部工具(Tools)的能力来实现。
一个经过精良对齐训练的模型,能够识别自身知识的局限,并生成函数调用(Function Calling)指令来查询搜索引擎或与其他API交互,从一个封闭的“语言专家”,转变为一个能够与数字世界交互并执行复杂任务的“行动者”。
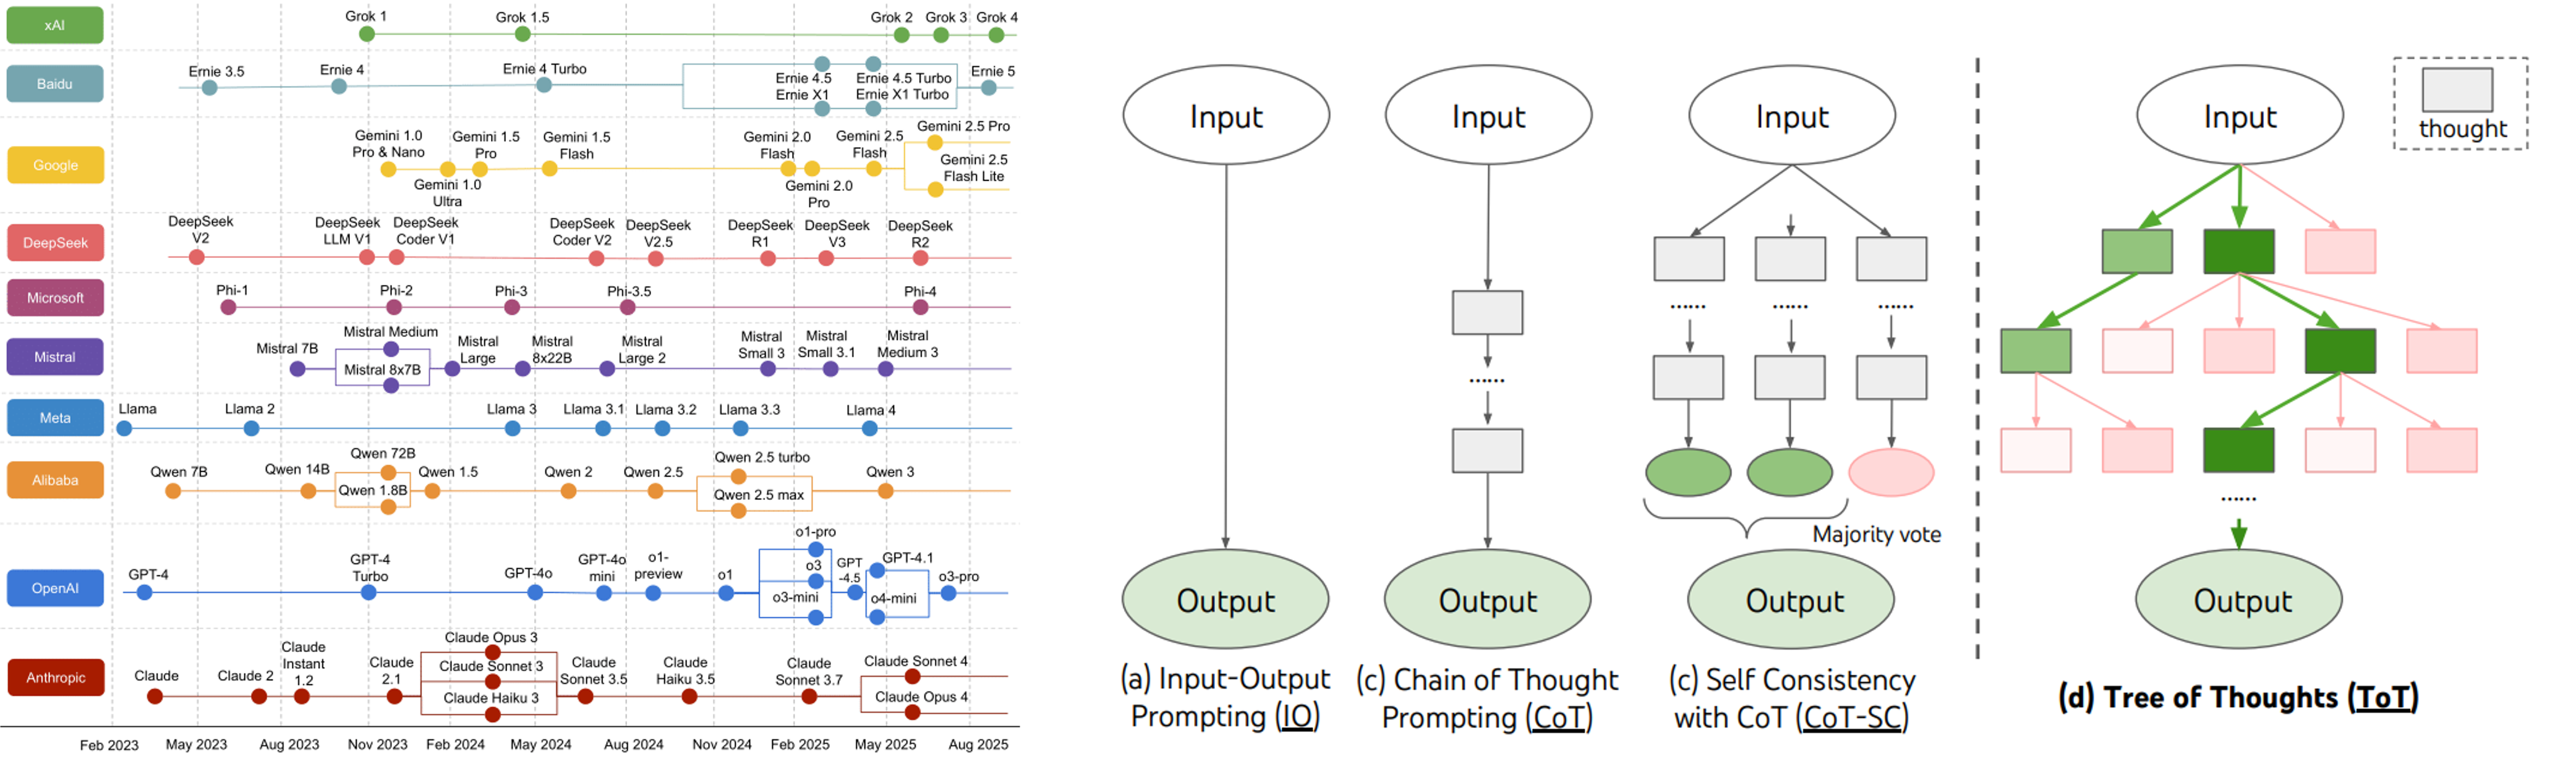
从思维链到决策艺术:探索更优的推理路径#
然而,一个能遵循指令、使用工具的“行动者”,离一个真正高效的问题解决者之间,还存在一个关键的差距:推理(Reasoning)的深度。
这一探索的起点,源于一个简单而深刻的发现——思维链(Chain-of-Thought, CoT)。
研究者们发现,通过在提示中简单地要求模型“一步步思考”,就能显著提升其在逻辑、数学等任务上的表现。
CoT的贡献在于,它证明了“思考的过程”和“最终的答案”同样重要,它是一种“激发”模型内在潜力的方式。
这与人类解决复杂问题时的策略不谋而合:将思考过程写下来,往往能帮助我们发现之前未曾想到的关联,并让最终的决策更可靠。
但CoT的线性本质也是它的局限所在,它像一条单行道,一旦步骤出错便很难纠正。
为了克服这一点,更全面的方法如思维树(Tree of Thoughts, ToT)应运而生,它允许模型同时探索多个不同的推理分支。
但这又带来了新的挑战:当推理的“树”变得异常繁茂时,模型如何决定优先探索哪个分支?如何避免陷入无休止的思考,成为一个“思想的巨人,行动的矮子”?
这正是强化学习(Reinforcement Learning, RL)再次发挥关键作用的地方。
RL被引入来解决这个关于“如何思考”的元问题。
在这个框架下,模型的“行动”不再是生成下一个词,而是做出一个推理决策(例如,“下一步应该探索哪个分支?”),只有当一条完整的推理路径最终导向一个正确答案时,模型才会获得正向的“奖励”。
通过反复的试错和优化,模型不再是盲目探索,而是学到了一套关于如何进行高效推理的“策略”。
通过这种方式,强化学习将LLM从一个“推理的执行者”,转变为一个能够规划和优化自身思考过程的、更高级的“决策者”。
跨界应用:从科学计算到地理空间智能#
Transformer的思想并未止步于语言和视觉,它迅速进入了科学计算的核心领域。
在这些场景中,虽然对象和任务大相径庭,但其迁移应用的逻辑却高度一致,可以被概括为一个通用的三步流程:
- 将具体问题中的对象(如分子、蛋白质)改写成统一的序列或集合形式。
- 让注意力机制去捕捉序列中元素之间远距离、非局部的依赖关系。
- 将经过关系建模后得到的表征,投射回各自任务所需的物理或符号空间中去。
Transformer在科学计算中的实践#
在蛋白质结构预测中,关键挑战在于氨基酸序列上相隔遥远的残基,在三维空间中可能彼此靠近并相互作用。
AlphaFold正是将氨基酸序列与残基对表征作为输入,让注意力机制自主发现这些关键的远距离耦合关系,最终将这些关系信息解码为精确的原子三维坐标。
其后续的AlphaFold3更将蛋白、核酸与小分子纳入同一框架,实现了跨分子的结构预测。
在化学反应预测中,挑战则来自官能团的长程影响。
一个远离反应中心的基团,可能因电子效应或空间位阻而决定最终产物。
Molecular Transformer通过将反应物和反应试剂改写成SMILES序列,让注意力机制在无需指定的情况下,自动建模这些远端基团与反应中心之间的复杂影响,从而在基准数据集上取得了高达90%左右的预测准确率。
这两个例子清晰地展示了上述“三步流程”的威力:无论是将一维氨基酸序列映射为三维坐标,还是将一维分子符号序列映射为产物的符号序列,其核心都在于利用注意力机制有效捕捉长程依赖,这正是Transformer普适性的关键所在。
Transformer在GeoAI中的应用#
现在,我们将这套成功的模式带回本书的核心领域。
在探讨具体应用之前,有必要先了解GeoAI所处理的数据的独特性与多样性。
地理空间数据远不止于地图和影像,它是一个多模态、多尺度、时空交融的复杂信息体系。
常见的数据源包括:
-
遥感影像(Remote Sensing Imagery): 来自卫星或无人机,提供“上帝视角”的宏观地表观测,是理解土地覆盖、城市扩张、环境变化的基石。
-
街景影像(Street View Imagery): “人眼视角”的近距离观测,捕捉了城市建成环境的细节、商业活力和社区风貌。
-
兴趣点(Points of Interest, POI): 带有类别和属性的地理点位,如餐厅、商场、地铁站,它们构成了城市功能的骨架。
-
轨迹数据(Trajectory Data): 来自GPS设备、手机信令等的移动轨迹,记录了人、车、物的时空流动,是理解交通模式和人类活动的关键。
-
社交媒体打卡数据(Social Media Check-ins): 带有地理标签的用户生成内容,反映了空间的“人气”和人们对特定场所的情感与感知。
-
其他各类矢量数据(Vector Data): 如道路网、行政边界、建筑物轮廓等,以点、线、面的形式,描述地理实体的几何形态与拓扑关系。
面对如此异构的数据,地理现象的复杂性(如交通枢纽对数公里外通勤流的影响、商业中心与住宅区的功能耦合)要求模型具备强大的“跨距离、跨要素”的建模能力。
这正是CNN的局部视野和RNN的线性假设难以企及的。
Transformer的出现,为解决这一核心挑战提供了全新的工具。
下面我们参照任务与数据的脉络,看看它如何具体落地。
多模态地理表征学习(影像—文本—属性对齐)#
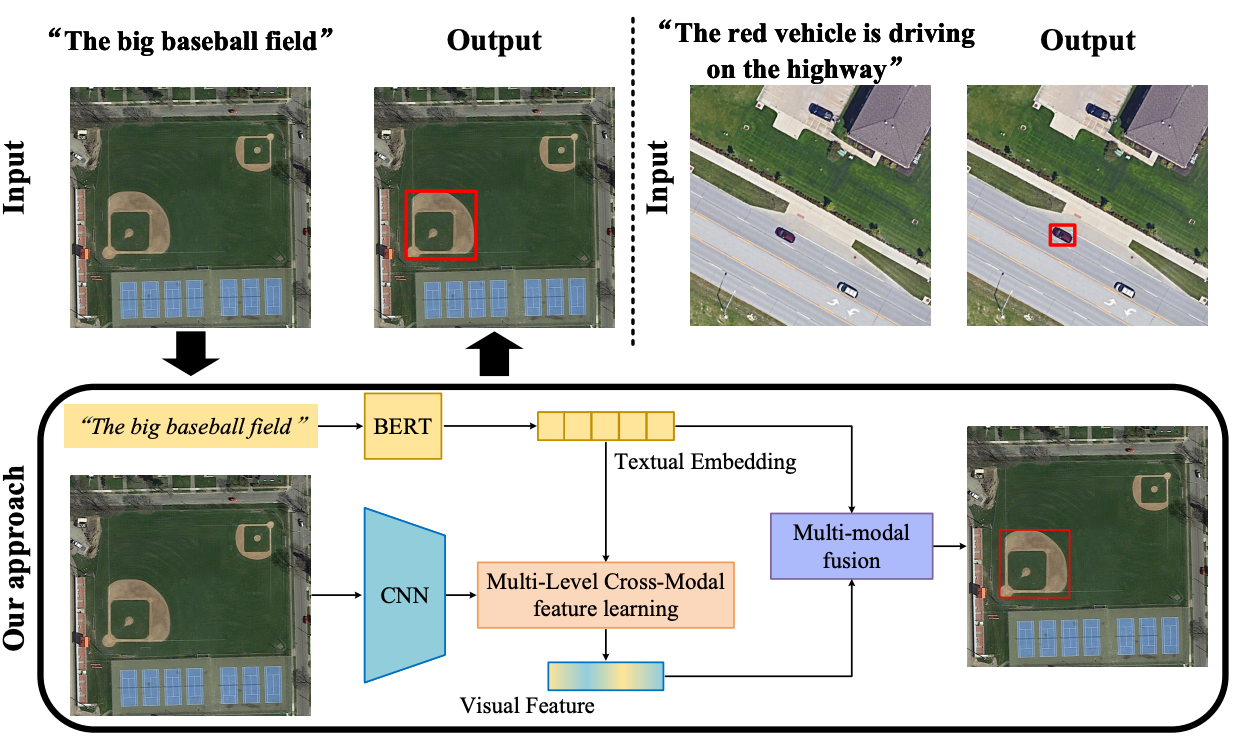
Transformer让遥感/街景影像、文本描述与统计属性、坐标与时间编码在同一语义空间里对齐,从而支持“按一句话找地点”、“零样本检索”和跨域迁移。
做法上常采用CLIP式对比学习:图像塔(ViT/分层ViT)与文本塔(Transformer)分别编码影像与语句,通过大规模图文配对学习跨模态一致性,再把坐标、投影与时序特征嵌入到编码或融合层,赋予表征以地理意识。
例如,RSVG(Remote Sensing Visual Grounding)工作就构建了大规模图文对齐数据集,并提出了基于Transformer的多粒度视觉—语言融合(MGVLF)模块,从而能把“这张城市场景里靠近河道的长条形白屋顶”这类自然语言约束,精确落到像素与框选区域上。
拓扑显式制图与图谱补全(从像素到“可用”的网络)#
Transformer的全局感知能力为“从像素到可用的矢量网络”提供了关键。
面对树荫、阴影或建筑遮挡导致的道路断裂,模型不只进行像素级分割,而是通过其长程依赖建模能力,推断被遮挡部分的连接关系,并结合拓扑约束自动补全缺边、抑制假支路。
这样得到的是能直接用于导航与仿真的、结构合理的道路/河网,而非仅仅“看起来像路”的像素集合。
相比纯CNN方法,这类范式能显著提高生成网络的连通性指标(如APLS)。
已有工作(如MDANet)将可变形/多尺度注意力与道路形状先验结合,在高分辨率遥感影像的道路提取任务中,完整性与连通性均取得了显著提升。
时空依赖关系建模(从“空间快照”到“过程模拟”)#
Transformer将“空间长程依赖”和“时间因果演化”统一处理,适用于人流迁移、交通状态、气象预报等复杂系统。
以Pangu-Weather为例,它以3D地球专用Transformer(3DEST)在全球ERA5数据上做中期预报,在1小时到1周的范围内在多个要素与时效段达到/超过业务模式,并显著提速。
这表明,注意力机制能够将大尺度地球系统中的复杂物理过程的长程依赖“一次性”整合进数据驱动的时空表征中,既提升精度,又兼顾效率。
返璞归真:Transformer成功的深层逻辑#
行文至此,我们已经见证了一场由Transformer引领的技术革命:从它在语言和视觉领域的颠覆性突破,到LLM的智能涌现,再到其在科学计算和地理空间智能等前沿领域的广泛应用。
一个看似统一的架构,为何能在如此多样的领域掀起滔天巨浪?
答案并非在于某个单一的精巧组件,而在于其最底层的设计哲学。
要理解其普适性的根源,我们需要回归到所有模型设计的本质——归纳偏置(Inductive Bias)。
所谓归纳偏置,即我们在模型开始学习前,为其预设的一套关于数据结构的先验假设。
它像一条引领模型学习的捷径,若假设与数据规律匹配,则事半功倍。
从CNN到RNN,它们正是“强”归纳偏置的代表:
-
CNN 的信念是,重要信息在空间上是局部的。因此,它的核心操作——卷积核——被严格限制在邻近像素的一个小窗口内进行计算。这种强大的信念,使其成为处理图像的专家,但也限制了它对远距离关系的直接感知。
-
RNN 的信念是,信息是前后相继、线性流动的。因此,它以循环的方式逐个处理序列元素。这让它精于处理时序数据,但也带来了“表征瓶颈”与长时记忆遗忘的代价。即使是引入了注意力机制的RNN,也只是在原有的链式结构上,增加了额外的“快捷方式”,并未改变其根本。
这些模型的设计哲学,是为特定问题打造高效的专用工具。
但这些工具强大的“偏见”也带来了局限。
一个更统一的视角,是将这些架构都理解为在不同类型的图(Graph)上进行信息传播:
- CNN: 它的世界观是一张连接关系仅限于邻居的网格图(Grid Graph)。
- RNN: 它的世界观是一条连接关系只存在于前后的链式图(Chain Graph)。
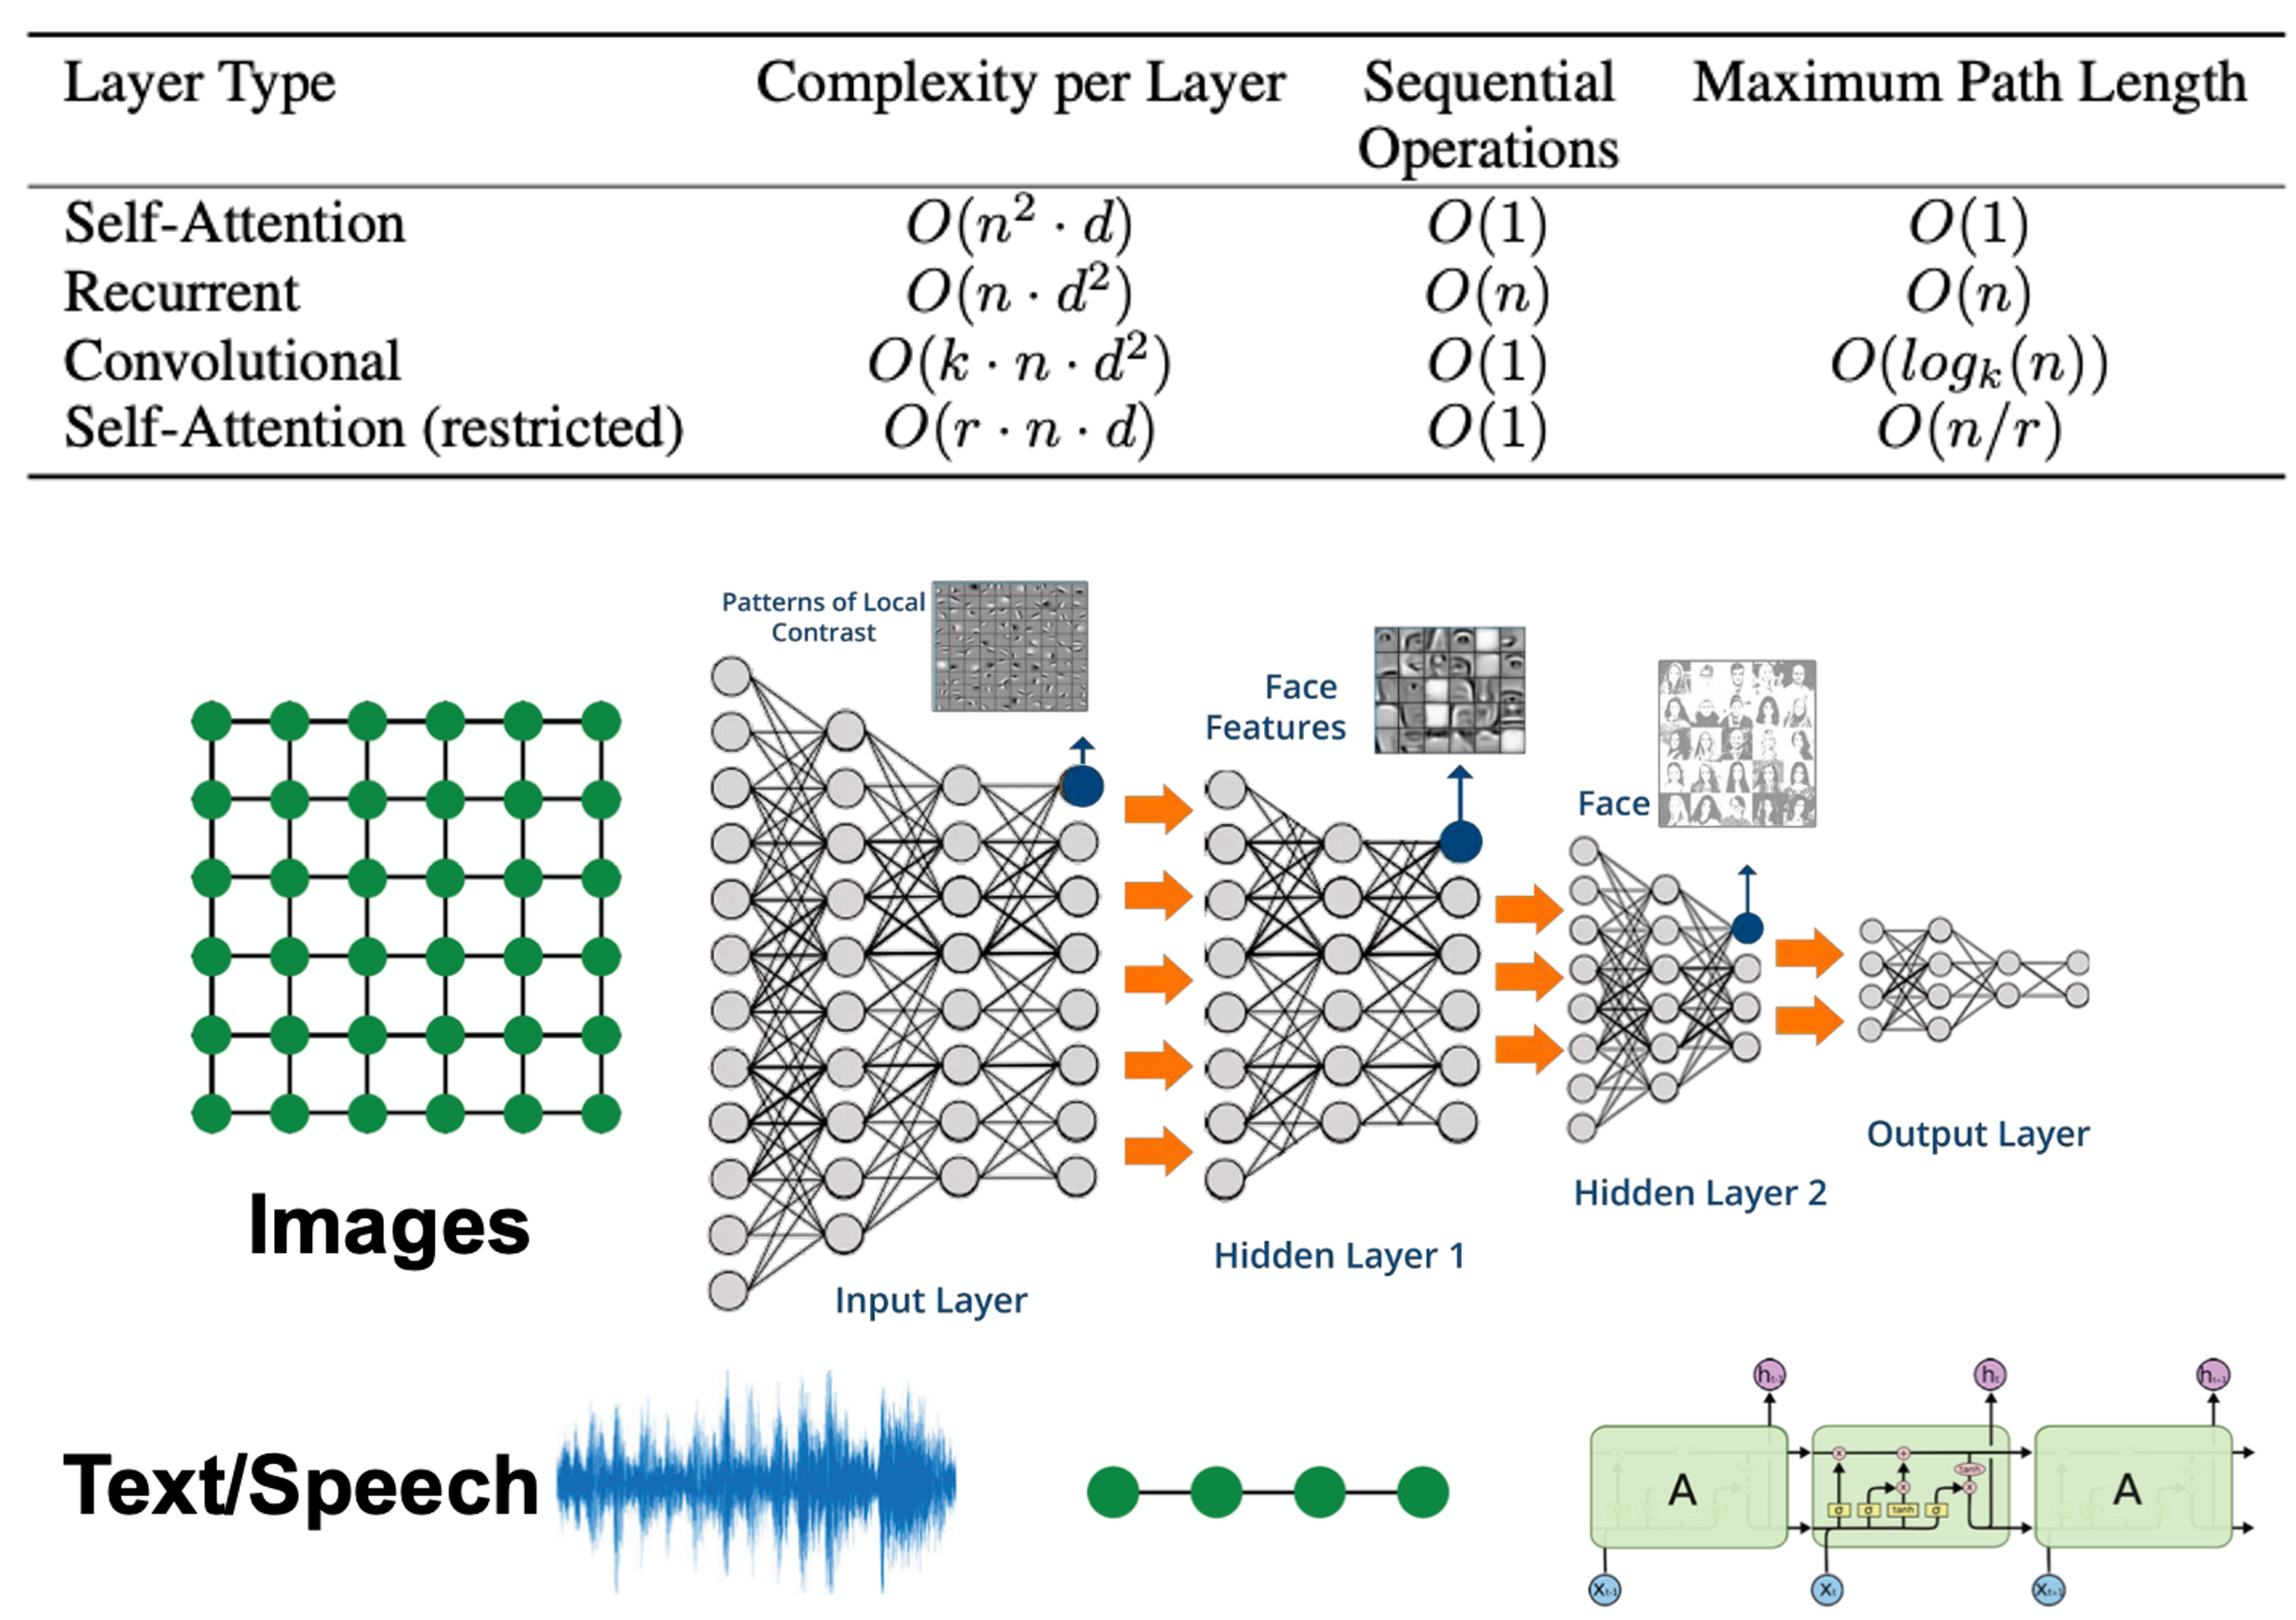
而Transformer的世界观,则是它们的理论超集——一张全连接图(Fully Connected Graph)。
它采用了最弱、最公平的归纳偏置,不预设任何关于“重要关系”存在于何处的偏见,而是为所有可能性都预留了连接的潜力,让注意力机制在学习中自行探寻“谁更重要”。
这种设计的直接优势在于,那些被CNN的局部视野所忽略、或被RNN的线性结构所稀释的长程依赖关系,Transformer都可以在一次计算中直接建模。
模型捕捉复杂全局信息的能力,正是其强大性能的核心来源之一。
后续我们看到的为Transformer添加的各类设计(如位置感知),正是在这个通用平台上,根据具体任务,重新引入必要归纳偏置的过程。
然而,极大的灵活性也带来了巨大的代价,一个最直观的体现便是模型前所未有的“数据饥渴”。
这一现象,可以从统计学习理论经典的偏差/方差困境(Bias/Variance Dilemma)视角来深刻理解。
模型的归纳偏置,决定了它在学习真实世界规律时可能犯的“错误”类型:
- 归纳偏置中与真实规律不符的部分,会导致系统性的偏差(Bias)。
- 归纳偏置过分自由,导致模型需要从数据中探索和确定的规律过多,会使其对训练样本的噪声和偶然性极其敏感,从而产生高方差(Variance)。
通常而言,强归纳偏置(如CNN/RNN)极大地压缩了模型的探索空间,但其固有的“偏见”也可能与真实规律冲突,因此呈现出高偏差、低方差的特点。
这体现为模型性能上限不高,但用相对较少的数据就能训练得不错。
相反,弱归纳偏置(如Transformer)犯的“系统性错误”更少,因此偏差很低;但其巨大的自由度也带来了极高的方差,体现为模型性能上限极高,但需要海量数据来“驯服”方差,才能学习到真正的规律。
Transformer的全连接图结构及其对数据的“饥渴”,是这一点的现实体现。
这也揭示了架构设计的终极目标:寻找并应用那些既“强”又“正确”的归纳偏置。
而我们在前文探讨的、为各类数据设计合适方法(如为序列数据引入位置感知,为周期数据引入频域机制等),正是在Transformer这个通用平台上,朝着这一理想方向努力的生动实践。
全连接图的稠密性还带来了另一个极其现实的挑战:O(n^2) 的计算复杂度。
对于一个长度为 n 的序列,注意力机制需要计算 n \times n 的交互关系,这意味着计算量会随序列长度的增加而呈二次方级爆炸。
为破解这一瓶颈,研究者们探索了三大技术路径:
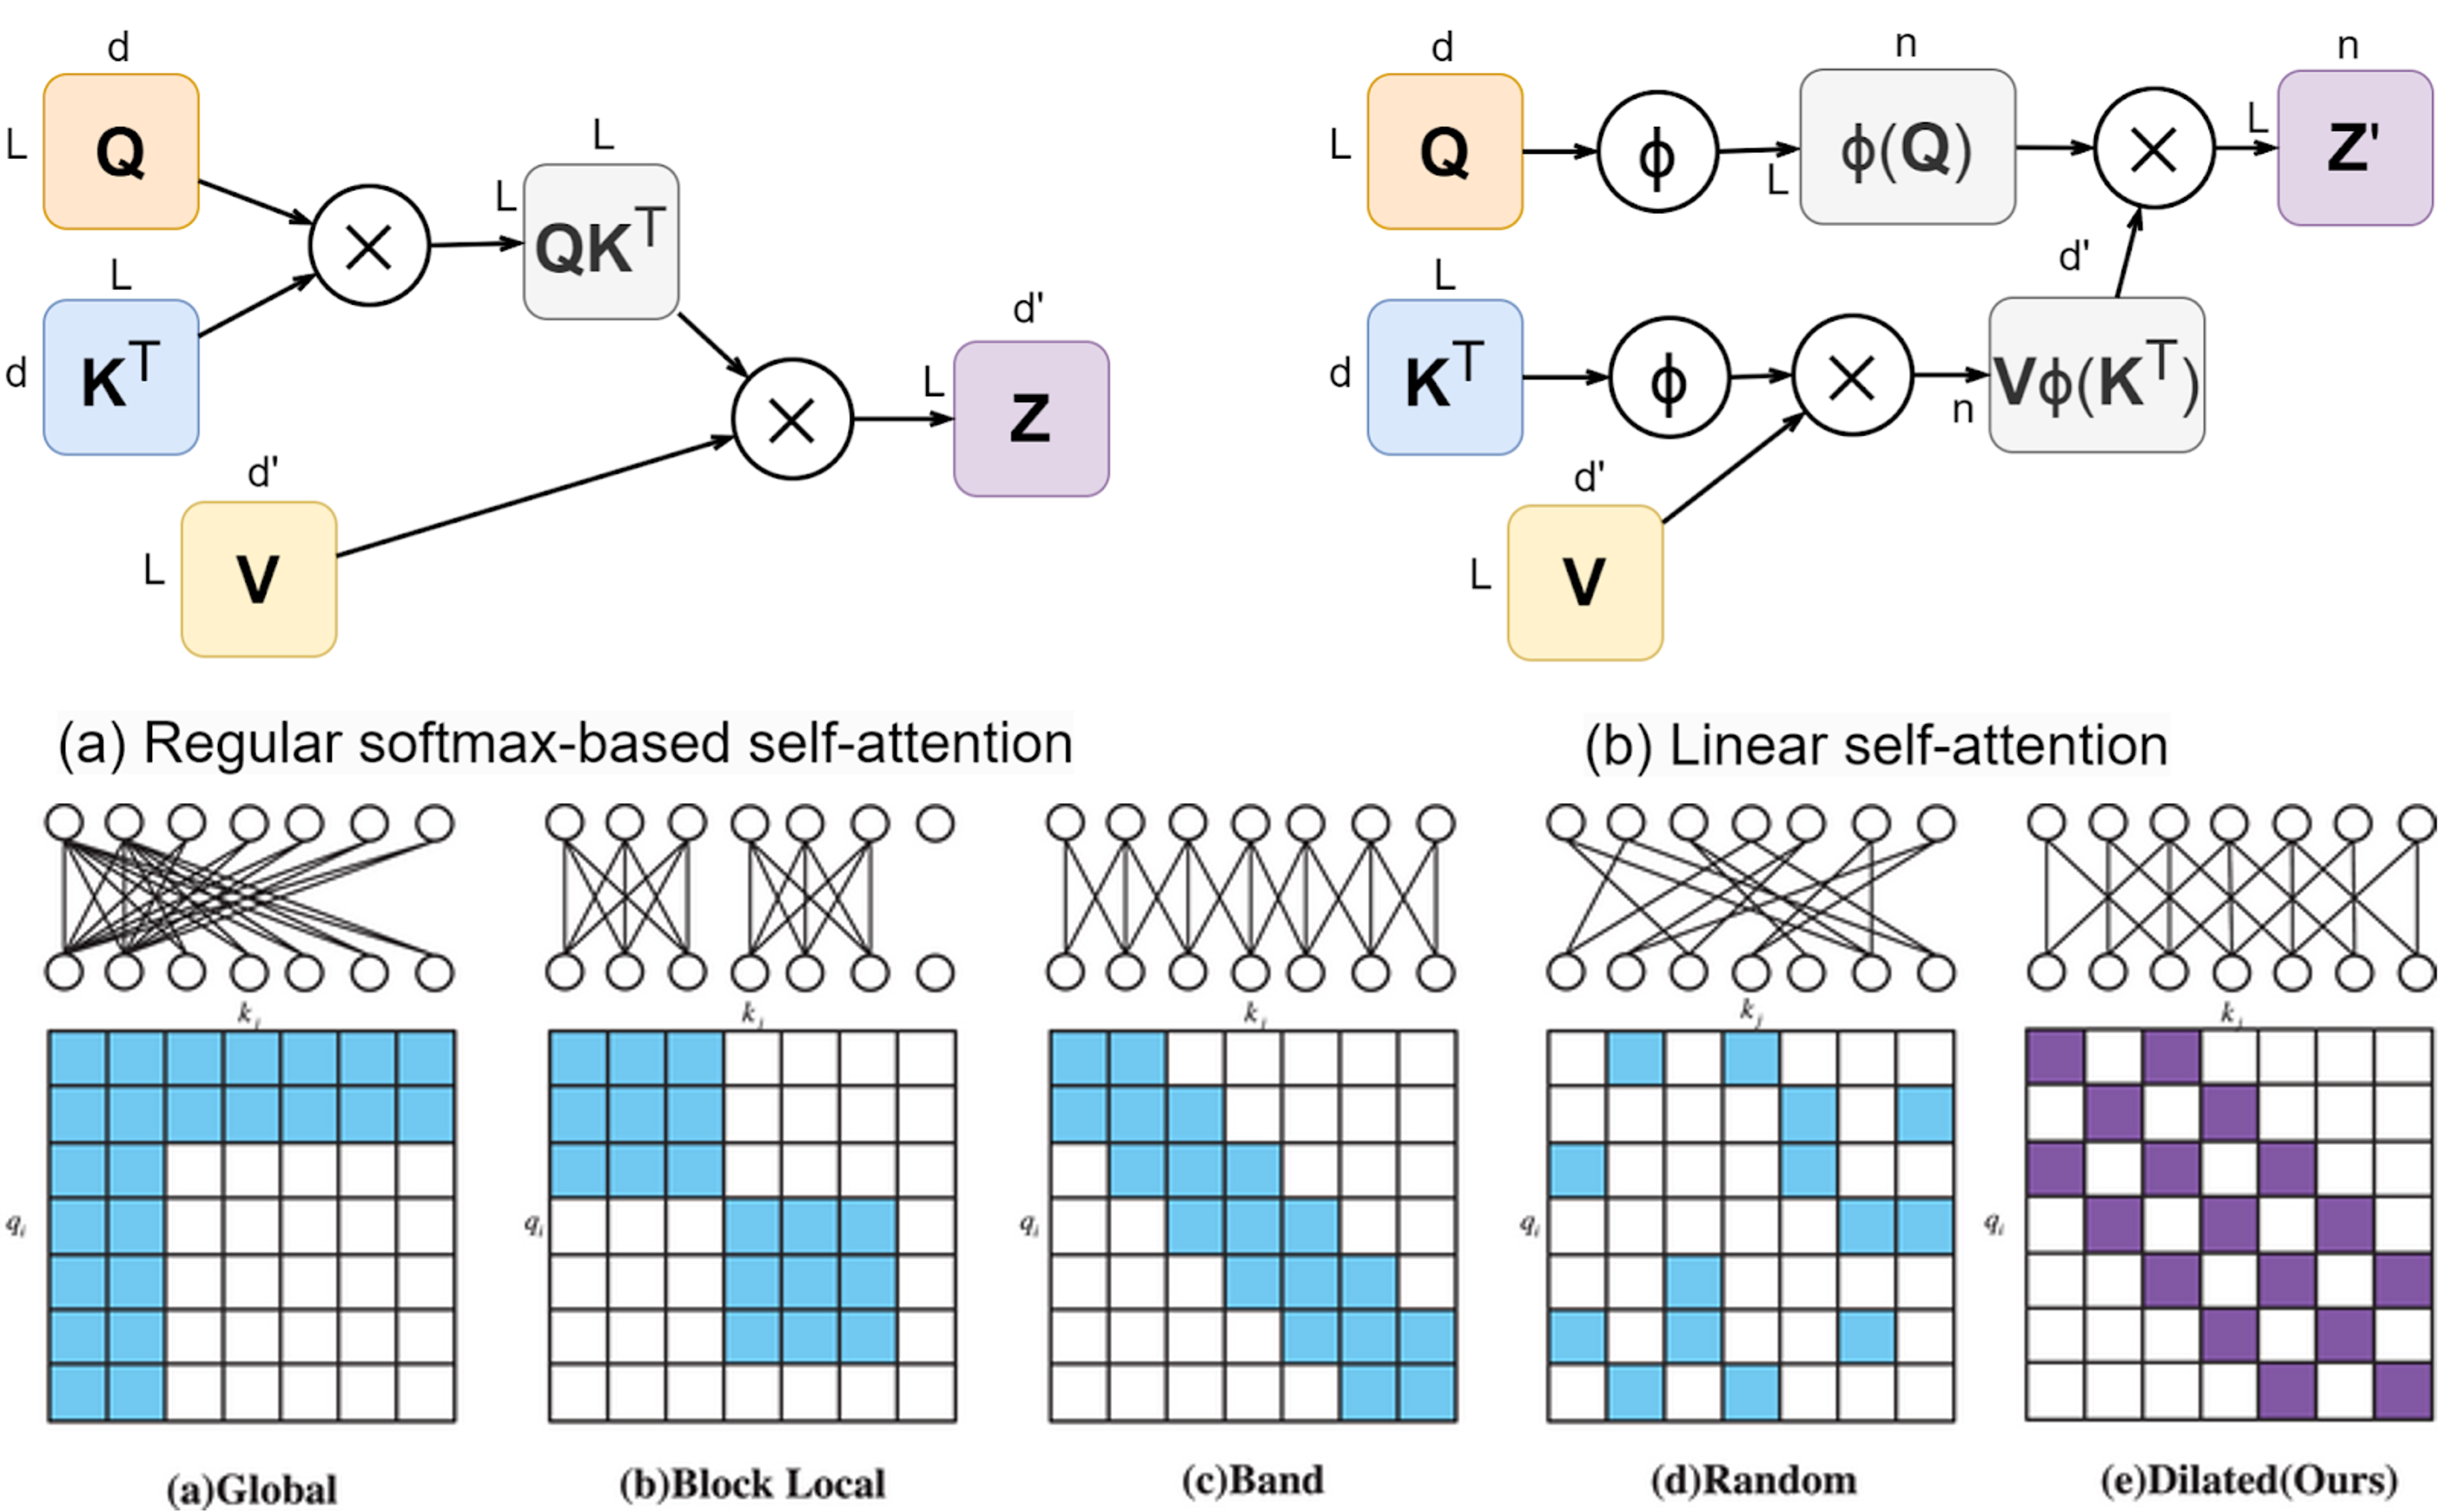
1. 以巧破力:近似注意力#
通过引入合理的数学假设(如低秩性或稀疏性),避免计算完整的注意力矩阵。
线性注意力(Linear Attention)和稀疏注意力(Sparse Attention)是其中的代表。
2. 另起炉灶:替换点积注意力#
直接用一个本质上复杂度更低、同时又能胜任特定关系建模的全新机制取而代之。
我们前面提到过的AFNO、Autoformer,以及近年来表现惊人的状态空间模型(Mamba)都属于此列。
3. 精打细算:优化计算#
计算完整、精确的注意力,但通过FlashAttention等硬件感知的底层工程优化,来极致地加速GPU的内存读写,从而实现数量级的效率提升。
刨根问底:回到模型的基石——“节点”与“边”#
至此,我们已经深入探讨了Transformer的架构哲学、实践改造与工程优化。
然而,在我们所有的讨论中,一个最根本的、我们至今有意无意回避了的问题浮出水面:我们用来构建这座宏伟大厦的“砖块”——即模型分析的基本单元——其定义本身是否就是最优的?
换成图的语言,我们必须正面回答两个一体两面的问题:
- “节点(Node)”是什么? 数据究竟应该如何被拆分为有意义的、可供模型处理的基本单元?
- “边(Edge)”是什么? 在确定了基本单元后,我们又该用何种方式来最恰当地刻画它们之间的关系?
我们之前已经看到,在不同领域,研究者们已经给出了不同的实践答案。
在文本领域,Token的定义经历了从完整的“词”,到更灵活的“子词”(sub-word),乃至最底层的“字节”(byte)的演进。
在视觉领域,ViT开创性地将图像切分为不重叠的“图块”(patch);而图块大小的选择,本身就是一次深刻的权衡——更小的图块意味着更长的序列和更精细的细节,但计算成本也随之剧增。
即使是在经典的卷积架构(CNN)中引入注意力机制时,“单元”的定义也并非唯一:
- 空间注意力(Spatial Attention): 将特征图上的每个“空间位置”视为一个单元。
- 通道注意力(Channel Attention): 将每个“特征通道”视为一个单元,让模型学习不同特征的重要性。
对“节点”的定义,远非简单的预处理,而是一次奠定模型能力上限的基础性建模决策。
这一点在地理空间智能(GeoAI)领域尤为关键。
如何定义一个城市的“基本单元”?它应该是一栋建筑、一个地块,还是一个固定大小的网格?
这个选择直接关联到地理学中经典的可变面元问题(MAUP),并从根本上影响着模型的分析结果。
当我们将遥感影像、POI点位与轨迹数据等多模态信息进行融合时,问题变得更加复杂:我们是否需要一套全新的、跨模态的Tokenization方案?
对这些奠定模型能力上限的基础性选择的深入剖析,我们将在后续专门的章节中展开。
作者信息与参考来源#
本科毕业于山东大学,现为深圳大学城市空间信息工程系,2023级人工智能专业硕士研究生。
研究方向:GeoAI、Geospatial Data Representation Learning。
深圳大学城市空间信息工程系,2023级博士研究生。
研究方向:城市产业空间。
本章节由李国隆、卢若灿负责编写,含AI工具辅助(GPT-5、Gemini 2.5 Pro),文中所用插图部分来源于网络。
封面图由即梦AI合成,prompt为:绘本插画,复古质感,正面图,肌理纹理;一个机器人手拿望远镜,透过望远镜看,放大近景特写镜头描写望远镜镜片,镜面反光,银河星际,信息流动,星星连接,有一只星光幻化的蝴蝶,奇幻神秘;背景是浩瀚的宇宙,铺满整个背景。
参考来源#
-
A. Vaswani et al., “Attention is all you need,” Advances in neural information processing systems, vol. 30, 2017.
-
A. Dosovitskiy et al., “An Image is Worth 16x16 Words: Transformers for Image Recognition at Scale,” arXiv:2010.11929. DOI: 10.48550/arXiv.2010.11929.
-
N. L. Le and M.-H. Abel, “How Well Do LLMs Predict Prerequisite Skills? Zero-Shot Comparison to Expert-Defined Concepts,” arXiv:2507.18479, 2025.
-
S. Yao et al., “Tree of thoughts: Deliberate problem solving with large language models,” Advances in neural information processing systems, vol. 36, pp. 11809-11822, 2023.
-
P. W. Battaglia et al., “Relational inductive biases, deep learning, and graph networks,” arXiv:1806.01261, 2018.
-
S. Geman, E. Bienenstock, and R. Doursat, “Neural networks and the bias/variance dilemma,” Neural Computation, vol. 4, no. 1, pp. 1-58, 1992.
-
J. Jumper et al., “Highly accurate protein structure prediction with AlphaFold,” Nature, vol. 596, no. 7873, pp. 583-589, 2021.
-
P. Schwaller et al., “Molecular transformer: a model for uncertainty-calibrated chemical reaction prediction,” ACS Central Science, vol. 5, no. 9, pp. 1572-1583, 2019.
-
Y. Zhan, Z. Xiong, and Y. Yuan, “RSVG: Exploring data and models for visual grounding on remote sensing data,” IEEE Transactions on Geoscience and Remote Sensing, vol. 61, pp. 1-13, 2023.
-
S. Jiang, H. Lin, H. Ren, Z. Hu, L. Weng, and M. Xia, “MDANet: A high-resolution city change detection network based on difference and attention mechanisms under multi-scale feature fusion,” Remote Sensing, vol. 16, no. 8, p. 1387, 2024.
-
K. Bi, L. Xie, H. Zhang, X. Chen, X. Gu, and Q. Tian, “Pangu-Weather: A 3D high-resolution model for fast and accurate global weather forecast,” arXiv:2211.02556, 2022.
-
J. Leskovec, CS224W: Machine Learning with Graphs. Stanford University.
校稿:黄菲