Wiki Foundations3 Concepts and Frameworks of AI
3.5 潜空间与表示学习
机器的内在世界:从表征到潜空间#
我们在第一章中提到过,连接主义(神经网络)的灵感源于生物大脑中神经元活动的逻辑,希望通过模仿大脑的结构和功能创造出人工智能。自 GPT-4 问世以来,大模型的迅速发展让人们看到了机器智能逼近人类智能的可能。
然而一个问题始终存在争议:这些模型究竟是在鹦鹉学舌,还是在某种程度上真正理解了语言及其生成的内容?
这个争议的背后,其实隐含的是对人工智能更深层的叩问:机器能否建立起属于自己的“世界模型”?
所谓世界模型,是智能系统在内部形成的一种世界的模拟:它能预测未来、规划行动、理解因果。
人类的大脑无疑拥有这样的能力——当我们看到一个杯子被推倒时,哪怕它尚未落地,我们已经能在脑中预测出接下来的情景。
这种预测力表明,大脑内部存在某种结构化的机制,用来表示和操控外部世界。因此,要理解机器如何可能拥有类似的机制,首先需要明白这样的内部模型在生物体中是如何实现的。
人类如何在脑中“建模”世界#
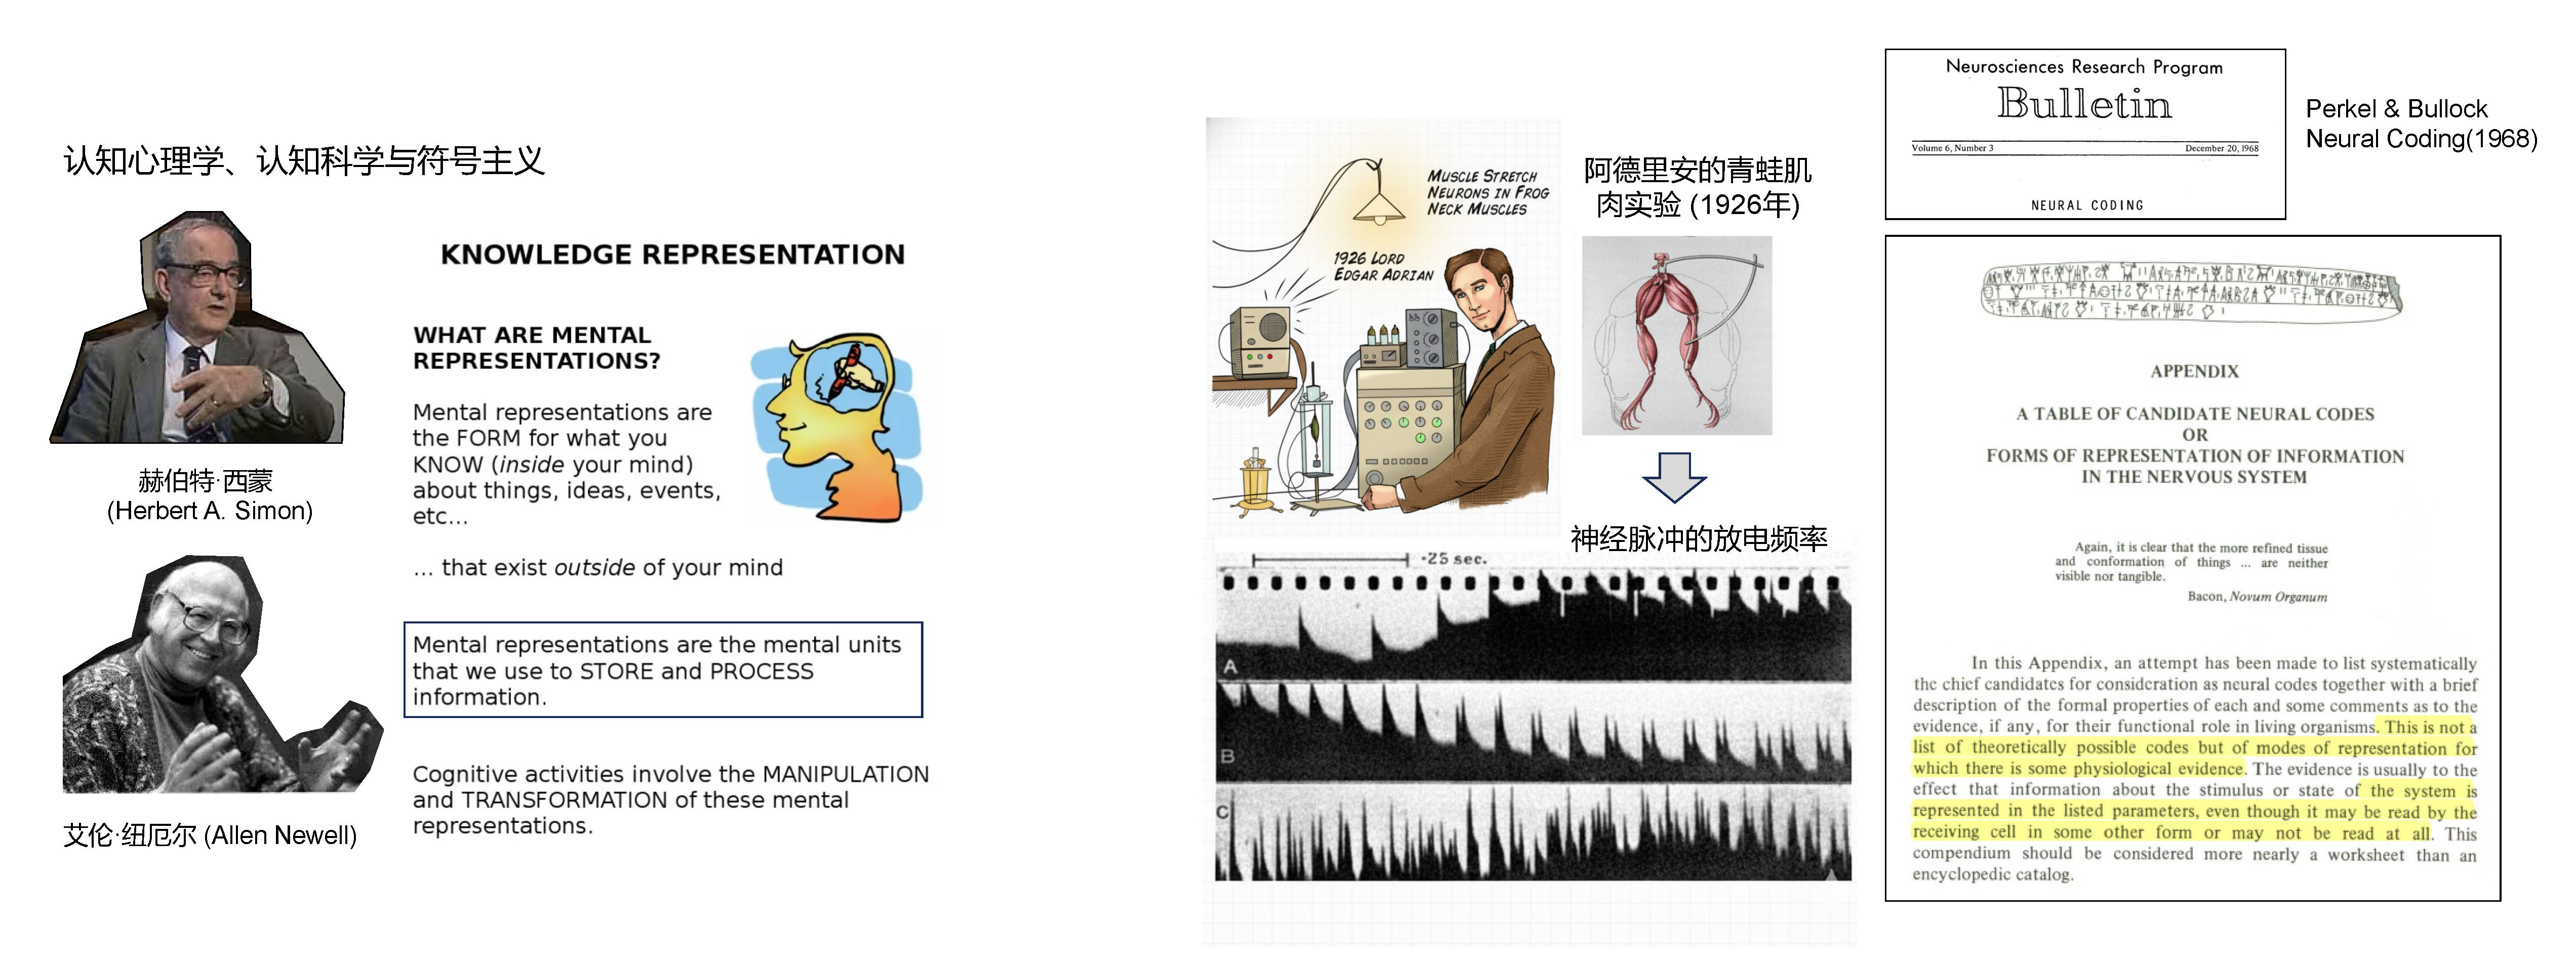
人类对世界的理解源于大脑中不断建构、更新的内部表征(Representation)。
当感官系统接收外部刺激(光、声、气味等),大脑不会存储原始信号,而是把它们转化为神经元群体的活动模式。
神经元以放电的时间、频率与群体构型编码刺激特征(如亮度、方向、音高、气味成分)。
在神经科学中,这一转化过程被称为神经编码(Neural Coding);这些神经元的放电模式就是外界信息在大脑中的表征。
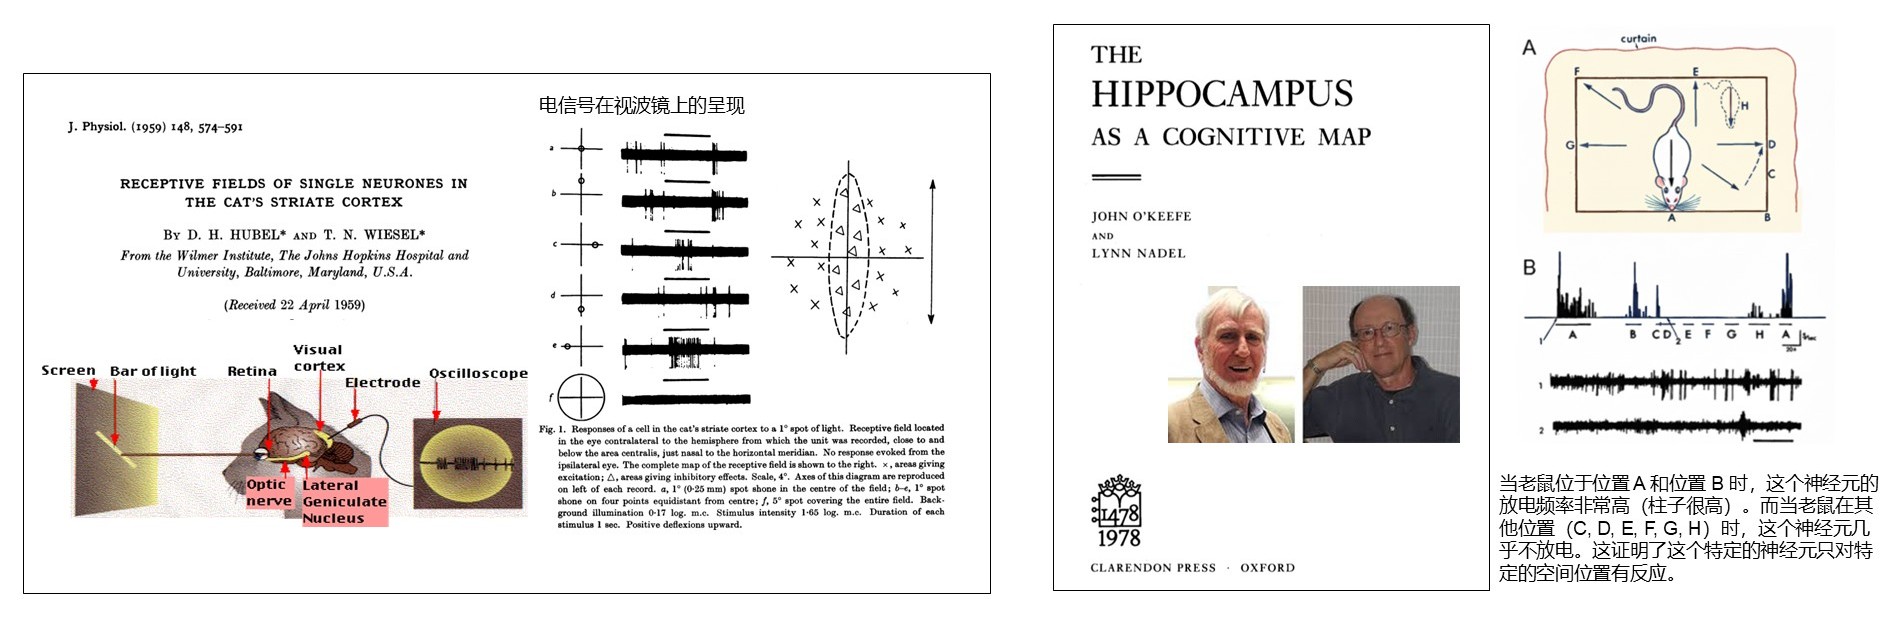
例如,初级视觉皮层(V1)中的神经元对不同方向的边缘具有选择性;海马体的“位置细胞”在动物处于特定地点时被激活,呈现空间的内部地图。
更重要的是,这些表征是动态的:大脑基于经验生成对外界的假设,并用感官输入校正误差。
预测编码(Predictive Coding)描述的正是这种机制——我们感知到的世界,是内部模型与外部信号相互作用的产物。
AI 的“内部世界”:表征的数字版本#
AI 模型作为数字计算机,以另一种物理形式重演了这一过程。
当我们用成千上万张图片、文本或声音去训练一个模型时,它并不是直接“记住”每一张图或每一句话,而是在参数的更新中学习数据之间稳定而可预测的关系结构。
随着训练误差的减少,模型逐渐形成了统计意义上对世界的“抽象理解”:模型神经元(或称参数权重)的不同激活模式负责编码输入数据的特征。
例如,图像模型的低层网络单元对边缘和颜色敏感,更高层则逐渐响应完整的形状与语义;语言模型的各层向量则在字词之间建立出隐含的依存与关联。
这些被训练出的权重数值模式,构成了 AI 理解世界的一种数字化的表征系统。
尽管人脑和计算机的表征方式有所差异:大脑的表征以神经放电为载体,而 AI 的表征以数字向量和张量存在,但它们的功能却十分相似:都把外部世界转化为可在内部操作的形式,都以不断的预测与修正为核心机制。
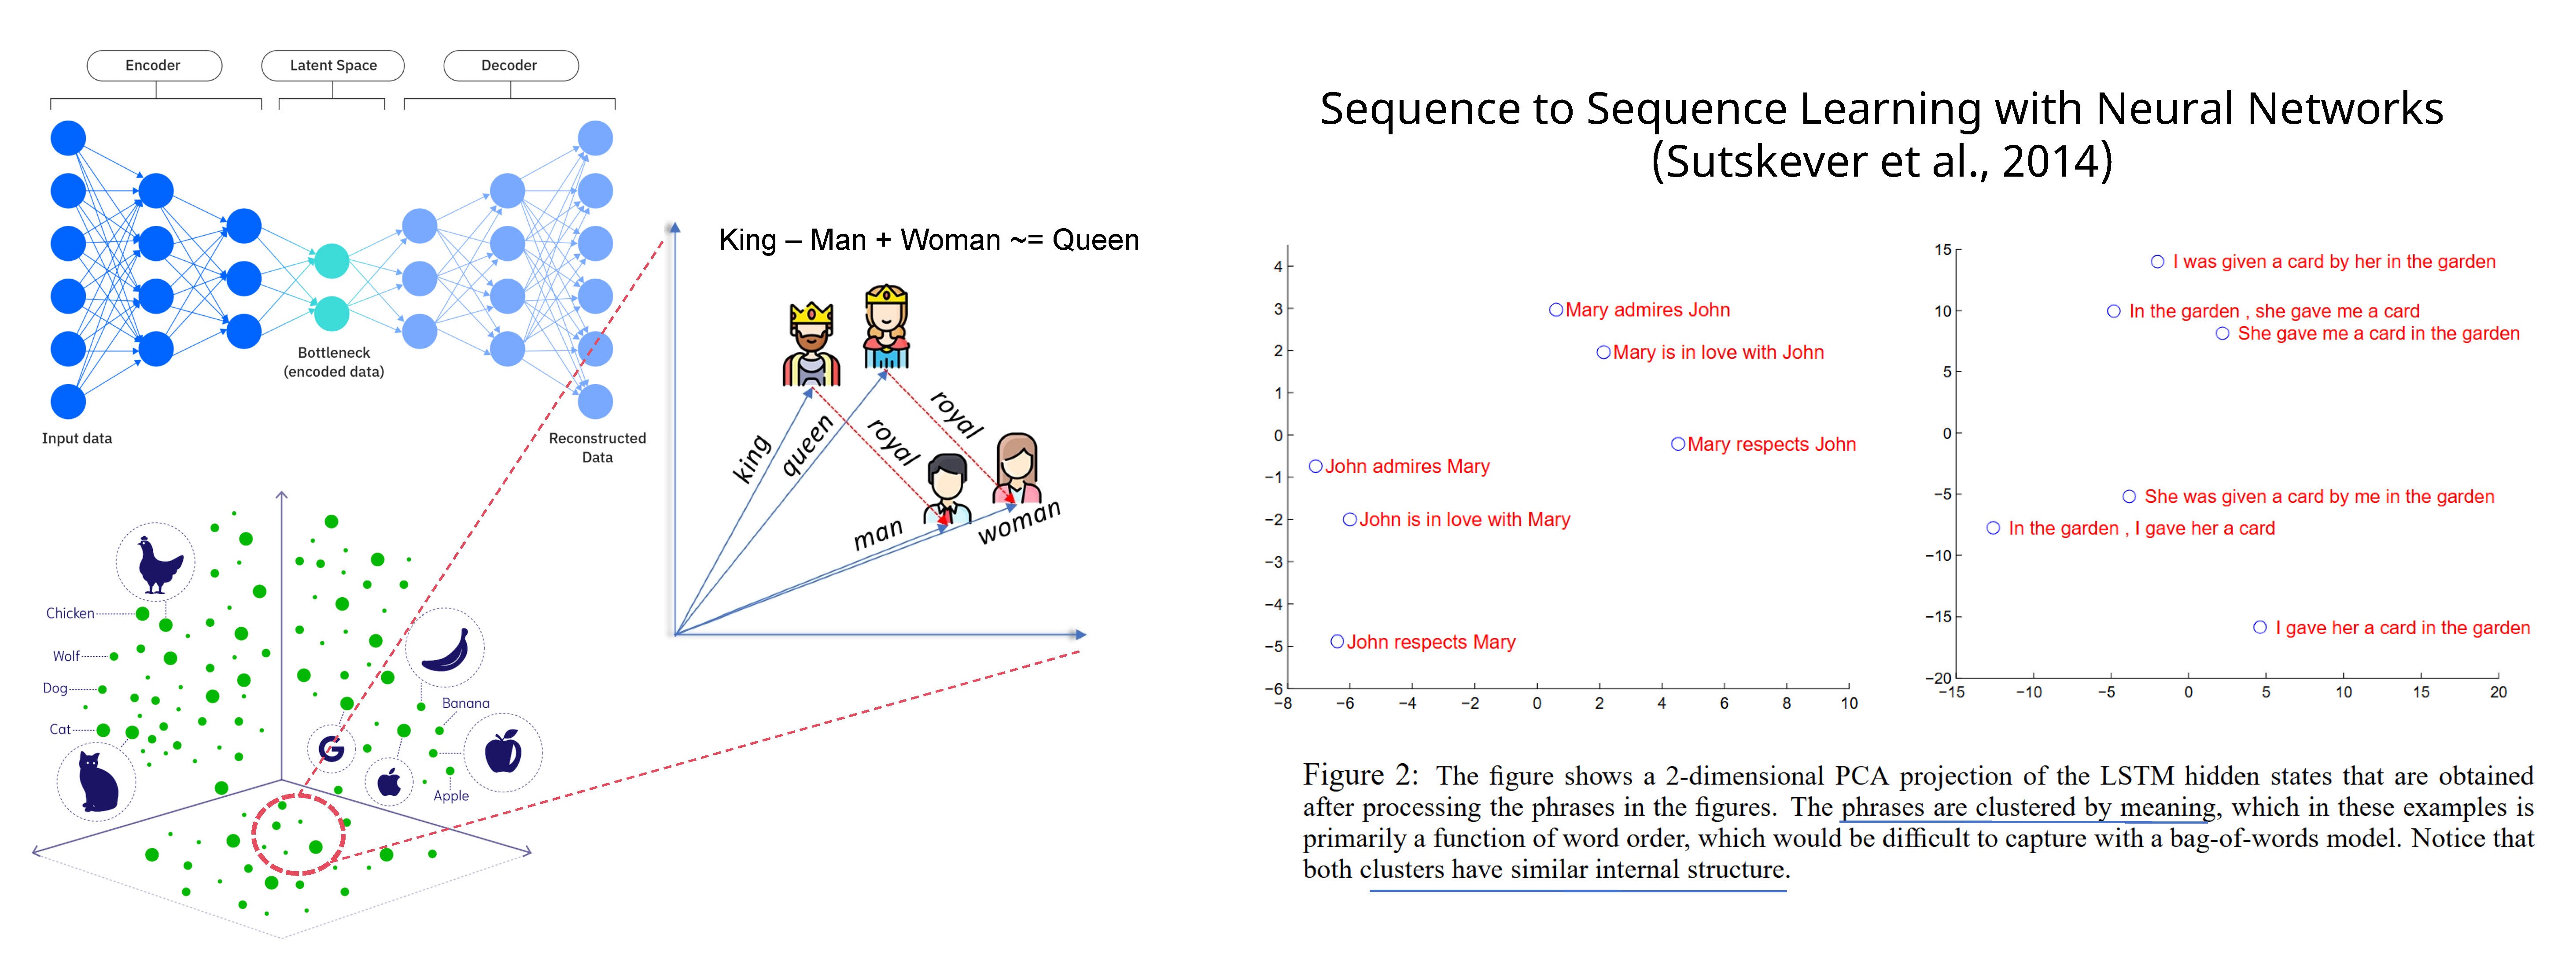
经过训练后,模型学到的模式与结构会被压缩进一个抽象的多维向量空间——潜空间(Latent Space)。
在这个空间中,每一个数据样本都对应着一个点(向量),语义或形态相近的样本彼此靠近,不同的类别被自然分离。
这就是机器的“内部世界”,一个用数字结构组织起来的世界模型的雏形,它存储着模型从数据中提炼出的核心结构与特征,模型以它为参考系去推理、判断与生成。
“潜空间”究竟藏了什么?#
从字面解析,“latent”意为“潜在的”“不可直接观测的”。
这个概念最早出现在统计学与心理测量学中,用以描述那些无法直接测量但能影响观测结果的变量。
1969 年,心理计量学家 Fumiko Samejima 在其研究中使用了“latent ability”这一术语:我们无法直接测量一个人的阅读能力,但可以通过考试成绩去估计它。这种被推测而非直接观测的量,便是潜变量。
随着概率建模与机器学习的发展,研究者将这种思想形式化为潜变量模型,并进一步发展出今天的变分自编码器(VAE)等生成式模型框架。
再来看“space”(空间),其在数学中指的是带有结构的集合。当数据被映射入这个空间,样本之间的距离与方向承载关系与差异。
但现实世界的复杂性,使得“相似”或“不同”的定义远非二维空间所能描述,也不是我们能想象的立体世界,它可能有上百、上千个维度,是一个抽象的结构。
因此我们无法在感官层面看到它的形状,只能通过数学和可视化手段去理解它的结构。
(注:大家所能看到的坐标系只是对表示向量降维后形成的粗糙、近似观测的潜空间分布情况。)
这正是 latent space 名称的由来:它存在,却无法被直接感知。
现在我们知道,latent space 是由许多高维向量构成的集合,是模型内部世界的数学形式。
问题随之而来:这些高维向量从何而来?它们的“坐标轴”与“走向”由谁决定——也即,模型的“世界观”从何而来?
从特征工程到表示学习:谁在决定模型的“世界观”#
在早期的机器学习时代,模型看到的世界是人为定义的。
研究者分析问题、挑选特征,再把它们输入算法。对图像,我们提取边缘、纹理;对文本,我们统计词频、构造 n-gram。
例如,要让模型区分“猫”和“狗”,人们会先在一张 100×100 的灰度图中,计算每个区域的边缘方向、纹理变化,再把这些统计量拼成一串数字,如 [0.12, 0.08, 0.03, …]。
模型并不真正“看”图像的像素,而是在这组由人挑选的数字中,寻找区分猫与狗的边界。
换句话说,早期模型的潜空间坐标系是人定的——哪些维度存在、哪些特征重要,都被预设。
这种方式的局限很明显:当任务或数据分布变化时,人类必须重新设计特征。机器并没有“学习”世界的结构,只是在执行我们定义的判断。
深度学习的出现,改变了这一点。
它不再依赖人工特征,而是通过多层神经网络,从原始数据中自动学习出描述世界的方式。
仍以“猫”和“狗”为例:模型不需要我们告诉它要看耳朵形状或毛发纹理,而是从像素出发,逐层提炼出区分它们所需的信息。
最底层的神经元对简单的边缘或颜色变化敏感;中层组合成更大的局部形状;高层则逐渐捕捉面部结构或姿态这样的抽象概念。
最终,这些层层抽象沉淀为一组模型自行学得的高维向量——模型的内部表征。
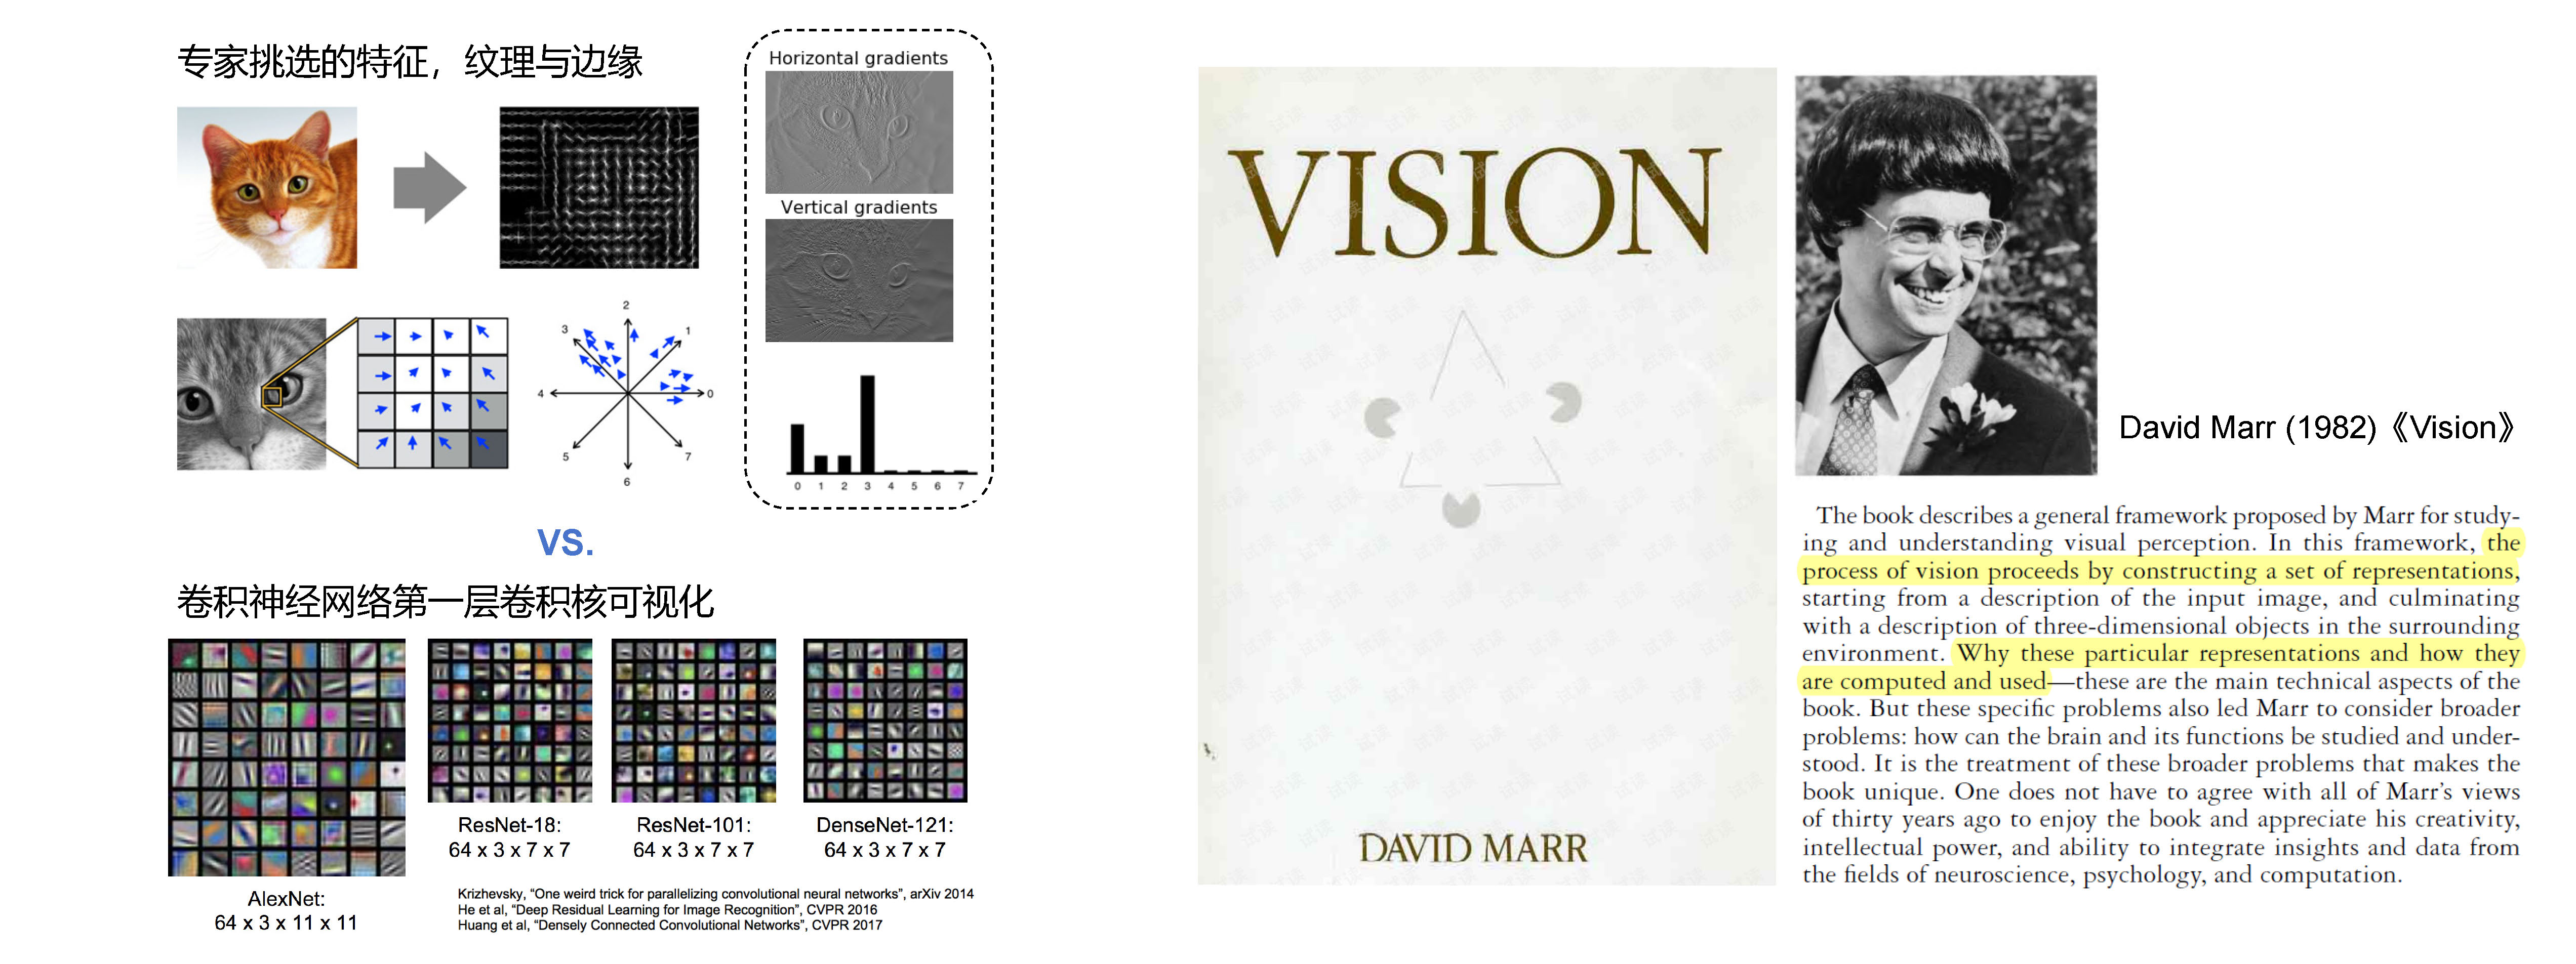
这正是表示学习(Representation Learning)1的要义:让模型在数据中自己发现稳定、可计算的表达方式。
换句话说,深度学习的本质,就是表示学习——机器不再依附于人造特征,而是在数据中自行构建理解世界的“坐标系”。
训练范式如何塑形 Latent Space#
既然模型的潜空间来自训练过程,那么不同的训练方式是否会塑造出不同的世界?
答案是肯定的。
不同的训练范式,就像不同的“认知方式”,它们决定了模型在潜空间中如何组织世界。
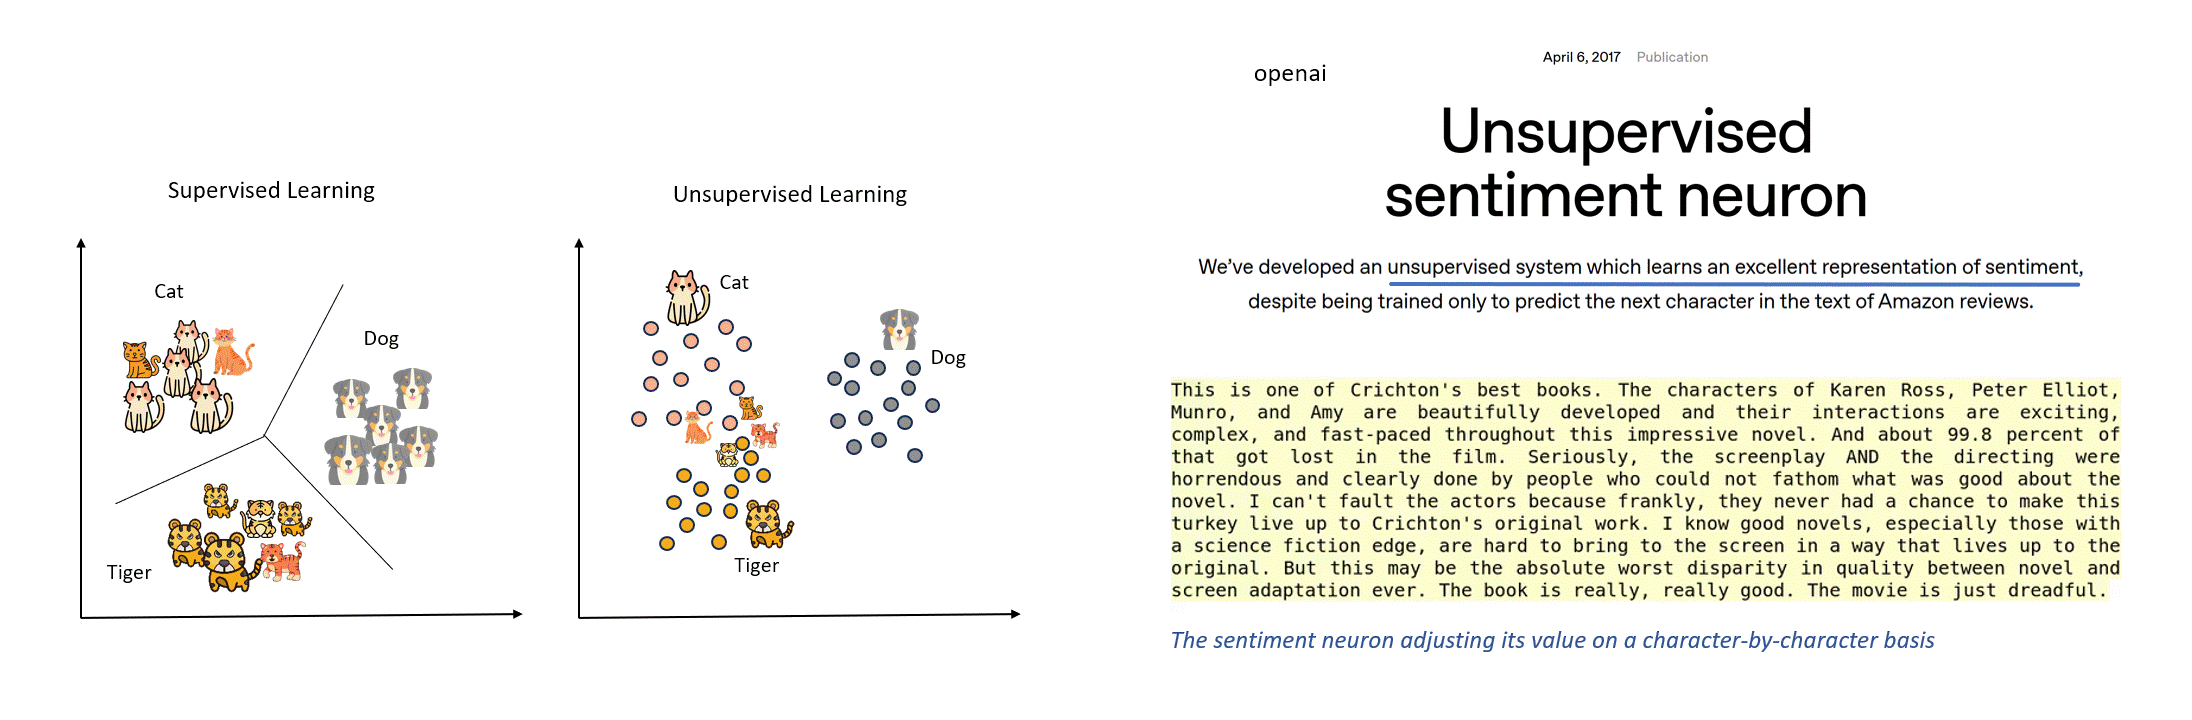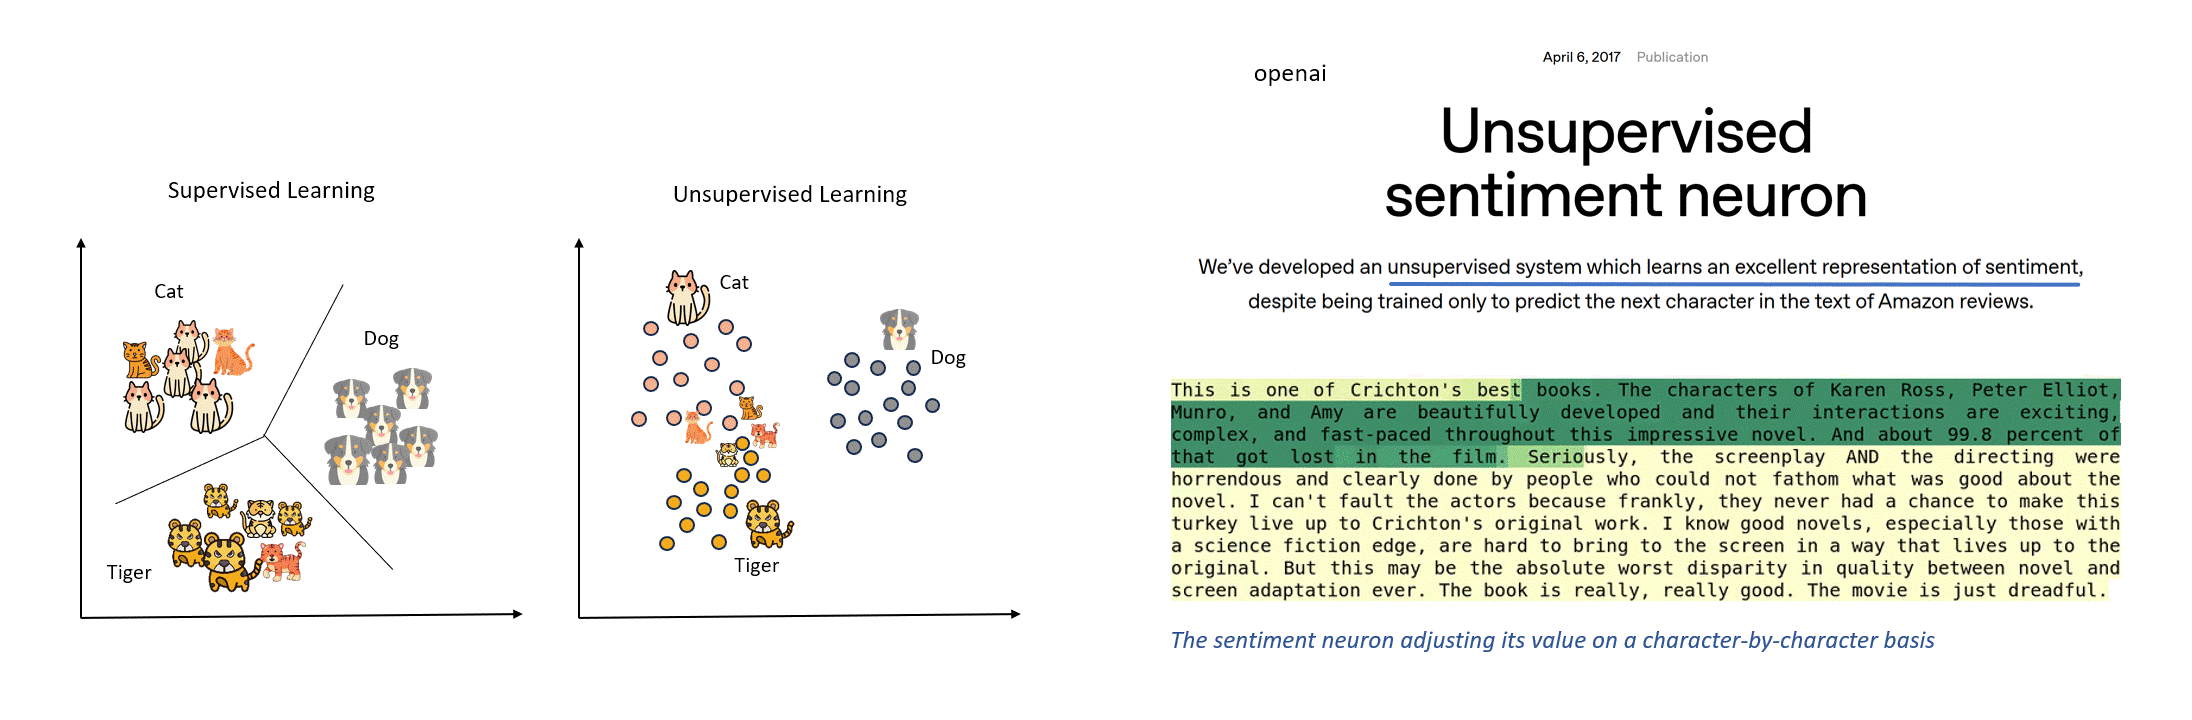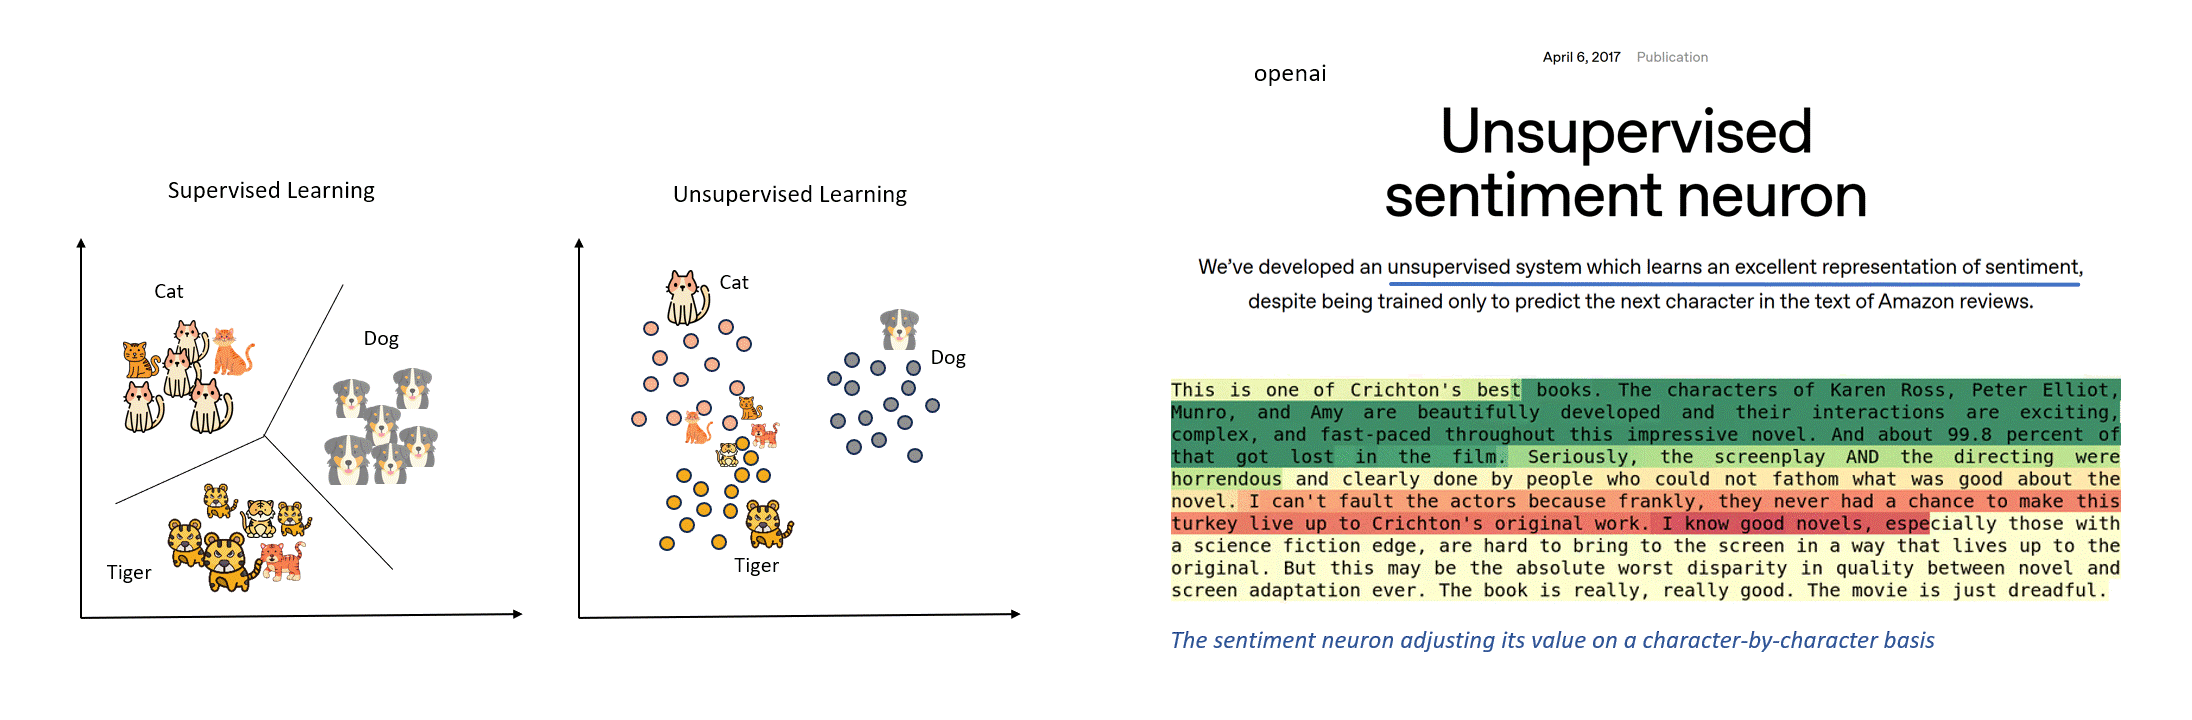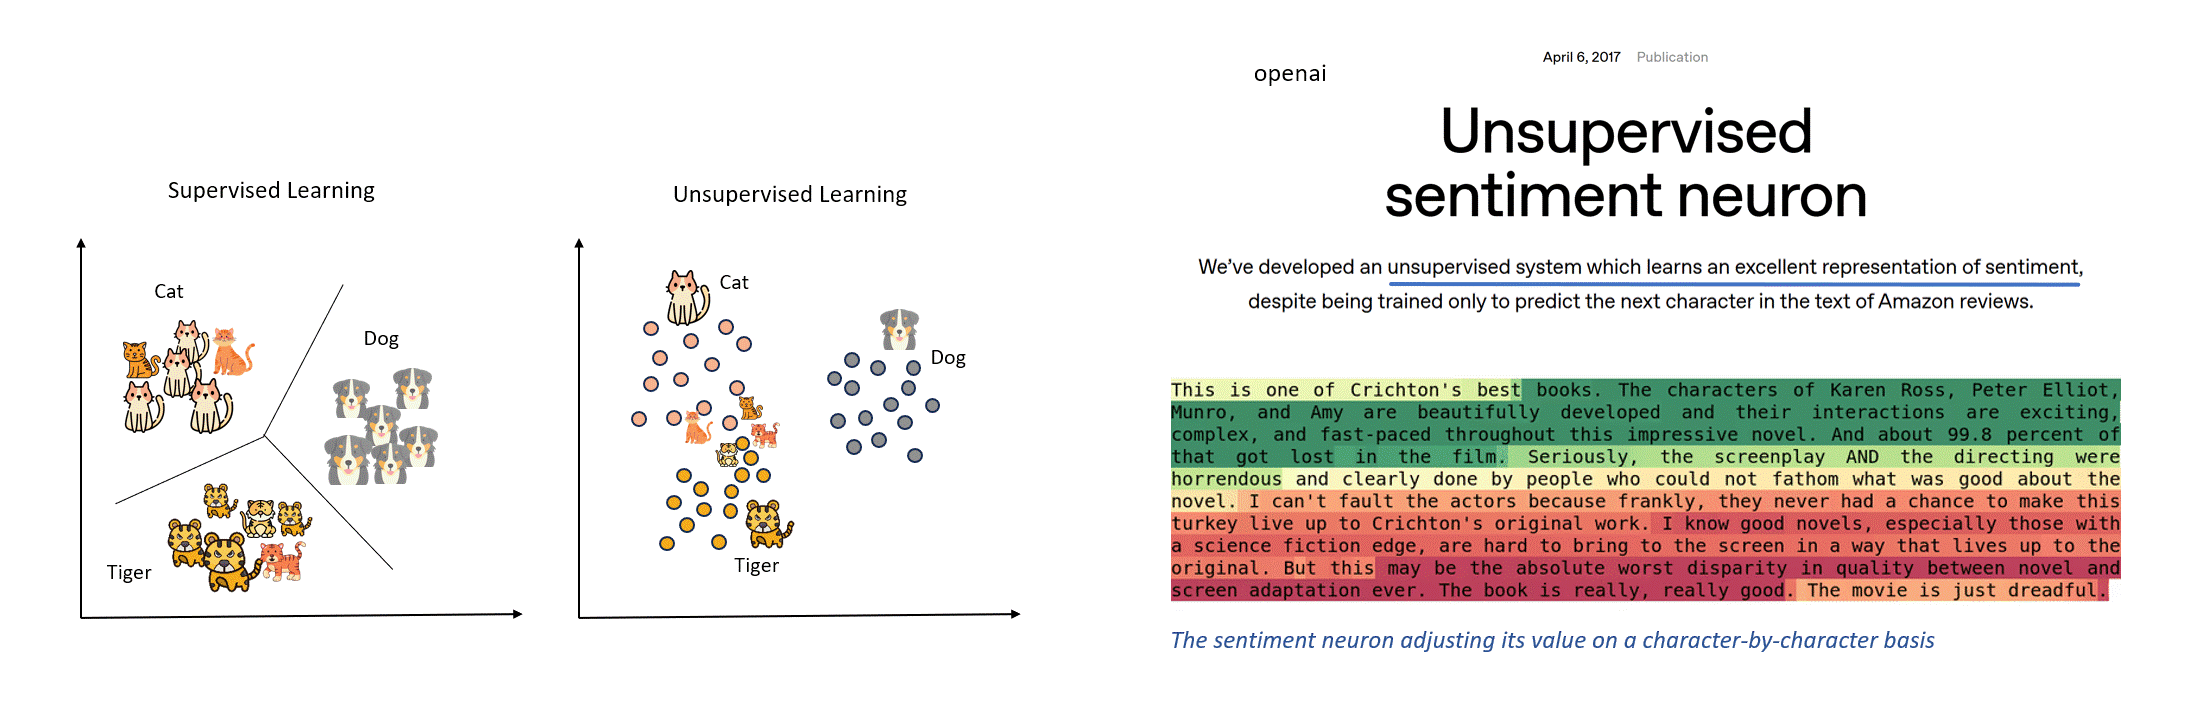
监督学习:用标签划出边界#
在监督学习中,每个样本都有明确的答案。
模型通过最小化分类误差,把同类样本聚在一起、不同类样本分开。
于是 latent space 呈现出清晰的分区结构:“猫”是一团,“狗”是另一团。
这种空间对分类极其高效,却缺乏连续性。模型学到的是“如何区分”,但并不知道“猫”和“老虎”的形态连续变化,也无法理解“森林”和“树”的层级关系。
自监督学习:从结构中自悟规律#
如果没有标签,机器还能学习吗?
自监督学习的回答是——可以,而且学得更深。
这类方法不依赖外部标签,而是利用数据自身的结构生成“自我监督”的任务。
它们迫使模型去推测“数据是如何存在的”,也就是学习世界的生成规律。
典型的例子包括:
- MAE(Masked Autoencoder): 通过遮盖图像部分内容让模型重建原图,实际上是在学习“一个物体由哪些局部组成”“缺失部分如何从整体推断”;它学到的不是标签意义上的“猫”和“狗”,而是“像猫的结构”“像狗的形状”。
- Word2Vec / GPT 的自回归目标: 通过预测上下文或下一个词,模型学习语言的内部组织规律。
这种方式得到的 latent space 更连续、更具结构性,也更可泛化。
它能同时支持分类、检索、生成等任务,因为它捕捉到的是世界的组织逻辑,而非单一标签。
但现实世界的数据分布复杂、熵高、噪声重。有用的信息往往稀疏,隐藏在大量冗余特征之下。
如何让模型在这种高噪声环境中仍能捕捉到稳定的结构,成为表示学习持续探索的核心问题。
一个“好的” Latent Space#
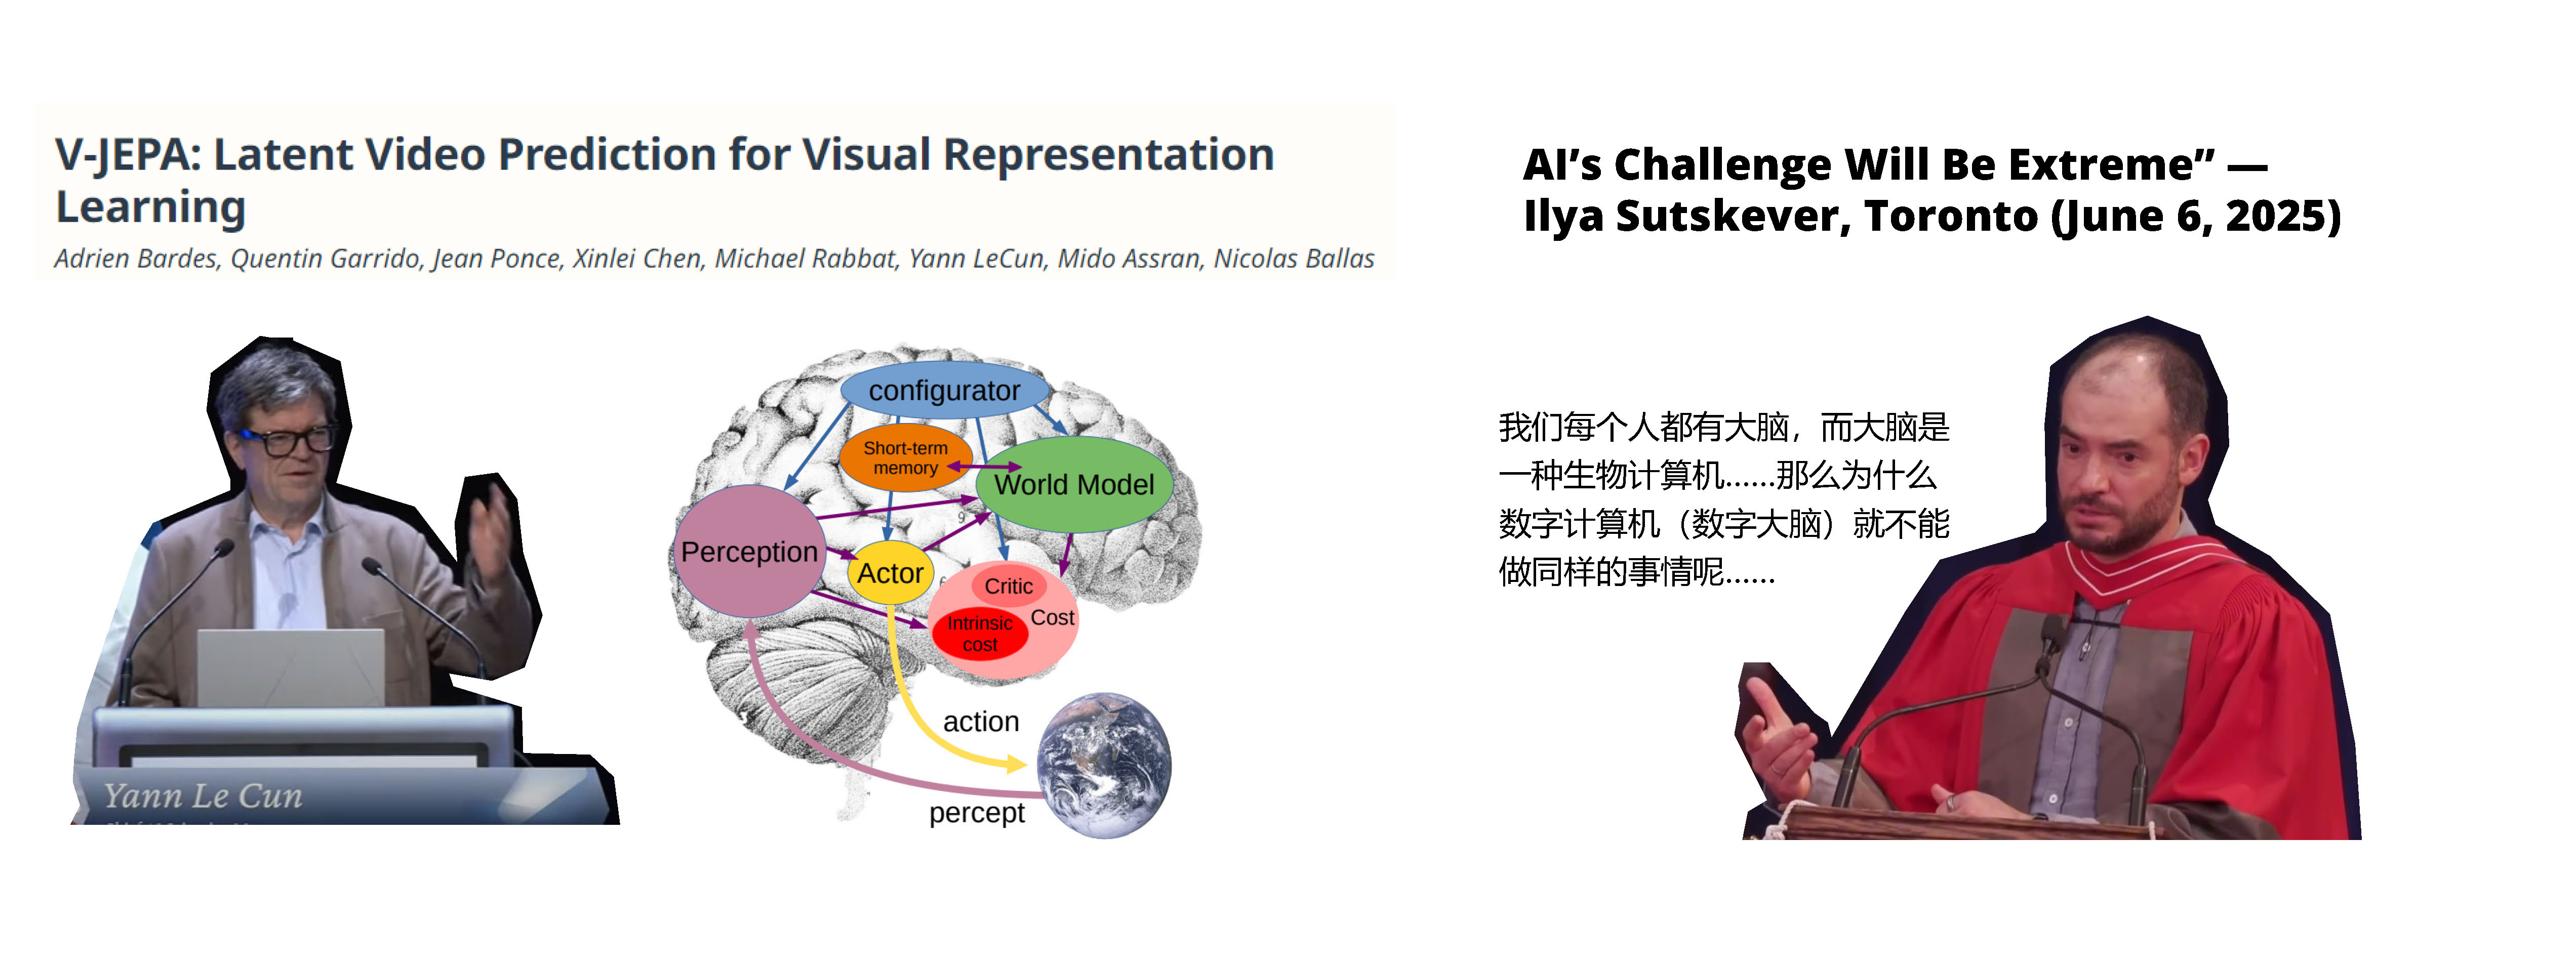
如果从 Ilya Sutskever 的观点出发:
A good representation = a compressed, predictive model of the world.
智能的本质,是对世界统计规律的压缩与建模。
如果这一点成立,那么,一个好的 latent space,应当是对世界稳定结构的最小描述。
这样的空间具有三个特征:
- 压缩性(Compression): 用最少的信息量捕捉最关键的模式。
- 平滑性(Continuity): 相似样本在空间中彼此靠近,连续变化对应平滑轨迹。
- 可预测性(Predictiveness): 在空间中沿某一方向移动,意味着现实中有意义的变化。
当潜空间具备这些性质时,复杂的问题会呈现出简单的几何形态:不同概念自然分布于不同方向,相似事物聚合成簇。
这意味着模型不仅“记住”数据,更理解了它们之间的组织逻辑。
其实,无论是大脑还是 AI,它们都在尝试同一件事:用有限的内部结构去模拟无限复杂的外部世界。
这背后隐含着一种信息论思想:表示学习的目标,是在“压缩输入”与“保留预测能力”之间找到平衡。
如果 latent space 太小,信息被压缩得过头,模型失去了预测力;如果太大,模型只是记忆输入,没有抽象能力。
一个好的 latent space,就在这两者之间:它舍弃偶然,保留必然。
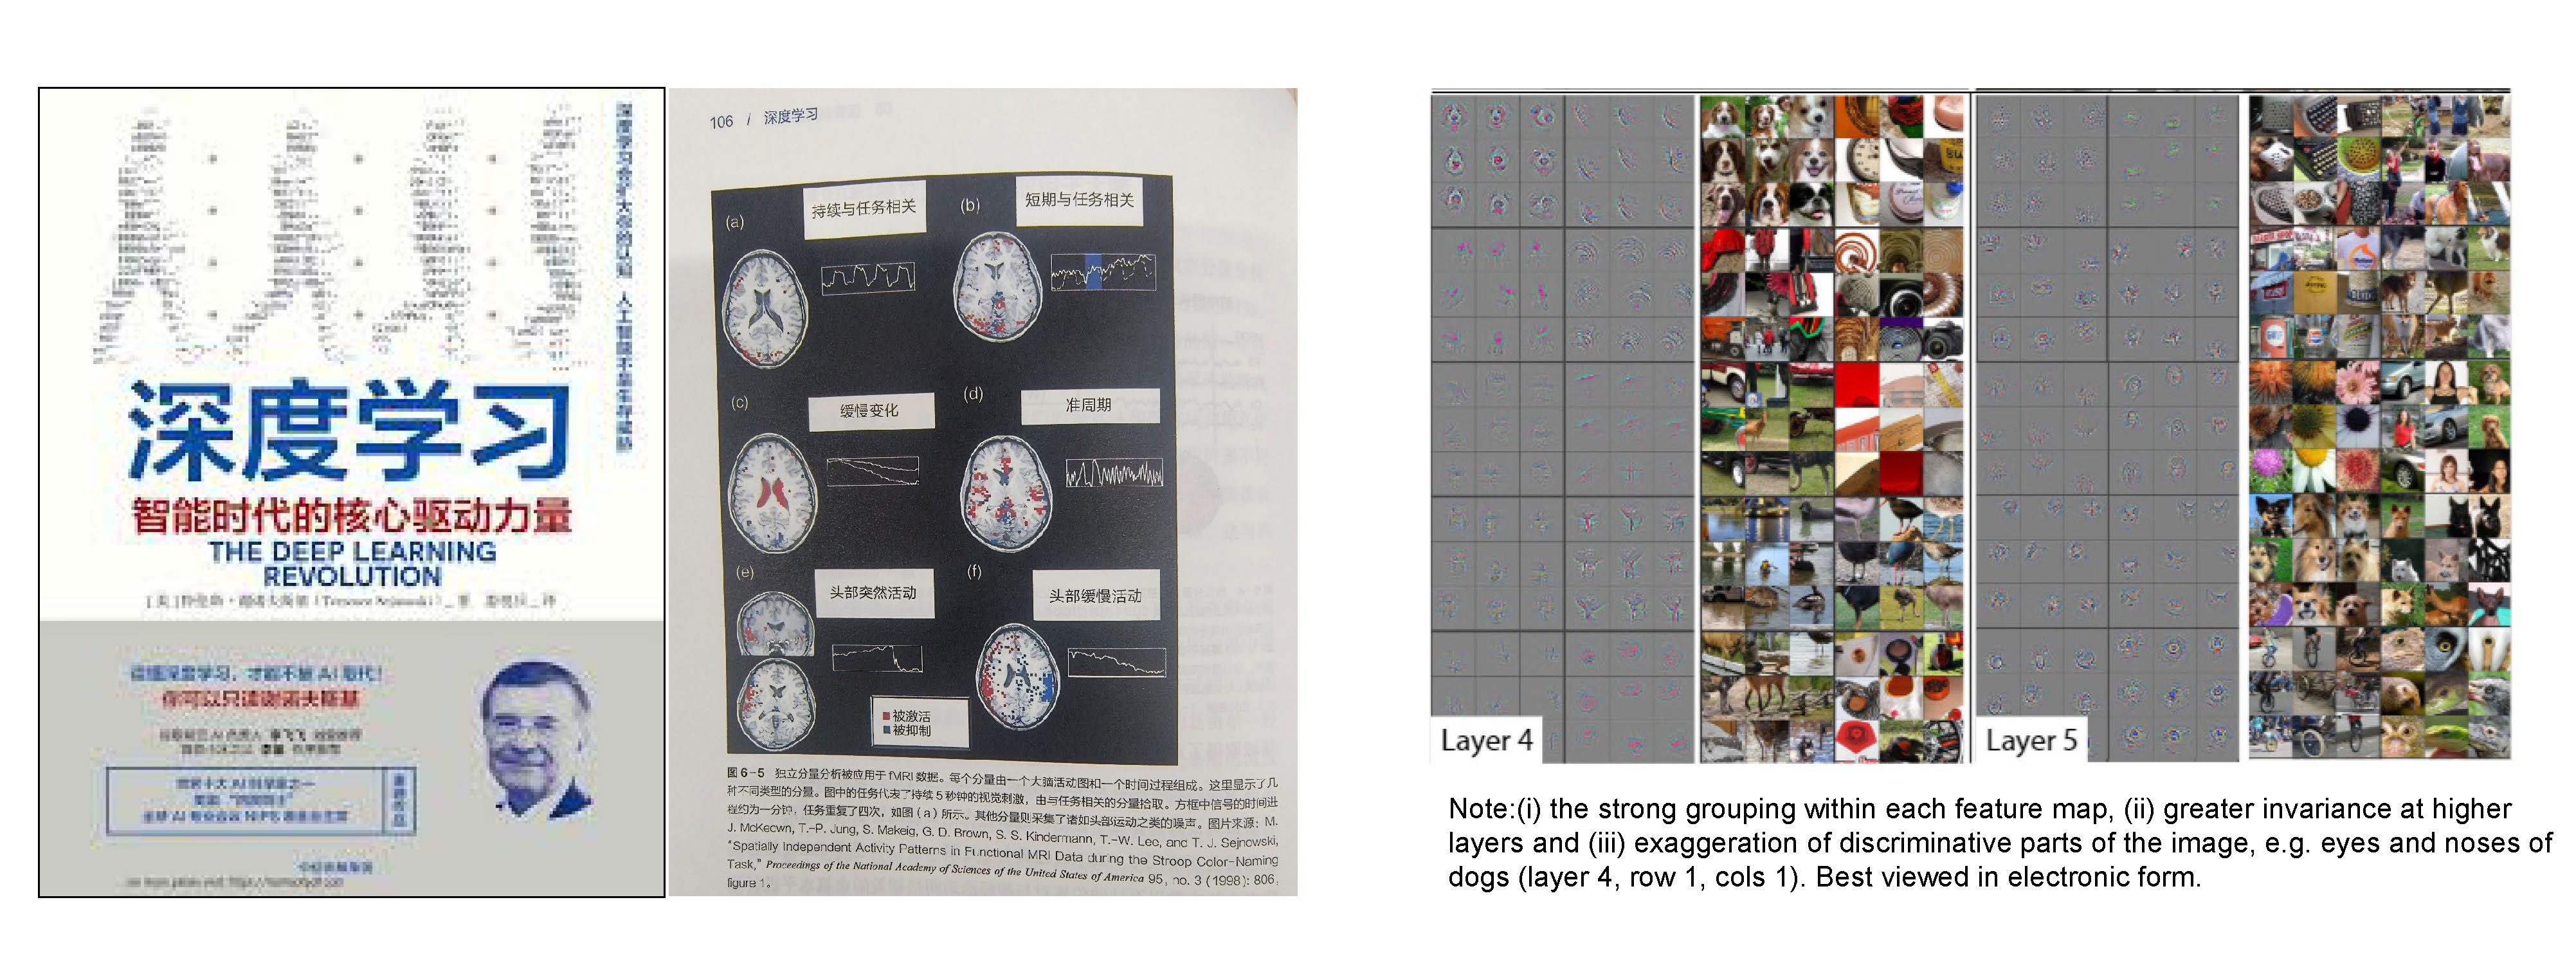
大脑很神奇,latent space 同样很神奇。
那么,我们能在 latent space 中做什么?
答案是,模拟与预测世界:当我们在嵌入空间而非像素空间里做预测/规划时,世界模型才真正运转起来。
例如,谷歌的 Dreamer 系列(号称机器人研究领域的世界模型,用观测→潜变量的表征模型 + 潜动力学模型,在 latent space 中“滚动未来”,做想象式规划与策略更新,再与真实环境数据闭环)。
以及,当下主流的图像与视频生成模型,同样在 latent space 中完成采样与演化(扩散模型部分将进一步讨论)。
那么,当你再次听到 AI 界谈论世界模型时,是否能知道他们究竟在谈论些什么?读者若感兴趣,可自行探索。
写在最后#
对于人工智能而言,所谓“表示”,就是模型在计算中形成的中间结构——模型将原始数据转化为内部可被运算与推理的结构化表达。
一个紧凑的向量、一组张量高效的激活模式,正是模型对外部信息的编码方式。
至此,读者或可体会到,理解人工智能需要具备“计算思维”:从人类大脑的 neural coding 到机器的 representation learning,科学家对智能的探索始终在两种体系间互为镜像。
以何种形式表示数据与信息,决定了机器能在多大程度上“计算”这个世界。
本章旨在为读者建立人工智能的基本原理框架,尚未涉及 GeoAI 的具体内容——关于“空间”的表征,将在后续章节展开。
此处引用《The Hippocampus as a Cognitive Map》中的一段话,作为引向空间表征学习的铺垫:
SPACE plays a role in all our behaviour. We live in it, move through it, explore it, defend it. We find it easy enough to point to bits of it: the room, the mantle of the heavens, the gap between two fingers, the place left behind when the piano finally gets moved. — O’Keefe & Nadel, *The Hippocampus as a Cognitive Map* (1978, p. 5)
作者信息与参考来源#
深圳大学城市空间信息工程系,2022级博士研究生。
研究方向:GeoAI、Geospatial Tokenization、Human Mobility Generation、Geospatial Data Representation Learning。
本章节由黄菲负责编写,含 AI 工具辅助(ChatGPT、Gemini),文中所用插图部分来源于网络。
封面图由即梦 AI 合成,prompt 为:多重曝光,蓝色调,映像,插画,抽象动画,神经元铺满背景,数字在周围流动,若隐若现,机器人背影,近景,从图片左下角到机器人右侧拉出渐变,数字流动,若隐若现,渐变的星空下数字浮动在机器人的身边。
参考来源#
-
本文中,“表征”指信息在系统内部的表达形式;当讨论 AI 的算法机制时,沿用学界常用译法“表示学习”。此处给出 Bengio 等人对于表示学习的定义:representation learning, i.e., learning representations of the data that make it easier to extract useful information when building classifiers or other predictors.(Bengio, Courville & Vincent, 2013, IEEE Transactions on Pattern Analysis and Machine Intelligence) ↩