Wiki Evolution
2 AI发展史简述
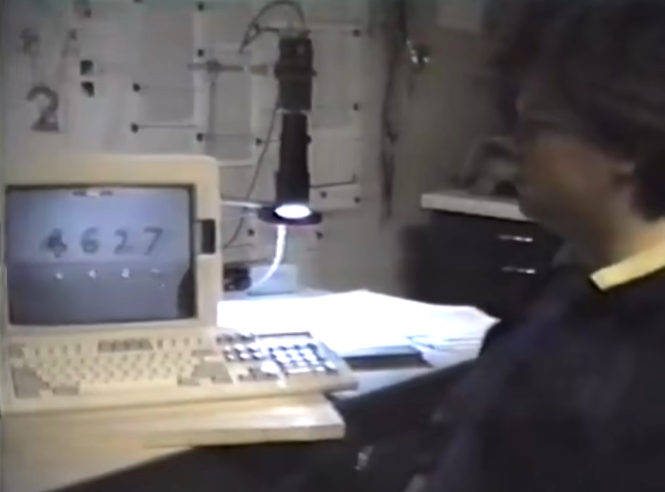
1988年的贝尔实验室里,年轻的杨立昆(Yann LeCun)坐在电脑前兴奋地展示他构建出的第一个卷积神经网络LeNet,它成功识别出了信封上的手写邮政编码,这是卷积神经网络(Convolutional Neural Network, CNN)第一次展现出其强大的应用潜力。尽管后来LeNet并没有被学界采纳,更没有被应用于其他领域,但命运的齿轮在此时已悄然转动......
时间来到2012年,“横空出世”的AlexNet在ImageNet当年的ILSVRC-2012分类任务比赛中将图片识别的错误率刷新到15.3%,比之前最优模型的错误率(26.1%)减少了10.8%,深度学习由此颠覆了传统机器学习方法。事后的访谈中,李飞飞曾问杨立昆:“杨,这个模型和你在80年代发明的模型(LeNet)有根本上的不同吗?”,杨立昆回答说:“不,它们完全一样,并且它赢得了所有的比赛!”。LeNet在1988年埋下的种子破土而出,沉寂多年的AI领域热度骤起,开启了神经网络的新篇章。
人工智能:一段穿越寒冬的破晓之旅#
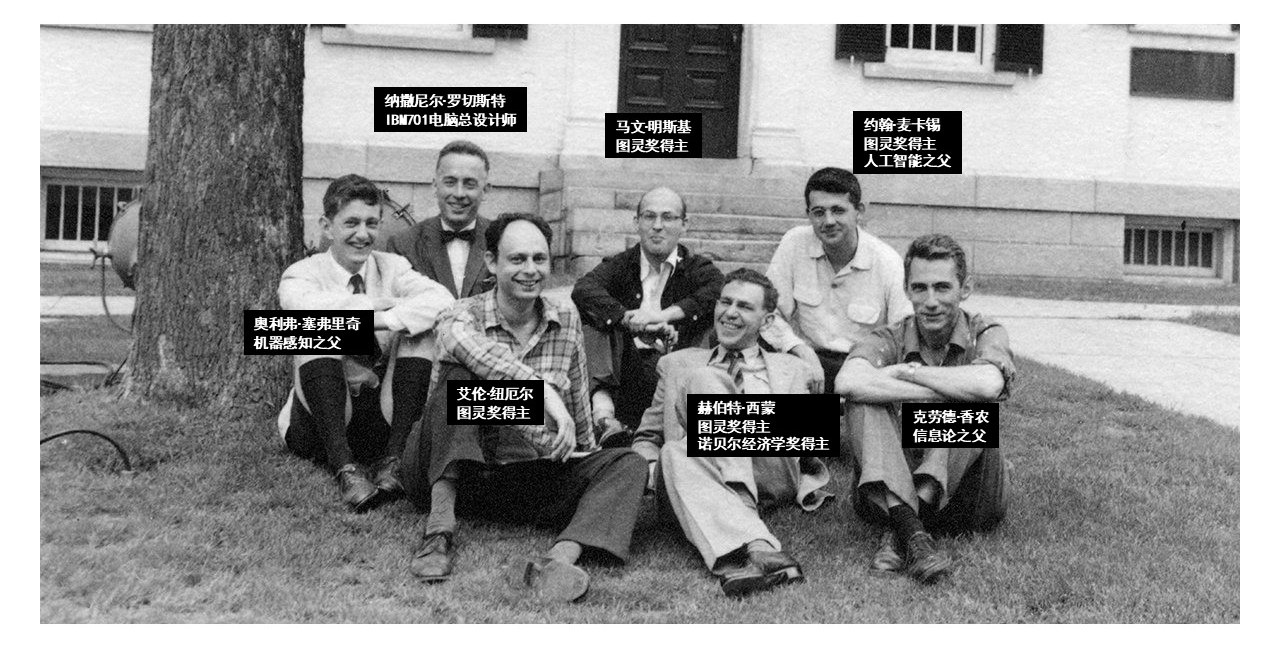
人工智能(artificial intelligence, AI)亦称机器智能,这一概念最早源于英国数学家、逻辑学家阿兰·图灵(Alan Turing)在1936年提出的计算机器理论和“图灵机”模型。在1950年的论文《计算机与智能》中,图灵进一步通过“图灵测试”探讨机器能否表现出人类智能、模仿人类的认知和学习过程,以及用逻辑推理和给定信息来解决问题的可能性。1956年,约翰·麦卡锡(John McCarthy)等人在达特茅斯会议上明确提出“人工智能”这一概念,并着手研究如何通过机器模拟人的智能行为,AI元年就此开启。
纵观AI的发展史,关于什么是“智能”一直是学者们争论的焦点,并由此衍生出两大学派:符号主义学派和联结主义学派,前者认为智能的本质是符号和规则,后者则认为智能的关键是神经元之间的联系强度。这两大学派的碰撞与交锋谱写出了AI近70年发展的沉浮之旅。
符号主义的时代#
符号主义学派在研究人工智能时,重点关注的是让机器通过处理符号(像是文字、图像、声音等经过编码的信息)来实现类似人类的认知功能。这很大程度上受到理性主义哲学的启发,他们认为智能就像在符号的世界中进行运算和推理,例如在经典的三段论中:苏格拉底是人,人都会死,因此苏格拉底也会死。通过一套特定的符号语言,机器总能够从正确的前提下推出正确的结论。想象一下,符号主义学派正在教一个小孩子学习数学,他们教会小孩理解“+”符号代表相加,然后通过组合数字和“+”符号(如3 + 2 = ?)进行计算。在这个过程中,智能不是来自于模仿大人做加法时的智力活动,也不涉及大脑如何处理数学信息,而是通过理解和运用符号规则来表现。
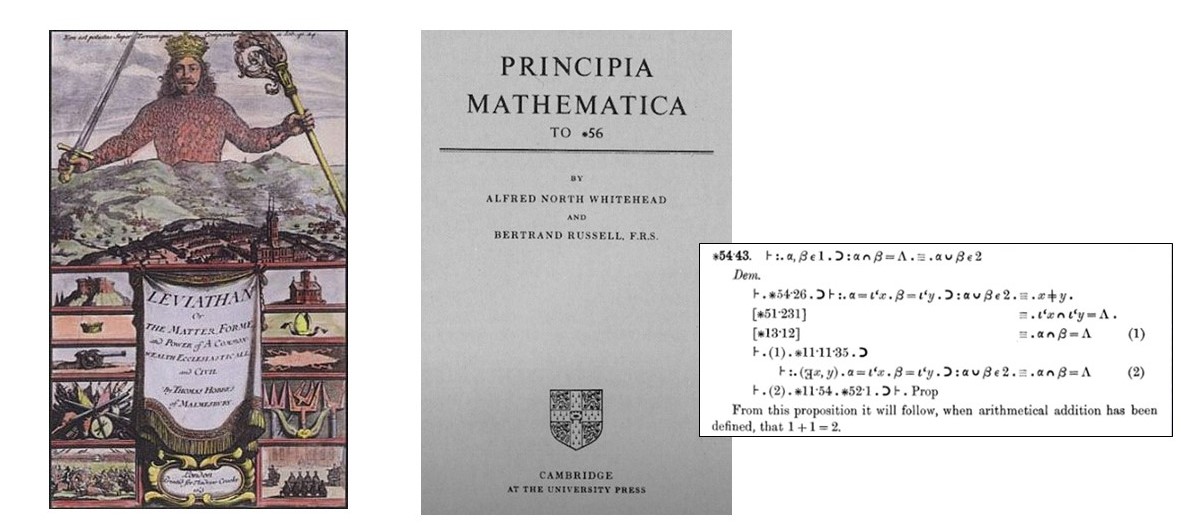
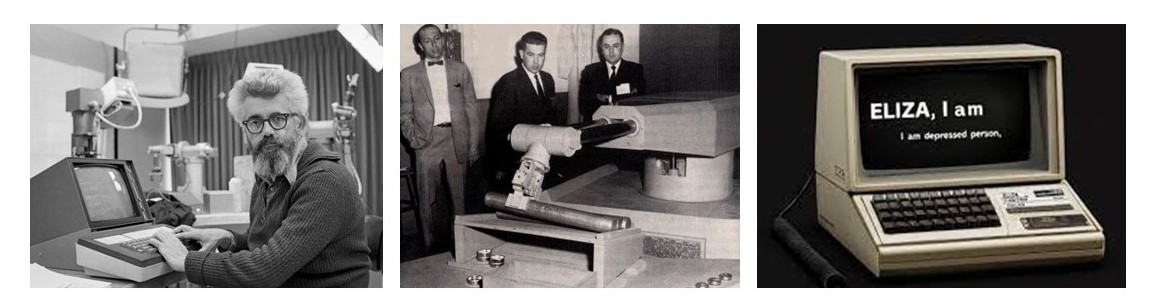
1956年,艾伦·纽厄尔(Allen Newell)和赫伯特·西蒙(Herbert Simon)开发出首个能够证明数学逻辑定理的程序“逻辑理论家”,通过使用一套预定义的规则来演绎推理,成功证明了罗素的《数学原理》第二章中的大量命题,这是符号主义学派初步在理论与实践上的重要成就。紧接着,1958年,约翰·麦卡锡发明Lisp汇编语言,并由此提出世界上第一个完整的AI系统–能像人类一样学习的假想程式,为AI研究者提供了一个统一的编程环境。自此,符号主义下的人工智能开始一路高歌猛进。这一时期诞生了工业机器人Unimate、“心理咨询师”Eliza(文本版的Siri)、以及能在虚拟计算机环境下执行简单指令的SHRDLU等里程碑式应用。这一时期的语言文本程式化的技术已十分成熟,通过程式化大量的专业知识和推理规则衍生出了一系列专家系统,如针对细菌感染的医疗诊断系统“MYCIN”,其知识库中包含了大量从医学专家访谈中记录的诊断规则。
两次寒冬#

设想一下,你要在符号理论下开发一个医疗诊断的专家系统,那就需要手动编写上千条复杂的病理和诊断规则。然而医学知识在不断扩展和更新,但这些系统无法直接从经验中学习,就像一个死记硬背的学生,因此研究者必须不断地扩充和修正规则库,显然这项工作会变得越来越复杂。由于计算机硬件资源有限,符号系统在面对复杂疾病时,其诊断准确率和效率无法满足实际需求–当时公众期待AI能媲美甚至超越人类医生的即时准确诊断。此时人们意识到,AI似乎并没有给社会带来实际的生产价值。1970年,美国国防部开始削减对人工智能领域基础研究的预算。三年后,詹姆斯·莱特希尔(James Lighthill)在《人工智能普查报告》中披露当前许多AI项目的进展并不符合预期,前期的投资并没有带来相应的回报,英国政府开始拒绝继续往AI这个无底洞砸钱。资金链的断裂让AI的发展陷入停滞状态,第一次寒冬正式降临。
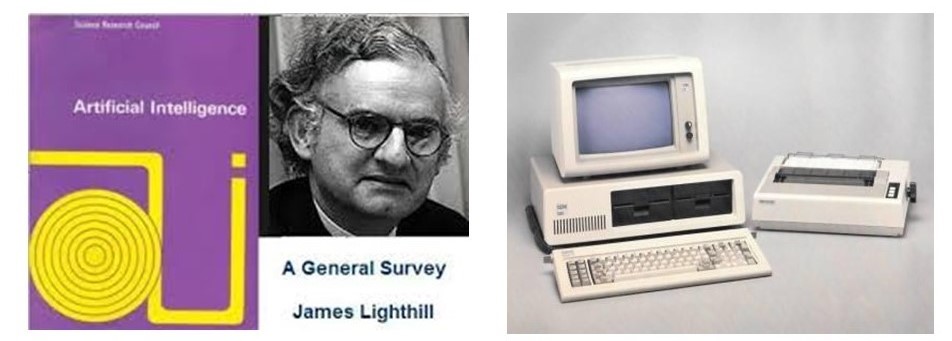
到了80年代,人工智能的车轮再次转动。日本于1981年发起声势浩大的第五代计算机项目,力图打造具有高度智能的计算机系统,此举在全球范围内掀起了新一轮的人工智能热潮。随着微处理器的出现和普及,此时的计算和数据处理速度相较于70年代有了大幅提升,这使得部分专家系统实现了商业应用,并带来显著经济效益。比如,福特汽车公司开发了用于汽车制造诊断的R1专家系统,帮助减少生产线上的停机时间。然而,专家系统严重依赖于人类专家手动编码知识规则的这一技术局限性仍未被解决。这使其难以处理模糊信息、不确定性及复杂环境变化,实际应用效果远未达到公众和投资方的高期待。1987年的经济危机使得投资者对高风险的人工智能技术信心严重受挫,众多计算机企业相继破产。以符号主义为指导思想的人工智能行业无奈地滑入了第二次寒冬。
联结主义的历练之路#
想象你有一堆彩色积木,每个积木可以接收和传递信息。它们一层层堆叠起来,最下面的积木接受原始信息(比如图片),然后每层积木按照一定的规则处理信息,并传给上一层。这个“积木团队”有个特别的能力——学习,就像我们做题、改正错误后能记住正确答案一样,它们也能通过不断尝试和调整,学会识别图像、理解语言等复杂任务。这就是联结主义的基本思想,在某种程度上可认为是经验主义哲学在AI领域的体现(即,知识源于经验)。读到这里你可能已经意识到,直到AI进入第二次寒冬,两大派系的斗争中,似乎一直是符号主义学派占上风。这一期间里,联结主义学派经历了什么?它又是如何逆风翻盘,为AI带来新的曙光?
更深的网络#
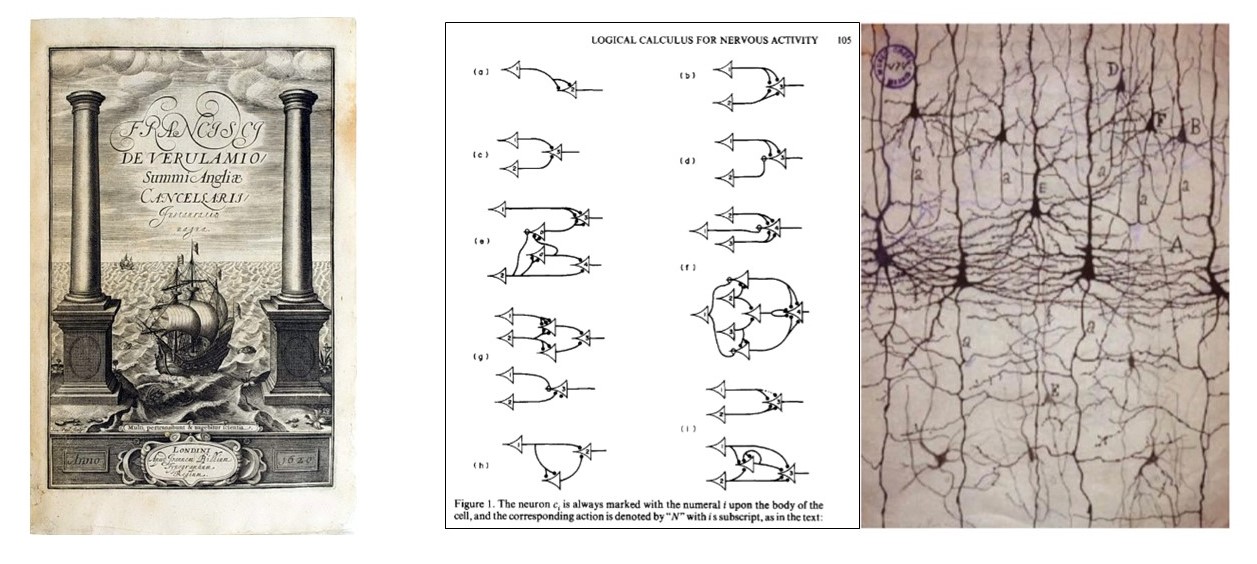
1943年,美国数学家沃伦·麦卡洛克(Warren McCulloch)和逻辑学家沃尔特·皮茨(Walter Pitts)在《神经活动中内在思想的逻辑演算》提出了第一个具有生物灵感的人工神经元模型(以他们二人姓氏缩写命名,被称为M-P模型),标志着联结主义学派的诞生。到了1958年,弗兰克·罗森布拉特(Frank Rosenblatt)设计了感知器(Perceptron),这是首个被实际设计出来的单层神经网络(相当于只有一层积木)。尽管初期感知器在解决线性可分问题时表现出色,但在处理非线性问题时遇到了局限性。要知道,神经网络的能力十分依赖于网络的深度,其中涉及到大量神经元之间的权重调整和学习过程,但受限于当时的计算机性能,训练大型神经网络非常困难。同时,有效训练神经网络需要大量的标注数据,而在那个时代,数据采集和存储成本十分高昂,导致神经网络在处理很多现实任务时的表现不如人意。1974年,保罗·沃博斯(Paul Werbos)在其博士论文中首次提出了反向传播算法(Backpropagation,BP),这是一种用于训练多层(大规模)神经网络的关键技术,但在当时并没有引起重视–毕竟当时AI领域正经历第一次寒冬期;此外,相比于强调逻辑和规则明确性的符号主义,神经网络就像一个“黑盒子”,不透明的学习机制和难以解释的结果,使其难以被主流科学界接受。
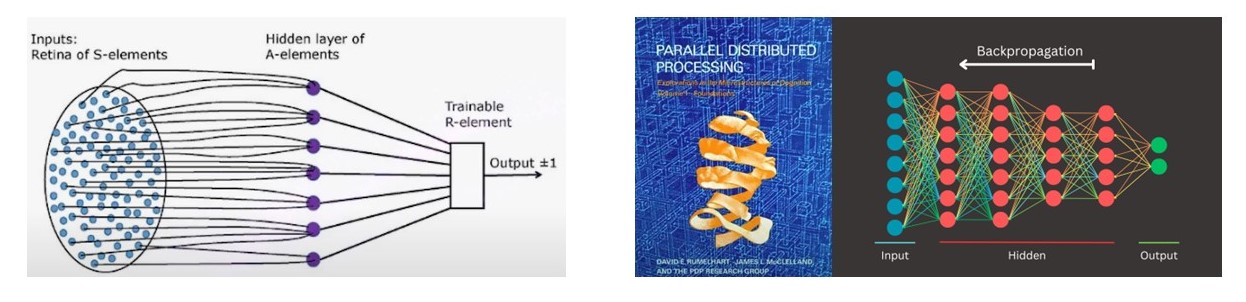
第一个转折点出现1986年,深度学习“三巨头”(辛顿 Hinton、本吉奥 Bengio、杨立昆 Yann LeCun)之一的辛顿在《Parallel Distributed Processing》发表的关于BP算法的论文在业界引发了爆炸式反响,人们开始利用神经网络进行特征提取和模式匹配,以及解决图像处理和计算机视觉中的问题。不幸的是,先前狂热鼓吹的AI泡沫已经破裂,此时政府和企业家们对于投资AI产业是十分谨慎的。文章开头提到的LeNet,在经过7年的迭代后,LeNet5于1995年成为了第一个商用的卷积神经网络,成功读取了美国发行的所有支票的10%-20%,这是神经网络在当时最引人注目的成就之一。但LeNet5却并没有赢得资本的青睐–当时的人们更喜欢机器学习这类基于确定数学定理来运行的方法,例如SVM和Boosting。而一项复杂且难以解释的技术往往意味着高风险,非主流的神经网络技术自然会让资本望而却步。
破除偏见,联结主义的胜利#
迈入21世纪初,神经网络的处境已十分艰难,尽管神经网络在实践中效果很好,但多数研究者们认为神经网络的研究就是一场笑话,因为当时没人能解释它为什么能完美地完成工作。无奈的杨立昆等人只好给神经网络披上马甲–深度学习,以一种“新”姿态出现在大众视野。深度学习如今可谓是炙手可热,但就算是今天,深度学习的“黑盒”仍未被打开,又是什么让当时“顽固”学者们放下了对深度学习的偏见呢?或许,在绝对的任务精度提升面前,“黑盒”的运行机制暂时显得无伤大雅。
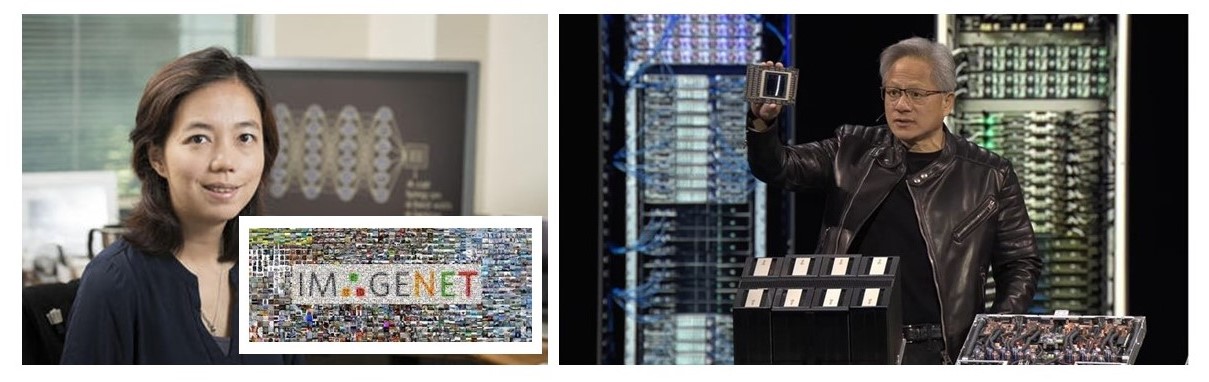
帮助深度学习翱翔在天空的两只翅膀,一个是数据,一个是算力。GPU的突破使得计算机的计算能力成倍增长,杨立昆等人在2006年成功将GPU用于神经网络的计算加速。GPU对于深度学习来说这就像一个马力强大的发动机,你甚至能听到它蓄势待发的轰鸣声。如果说数据是新时代的石油,那么在2009年李飞飞发布ImageNet之前,它还只是恐龙的骨头。李飞飞坚信“数据将重新定义我们对模型的看法”,事实证明数据的确是宝贵的燃料,它能让算法看到更真实和复杂的世界,也就是今天大家所说的“泛化性”。当GPU碰上大数据,神经网络的研究者们意识到,这就是最好的机会。正如文章的开头,2012年是决定性的一年,辛顿团队的AlexNet在ILSVRC-2012的比赛上大获全胜。
技术的进步无法一蹴而就,它是反复实验、失败、渐进累积与探索的结果,神经网络和它坚定的研究者们为此走了很长的路。基础理论和技术的锤炼与优化造就了更加完善的深度学习方法,与更大的数据集和更强的算力相结合,共同促进了人工智能研究的新一轮飞跃。
历史的车轮不曾停止#
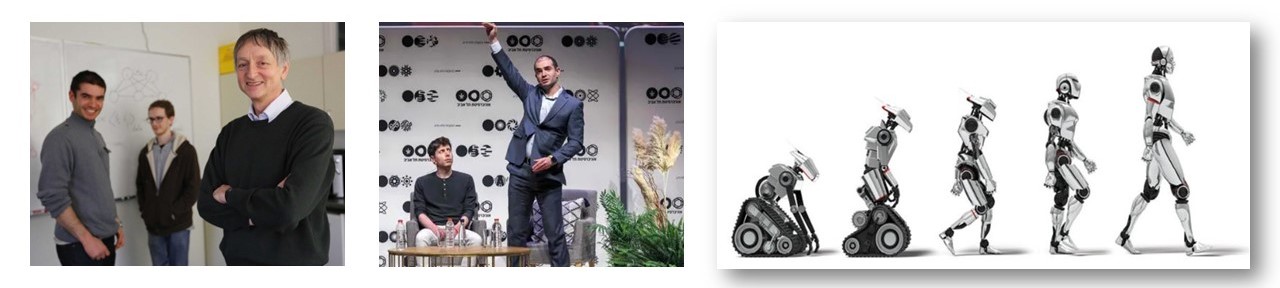
在人类对机器智能的不懈追求中,联结主义与符号主义之争实则映射了科学哲学层面对复杂系统模拟的不同理念碰撞与融合。两种学派在人工智能历史长河中的交织前行,并非简单胜负较量。联结主义依靠数据驱动学习,但网络的设计与特征建模方式也离不开先验知识的指导;符号主义虽然重视逻辑推理,但也会利用机器学习算法从数据中学习和优化知识。从LeNet到AlexNet再到如今ChatGPT-5的迭代跃迁,见证了科技进步如何借助时代赋予的红利(大规模的数据集、强大的算力、更具前瞻性的眼光)突破原有边界,将本质上相同的神经网络构架不断优化升级并注入创新元素,转化为了推动时代变革的强大引擎。
每一次人工智能的重大突破,都伴随着对未来认知边界和智能本质的深刻反思。人们对于技术的认知具有无法摆脱的时代局限性,正如李飞飞所说:“我们如何被记住,取决于我们现在正在做什么”。或许,在技术精进的今天,我们应该更谨慎思考未来人机关系的新格局。热潮之下隐藏的是一个更加开放的问题:在现有技术和理论体系中,人工智能是将触及并超越人类心智深层结构,还是将在新的挑战面前迫使我们重新审视和定义“智能”本身?
联结主义的主要技术#
本节结尾对联结主义中经典的技术手段进行简单介绍,有益于读者阅读本书的后续章节。
1. 感知器(Perceptron)与多层神经网络(深度学习网络)#
感知器是模拟人脑神经元的最基础模型。它接收很多信息(像小朋友从不同角度看到的不同颜色积木),每个信息都有大小(即积木的颜色深浅),然后加起来(把所有积木放一起看整体颜色)。如果加起来的结果达到了某个特定值(比如全部积木颜色深代表的是红色),感知机就会做出决定(“我看到了红色”)。通过不断调整每个积木的重要性(也就是权重),感知机可以学习区分不同的输入。就像搭积木一样,多感知机堆叠在一起,每层感知机都会把处理后的结果传给下一层,这样就可以解决更复杂的任务,比如分辨不同的动物图片。每一层感知机都在学习识别特定的特征(比如眼睛、耳朵等),最终组合成对整个图片的理解。
2. 反向传播算法#
反向传播就像是教一个复杂的积木机器人怎么完成特定的任务。比如我们让它用积木拼出一个图案,如果它没拼对,我们就得告诉它哪里错了,但是因为积木太多太复杂,直接指出具体哪块积木移动多少不容易,这时反向传播会从最后拼出的结果开始检查,然后一步一步地回溯到每一块积木,看看哪块积木怎样微调能帮助结果更接近正确答案。这样,每次尝试后,机器人都会按照这个反馈调整积木的位置,经过反复训练和纠正,最终学会准确无误地拼出各种图案。在深度学习中,反向传播就是帮助神经网络逐步改进、找到最优参数设置的关键过程,使得网络能够更好地完成任务。
3. 处理序列数据和图像数据的两大法宝:RNN 与 CNN#
循环神经网络(Recurrent Neural Network,RNN)
RNN是一个会记住故事的讲故事机器人。它每次听到一个词就会记下来,并用上一次的记忆去猜下一个词。这种能处理按时间顺序出现信息的“记忆”机器就是循环神经网络。它在处理句子或声音时,就像我们读故事一样,根据前面的内容预测后面的部分。不过,这个讲故事的机器人有时会忘记很久以前的重要细节。
卷积神经网络(Convolutional Neural Network,CNN)
CNN是一个智能拼图专家,它通过一个滑动的窗口,扫描图片并从中提取出各种小图案,如边缘、纹理等局部特征。并通过堆叠卷积层进行更高级别的抽象,比如通过拼图中的眼睛和鼻子,就能判断这是一只小狗或小兔子。不同于RNN中每个时刻的输出取决于当前和过去的信息,图像像素之间的空间关系是固定的,并不按先后顺序排列。CNN通过邻域的卷积操作和池化操作可以高效地捕捉到图像的空间结构和局部不变性,从而更适合于图像处理任务。
4. 扇动翅膀的蝴蝶:Transformer — Attention Is All You Need#
Transformer作为ChatGPT的核心算法给AI行业带来了一场技术风暴,它彻底改变了处理序列数据尤其是自然语言的方法。当你让RNN和Transformer同时阅读一本很厚的书籍,RNN会像蜗牛慢慢爬,一个字一个字地读,虽然他会努力记住前面读过的内容,但有时候还是会忘记很久以前读过的关键词。而Transformer拥有神奇的透视眼(“自注意力”机制),一眼就能看见整个故事内容,能同时理解好多词和句子的意思,并找出它们之间的联系,而且不受故事长短的限制。
就像造一座高大的积木城堡,原来我们需要一个一个慢慢搭,但有了Transformer,我们就可以同时放好多积木块,很快就把城堡搭得又高又稳。Transformer利用自己的“并行计算”本领,能够让计算机一次性处理很多信息,而不是排队等候。这样,科学家们就能搭建起拥有几十亿块积木(也就是参数)的巨大模型,这些模型变得更强大、更能干,就像真正的变形金刚,可以应对各种各样的语言挑战。
5. 强化学习#
深度学习是在大量有标记数据的基础上学习如何正确地识别或预测事物;强化学习在训练时,你无需给出预期答案,而是告诉它产生的结果是否正确。就像玩游戏的小朋友,每走一步都会得到游戏的反馈(得分或者惩罚)。小朋友通过不断试错,学习到哪些行动会导致好的结果,从而获得更高的分数。在强化学习中,RNN和CNN通常被用来处理智能体接收到的不同形式的状态信息,然后将这些处理后的信息传递给策略网络或价值网络,以便进行动作选择和学习过程。例如AlphaGo中就使用了CNN来评估当前局面对最终胜负的影响程度,即给定一个棋盘布局预测黑白双方赢棋的概率。
作者信息与参考来源#
深圳大学城市空间信息工程系,2022级博士研究生。
研究方向:GeoAI、Geospatial Tokenization、Human Mobility Generation、Geospatial Data Representation Learning。
本章节由黄菲负责编写,含AI工具辅助(ChatGPT-4、通义千问、即梦AI等),文中所用插图来源于网络。
封面图由即梦AI合成,prompt为:寒冬黎明场景,高大的机器人携手人类行走于冰封河面,两人背影面向远方金色晨光,雪地足迹延伸至雾中雪山,细腻霜花细节,抽象电影构图,质感,毛边玻璃效果。
参考来源#
- https://www.storm.mg/article/1375326
- https://www.jiqizhixin.com/articles/2018-12-11-20
- https://m.thepaper.cn/baijiahao_19930583
- https://www.aminer.cn/ai-history
- https://zhuanlan.zhihu.com/p/28142670
- 杨立昆. 2021. 科学之路. 北京:中信出版集团
- https://www.youtube.com/watch?v=97qFVWjtbxE