1. 先看整体表现:读 GeoJSON 很强,看图也有进步#
测试集覆盖 28 类空间关系。题目既包括“地物 1 是否位于地物 2 东侧”“两栋建筑是否重叠”这样的空间关系判断,也包括“把对象移动到指定方向,并保持一定距离”这样的编辑任务。
按照输入形式和任务类型,我们分为四组:读坐标答题、读坐标编辑、看图答题和看图编辑,每组 140 道,共记录 GPT-6 Astra 的 560 次结果。
问答题按答案是否正确计分;编辑题则执行模型给出的修改,再检查新的几何位置是否真正满足题目中的空间约束。
| 测试内容 | GPT-6 Astra | GPT-5.6 Sol | Kimi K3 |
|---|---|---|---|
| 读坐标回答问题 | 95.7% | 75.7% | 85.0% |
| 读坐标修改对象 | 87.1% | 62.9% | 62.9% |
| 看地图回答问题 | 65.0% | 55.7% | 49.4%* |
| 看地图修改对象 | 48.6% | 26.4% | 33.3%* |
注:准确率差距以百分点表示。Astra、Sol 各项及 Kimi K3 的坐标任务均为 140 题。* Kimi 图像测试尚未全部完成,问答、编辑分别统计样本中的 85 题、60 题有效结果。
四组任务呈现出较为一致的结果。
坐标问答中,GPT-6 Astra 的准确率为 95.7%,GPT-5.6 Sol 为 75.7%,相差 20.0 个百分点;地图图像问答分别为 65.0% 和 55.7%,差距缩小至 9.3 个百分点。
编辑任务中的差异更为明显:坐标编辑准确率由 62.9% 提升至 87.1%,增加 24.3 个百分点;地图图像编辑则由 26.4% 提升至 48.6%,增加 22.1 个百分点。
加入 Kimi K3 后,三款模型的差别更直观了。坐标问答中,Kimi K3 的准确率为 85.0%,高于 Sol 的 75.7%,低于 Astra 的 95.7%;坐标编辑中,Kimi K3 与 Sol 同为 62.9%,Astra 为 87.1%。
在已完成的共同图像样本中,Astra、Sol、Kimi K3 的问答准确率依次为 65.9%、52.9%、49.4%;编辑准确率则为 36.7%、26.7%、33.3%,Kimi K3 在这一项更接近 Astra。
从 GPT-6 Astra 自身的结果看,输入形式带来的差异同样明显。GeoJSON 坐标问答和坐标编辑分别达到 95.7% 和 87.1%,而地图图像问答和编辑只有 65.0% 和 48.6%。
这说明在当前测试中,模型处理结构化几何信息的能力已经较强,而视觉形式的空间理解和精确操作仍然更具挑战。
2. 三道看图题,看看模型的具体答案#
下面三道题,Astra、Sol 和 Kimi K3 都给出了有效回答;每道题使用同一张地图和同一个问题。
先看两种容易混淆的关系:两个区域是只重叠了一部分,还是完全占据同一个位置?
第一题:重叠了一片,还是只碰到边?#
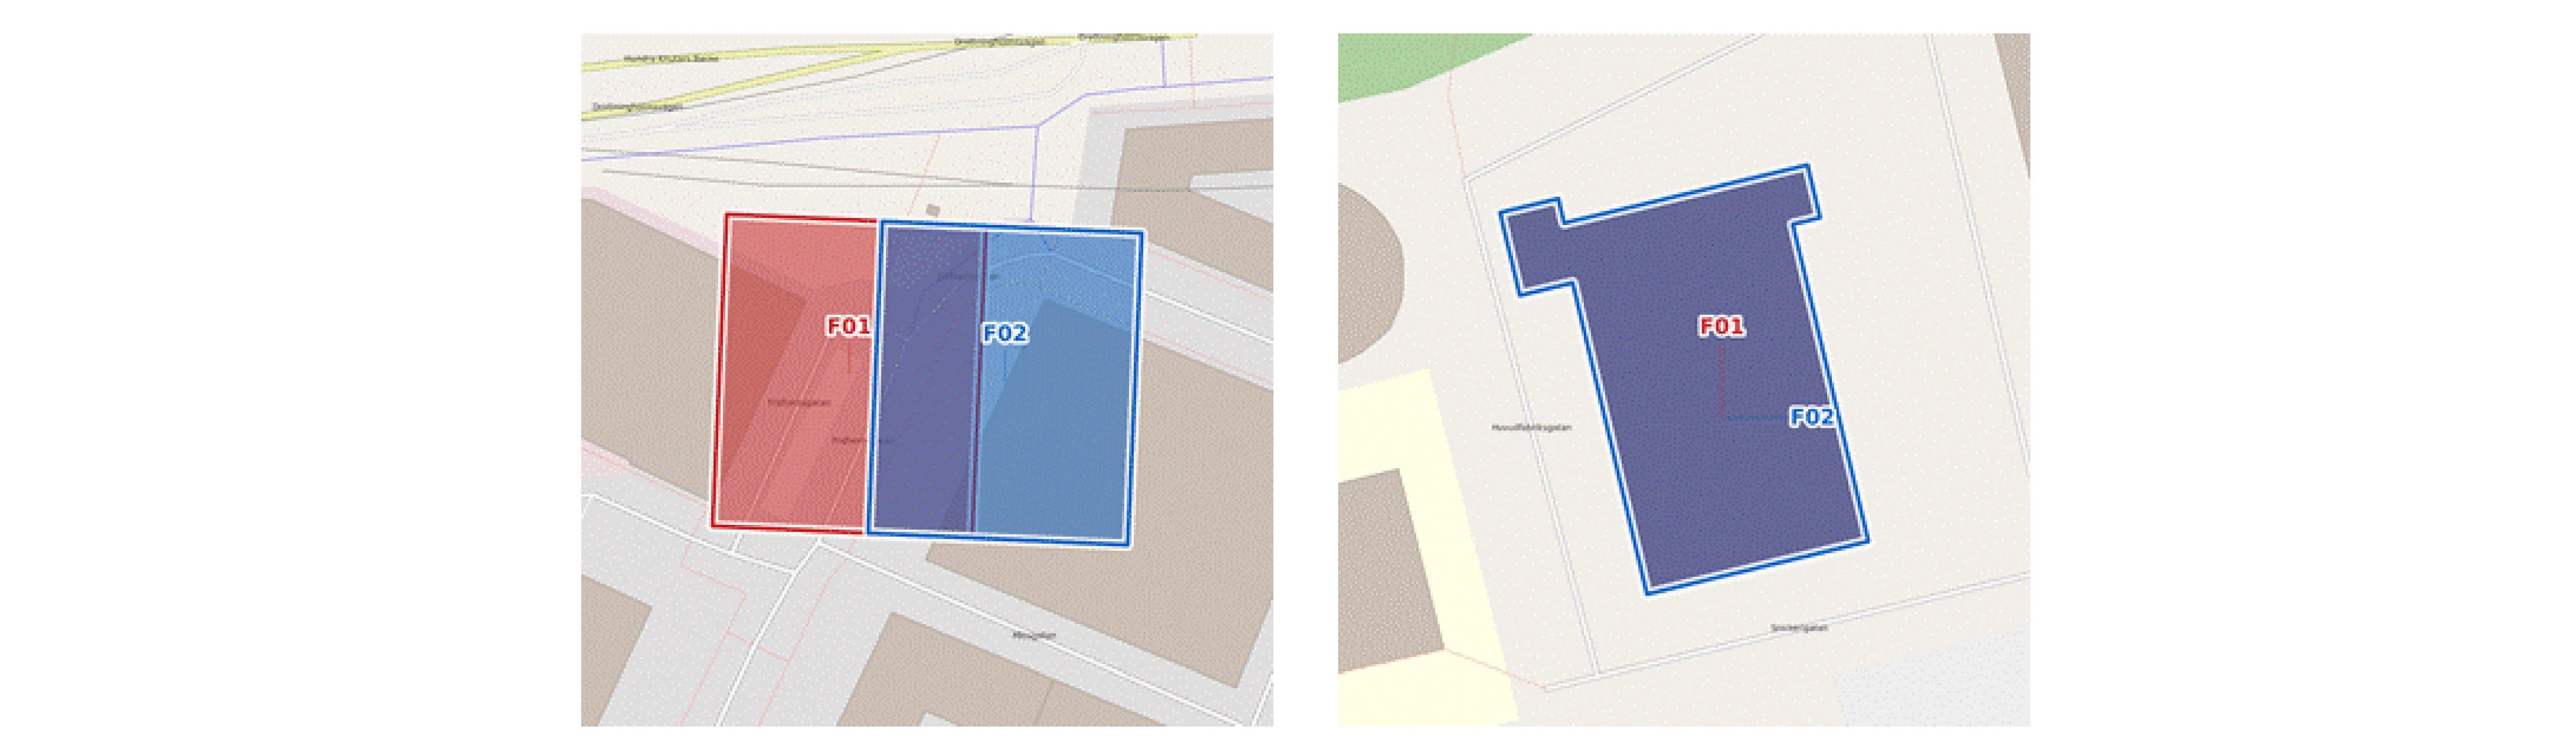
图 1 左侧的红蓝区域中间有一片共同覆盖的面积,标准答案是“部分重叠(overlaps)”。
Astra 和 Sol 都回答“部分重叠”,判定正确;Kimi K3 回答“边界接触(touches)”,未答对。
两者的区别很直观:重叠有共同的内部面积,仅接触则只是边界碰到一起。
第二题:完全重合,却得出三种答案#
图 1 右侧的两个多边形占据同一片空间,标准答案是“完全重合(equals)”。
Astra 答“完全重合”,Sol 答“包含(contains)”,Kimi K3 答“不相交(disjoint)”,只有 Astra 答对。
由于后绘制的颜色会遮住前一个,读图时还要留意指向同一位置的两个标签。
第三题:把视野拉回整座城市#
题目只允许从东、南、西、北四个方向中选择,判断蓝色点 F02 相对红色点 F01 的方向。
两点并不在同一条水平线上,关键是按题目的四方向划分规则,确定它更接近哪个方向。
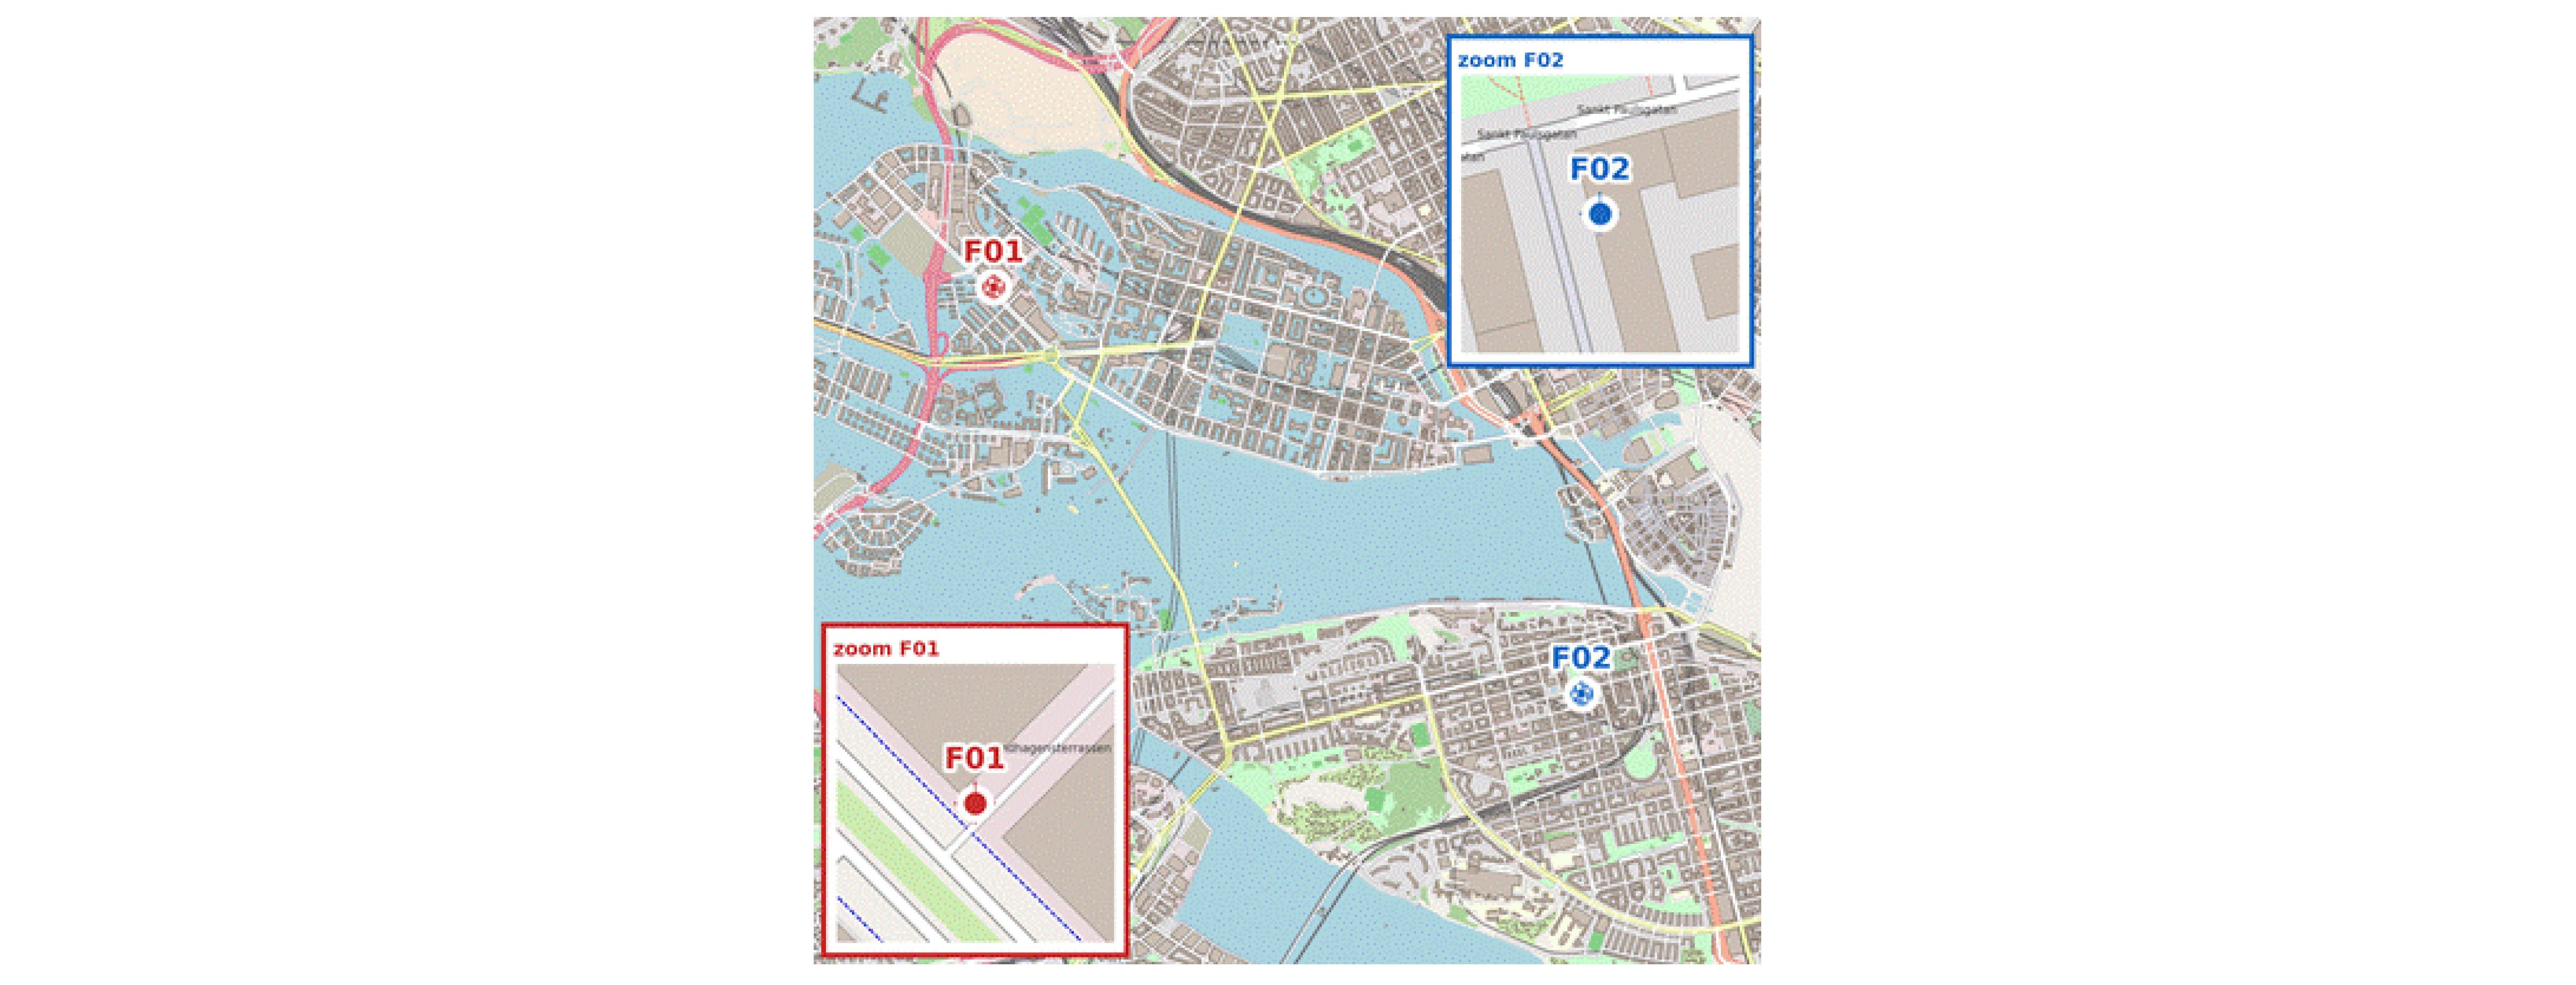
标准答案是“东方(E)”。Astra 和 Kimi K3 都回答“东方”,Sol 回答“南方(S)”。这道题中,Kimi K3 与 Astra 一样答对了。
把三道题放在一起,更容易看清当前测试中的差异:Astra 三题均答对,Sol 和 Kimi 各答对一题,而它们答对的是不同题目。
3. 从“判断关系”到“修改空间”:编辑任务难在哪里?#
问答和编辑任务都涉及空间关系,但二者要求并不相同。
问答只需判断当前关系是否成立;编辑则要进一步改变对象的位置或形状,并让修改后的结果满足一个或多个约束。
也就是说,模型不仅要答对,还要生成可以被实际执行和验证的几何结果。
前面的三道问答题展示了模型能否判断关系,下面再看三款模型如何实际修改对象。
这里选取“部分重叠”和“向东移动”两类编辑题,与前面的问答属于同类空间关系,但使用的是各自的编辑场景。三款模型在每道编辑题中接收相同要求,结果按保存的几何输出和本次评测记录比较。
编辑案例一:把两个区域移到部分重叠#
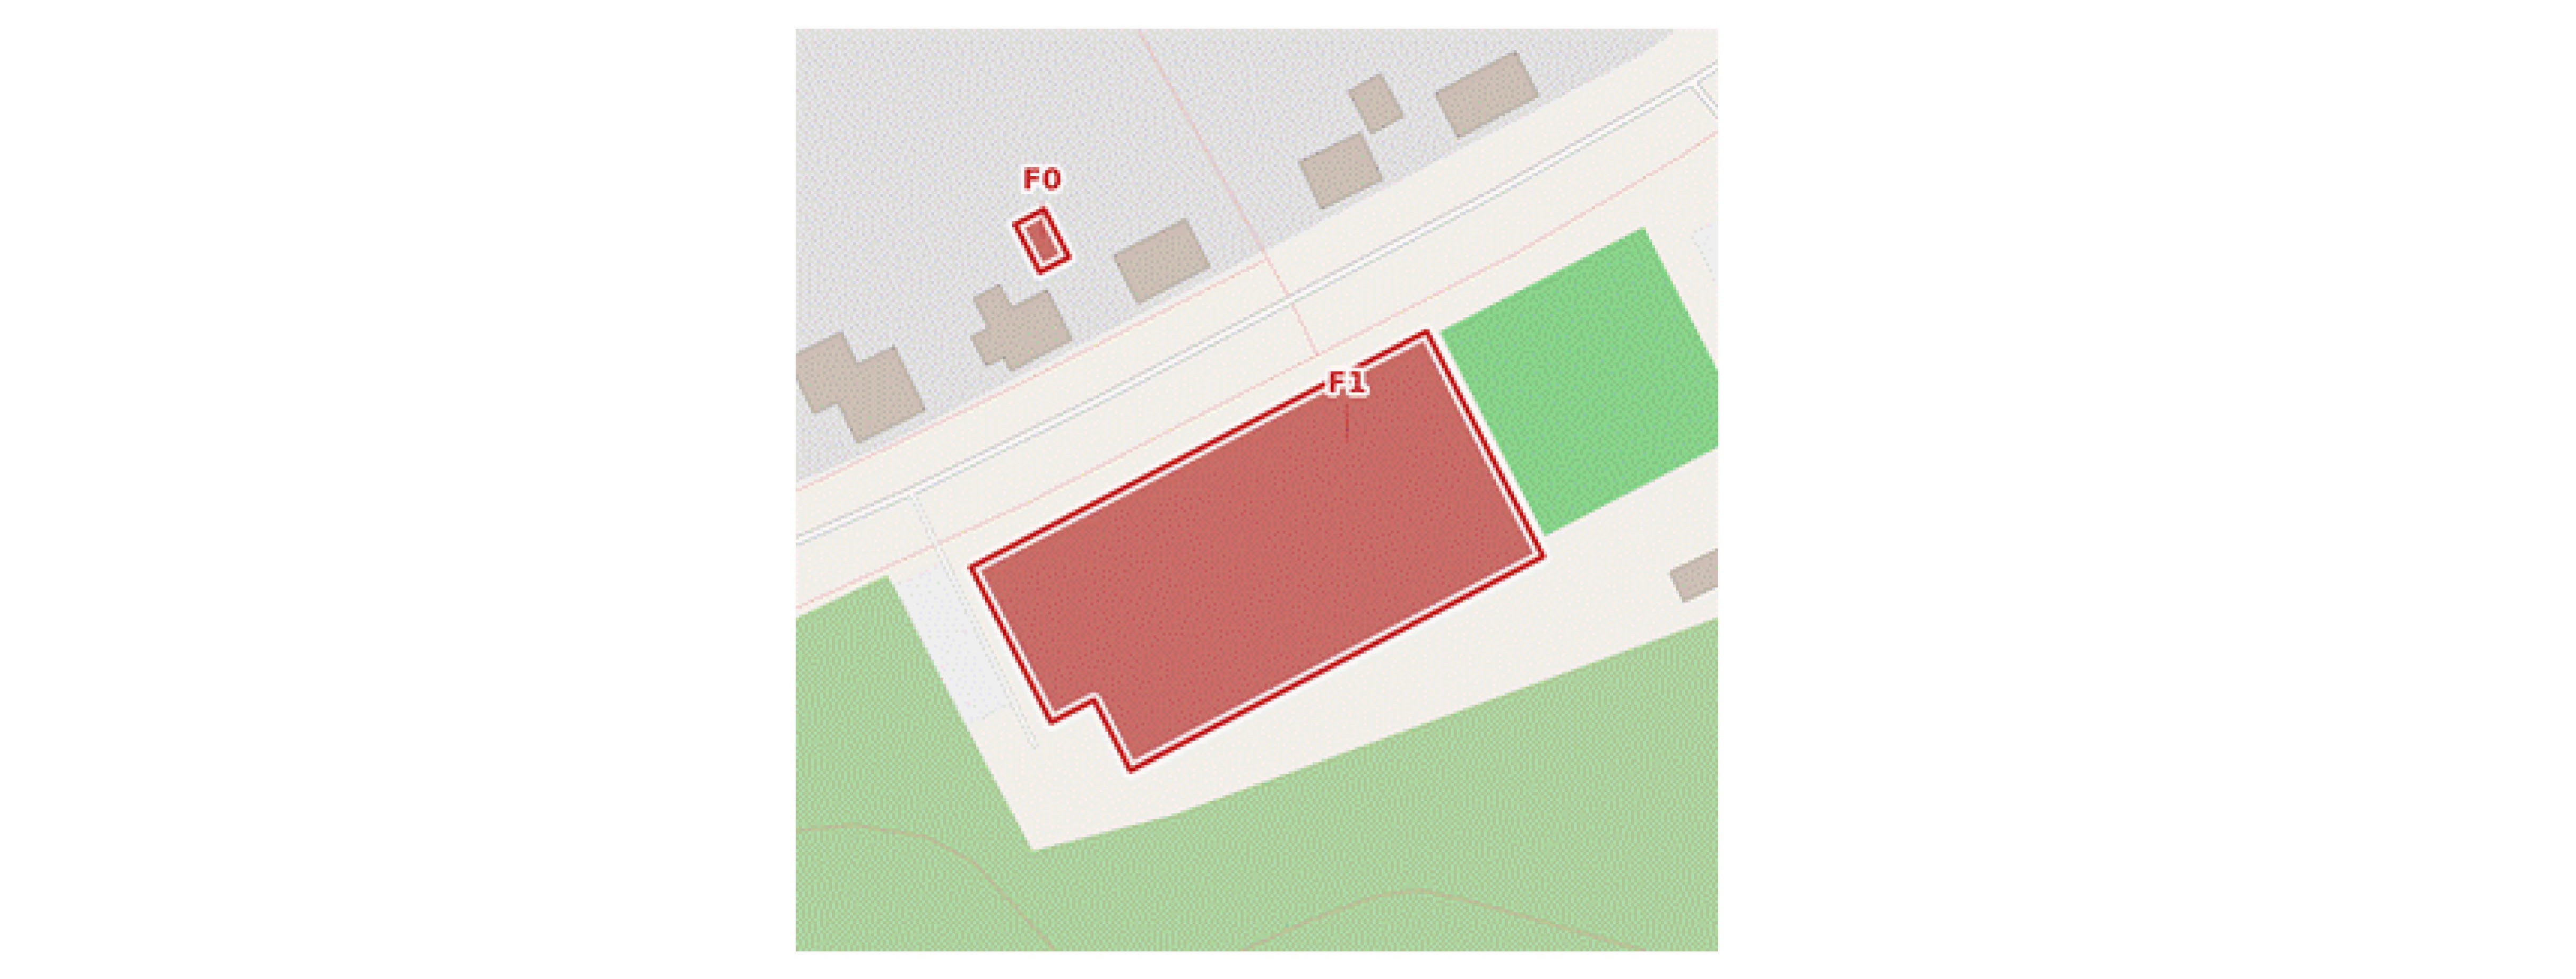
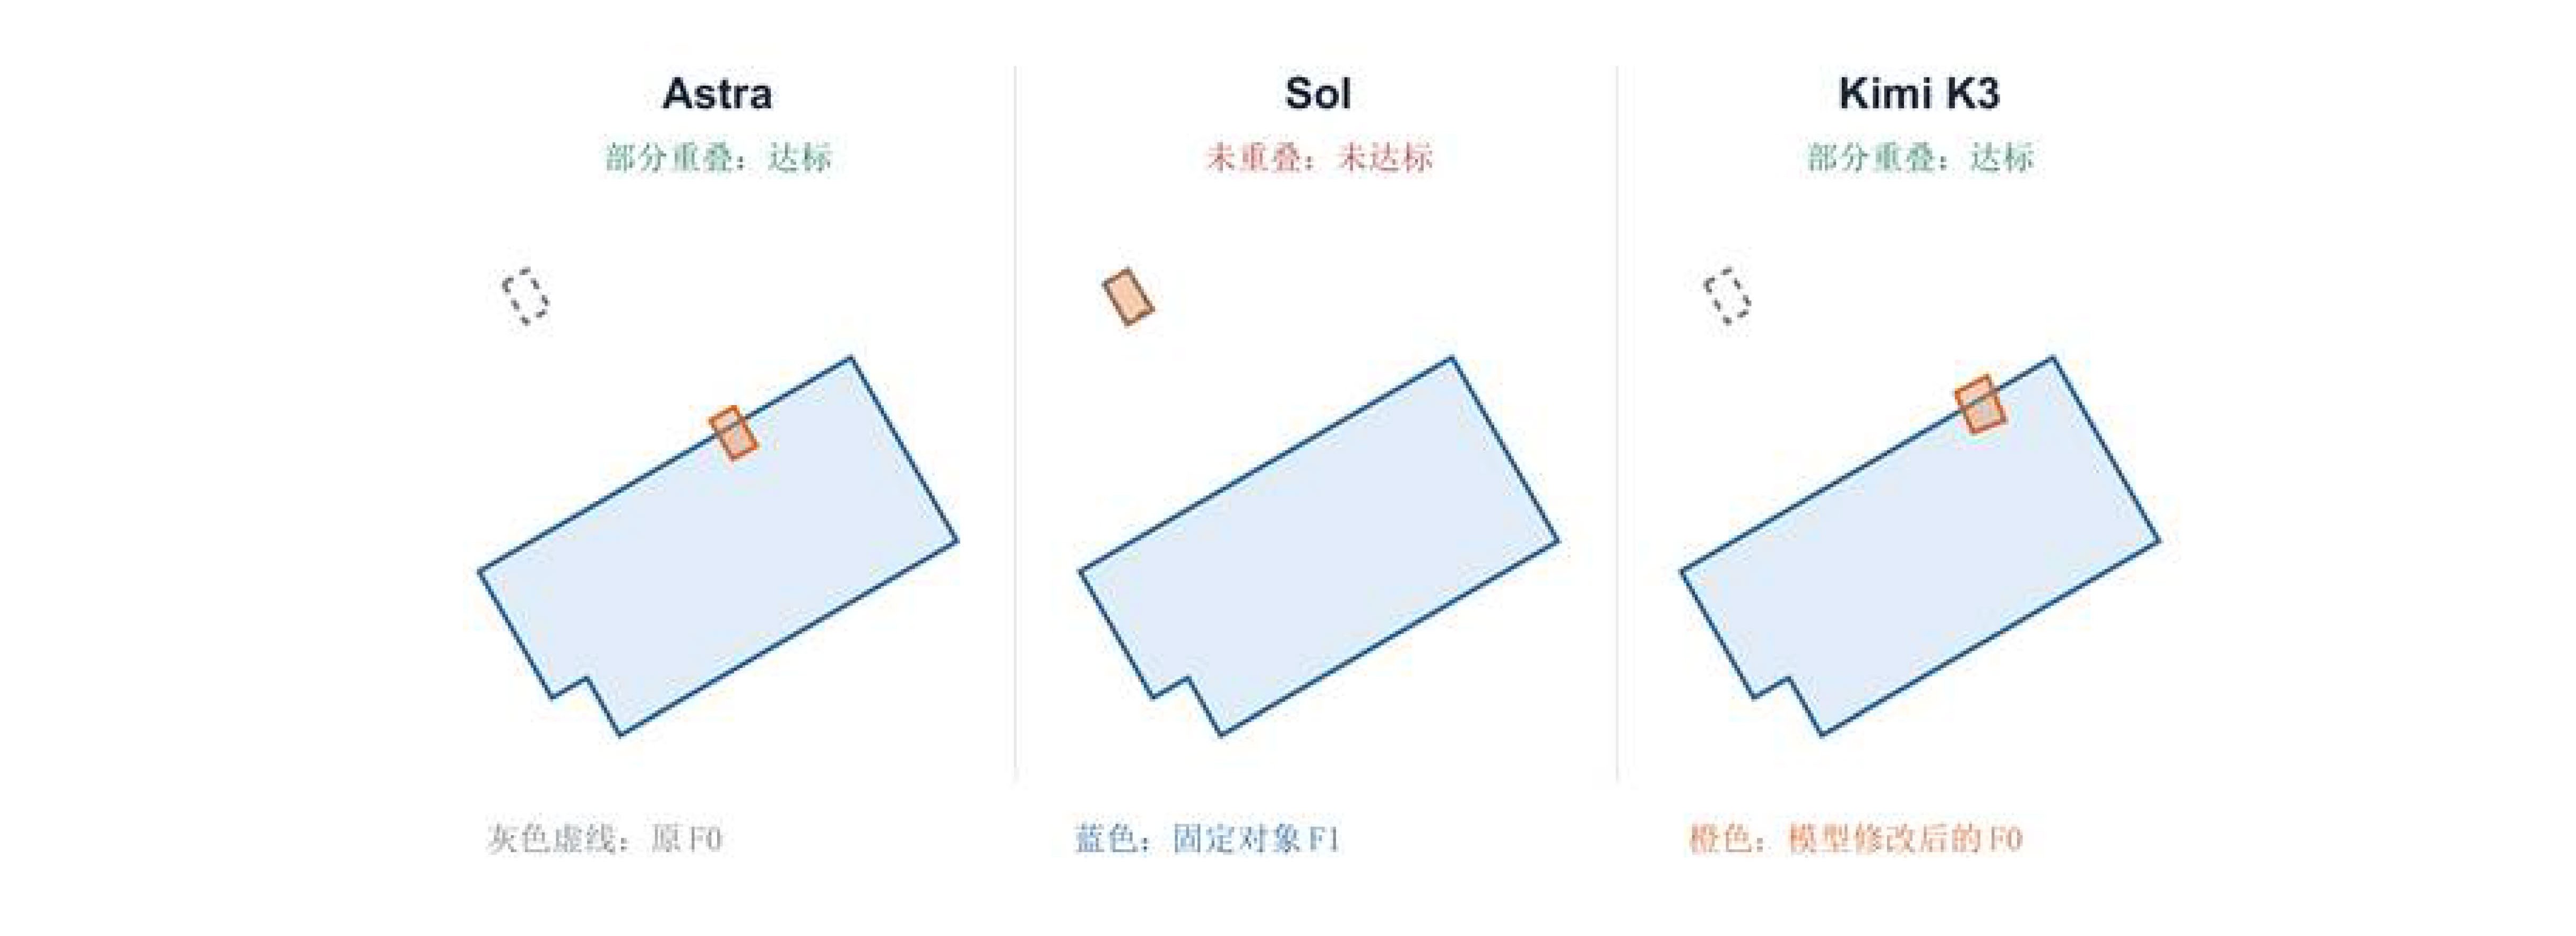
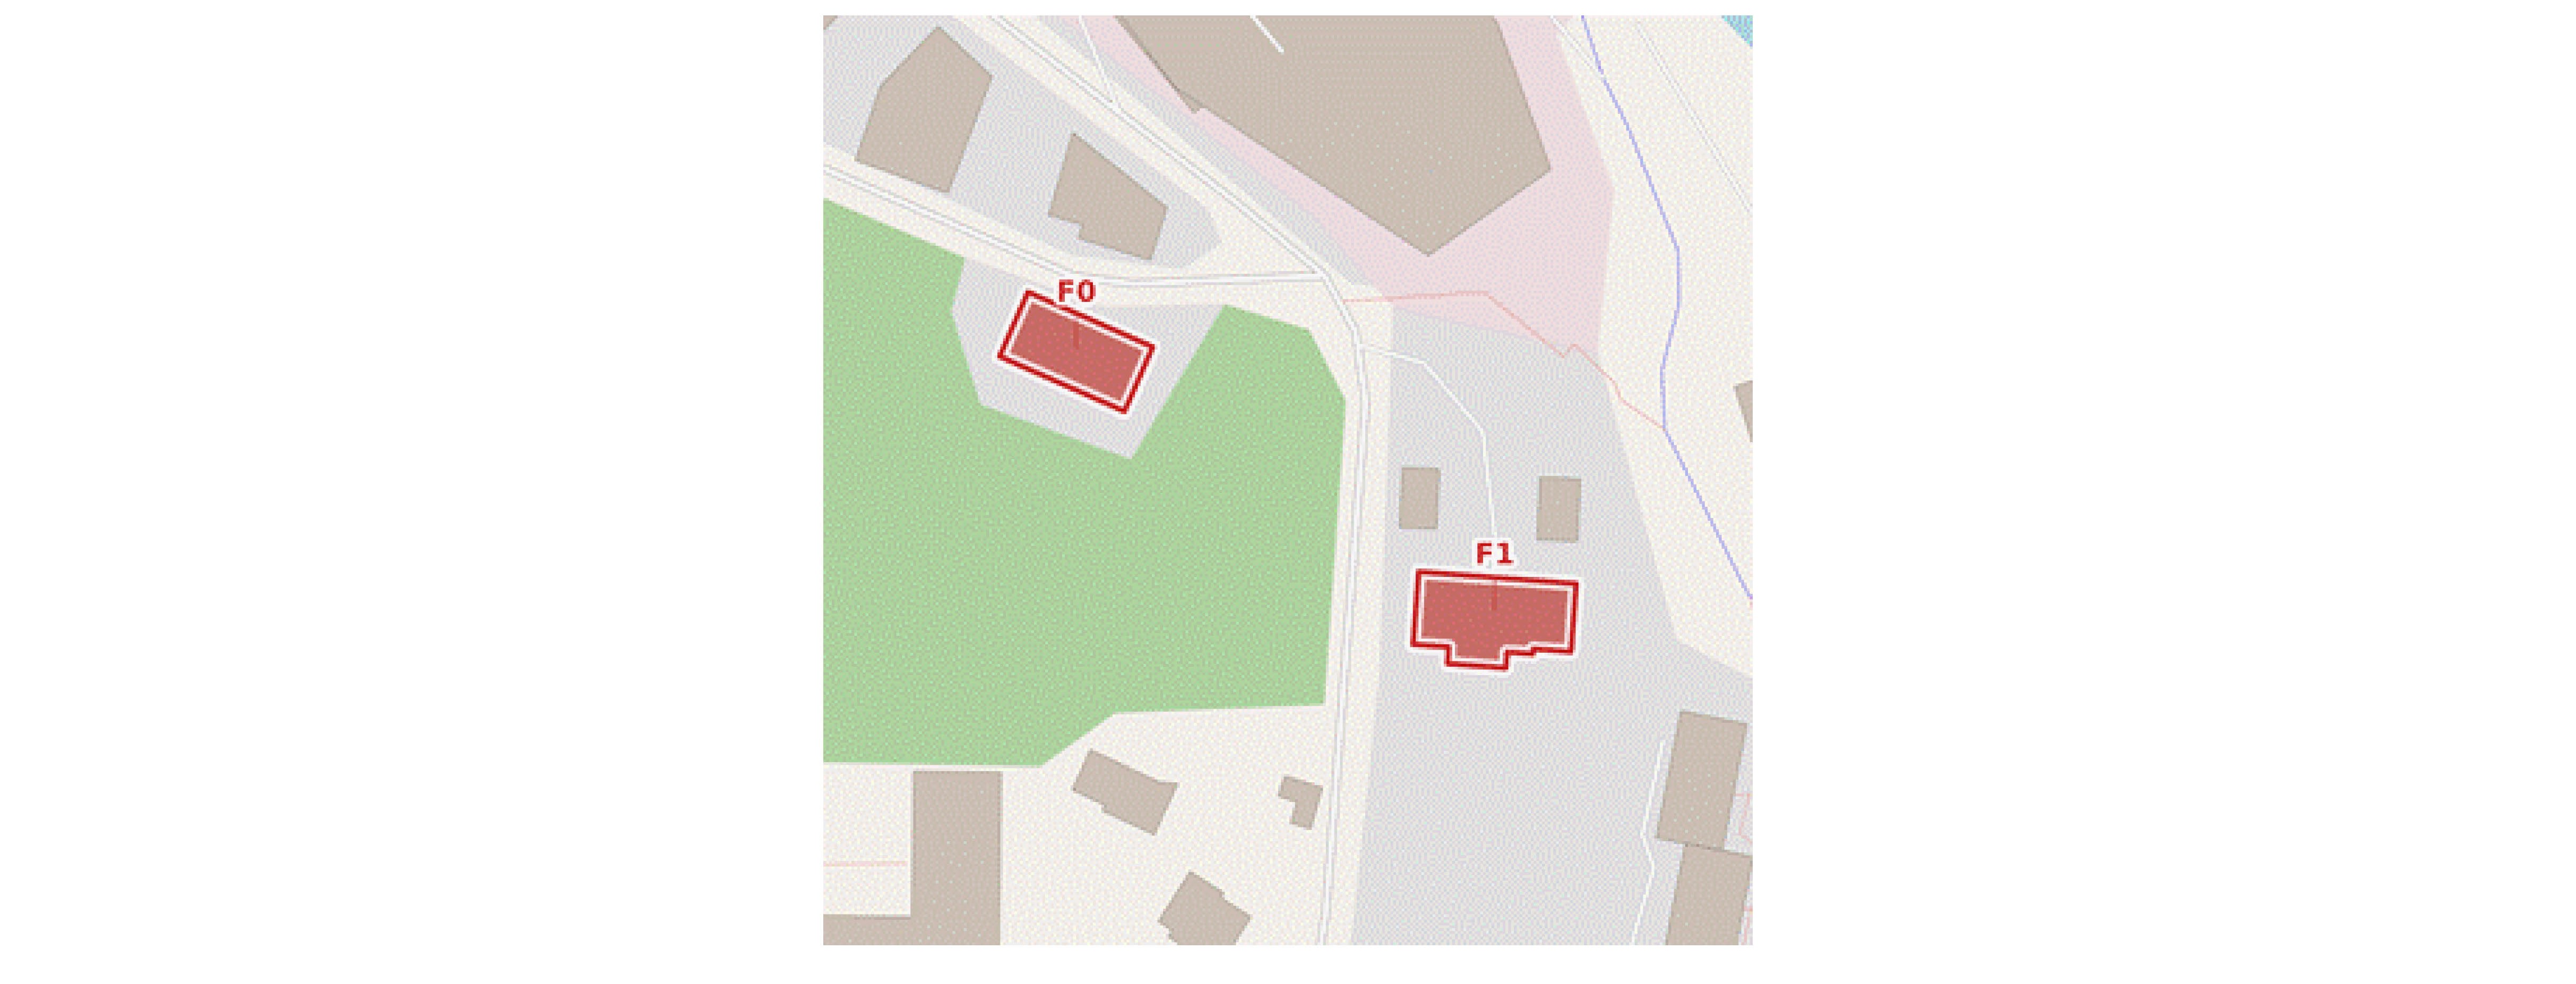
题目要求移动 F0,使它与固定的 F1 部分重叠。
Astra 和 Kimi K3 都把 F0 移到了 F1 的边缘,形成一部分在内、一部分在外的关系,通过约束检查;Sol 的结果仍在原来位置附近,没有与 F1 重叠,未达标。
两款通过的模型给出了不同位置,这说明编辑题可以有多个有效解。
编辑案例二:要求向东,是否真的移对方向?#
题目要求将 F0 向东移动 8—200 米,并与 F1 保持至少 8 米距离。
根据本次方向和距离约束的评测记录:
- Astra: 位移归为东方,距离为 69.93 米,达标。
- Kimi K3: 位移归为东方,距离为 89.84 米,达标。
- Sol: 位移归为北方,距离为 15.71 米,方向不符合要求,未达标。
这里比较的是模型实际生成的几何结果,而不只是它在文字里说要往哪边移动。
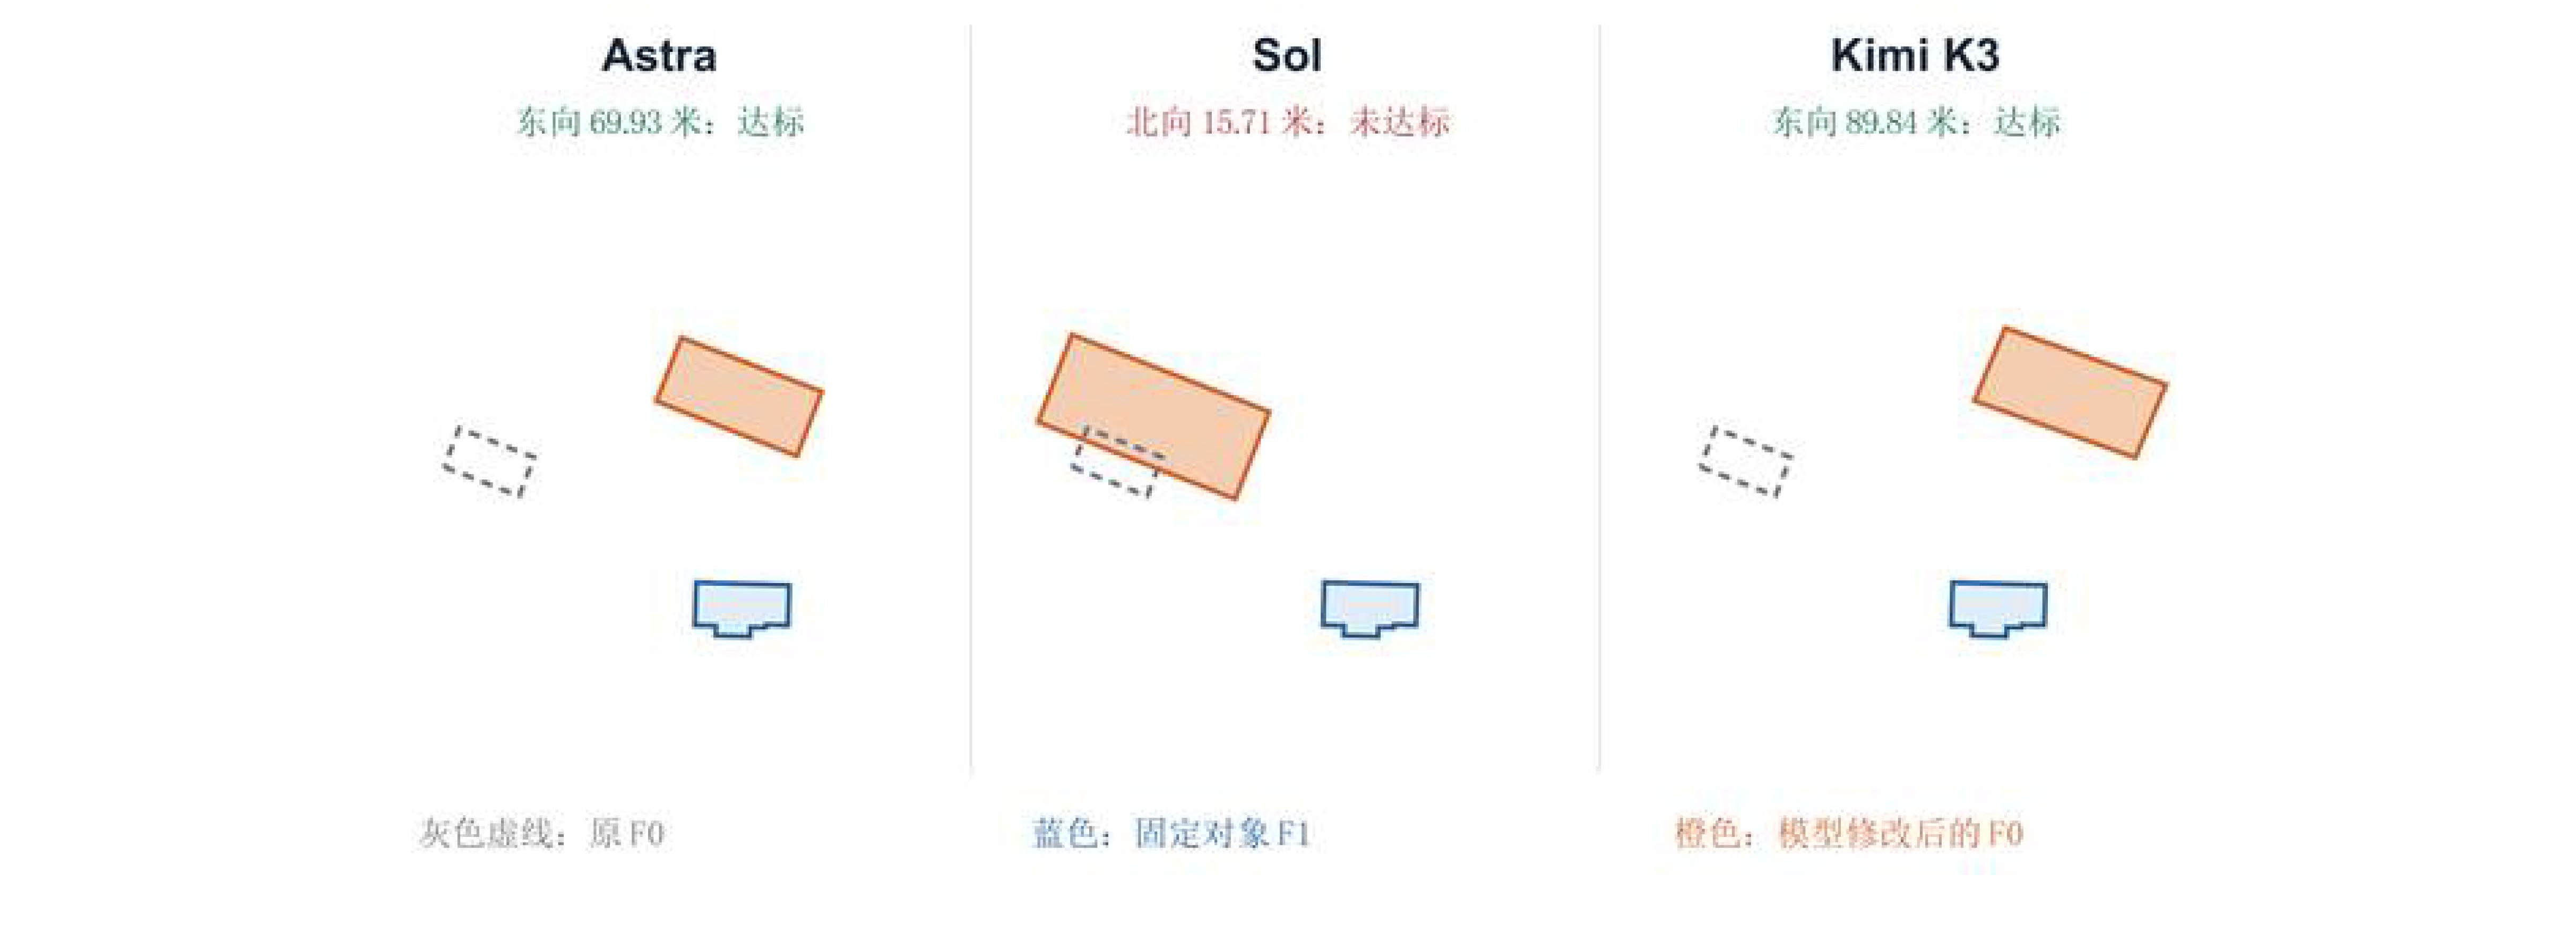
这两个编辑案例中,Astra 与 Kimi K3 均达标,Sol 均未达标;结合前面的问答案例,可以同时看到模型“判断关系”和“按要求修改对象”的表现。
下面两个 Astra 案例则进一步说明,编辑结果如何受到边界精度和距离条件的影响。
编辑案例三:严格拓扑关系与区间距离#
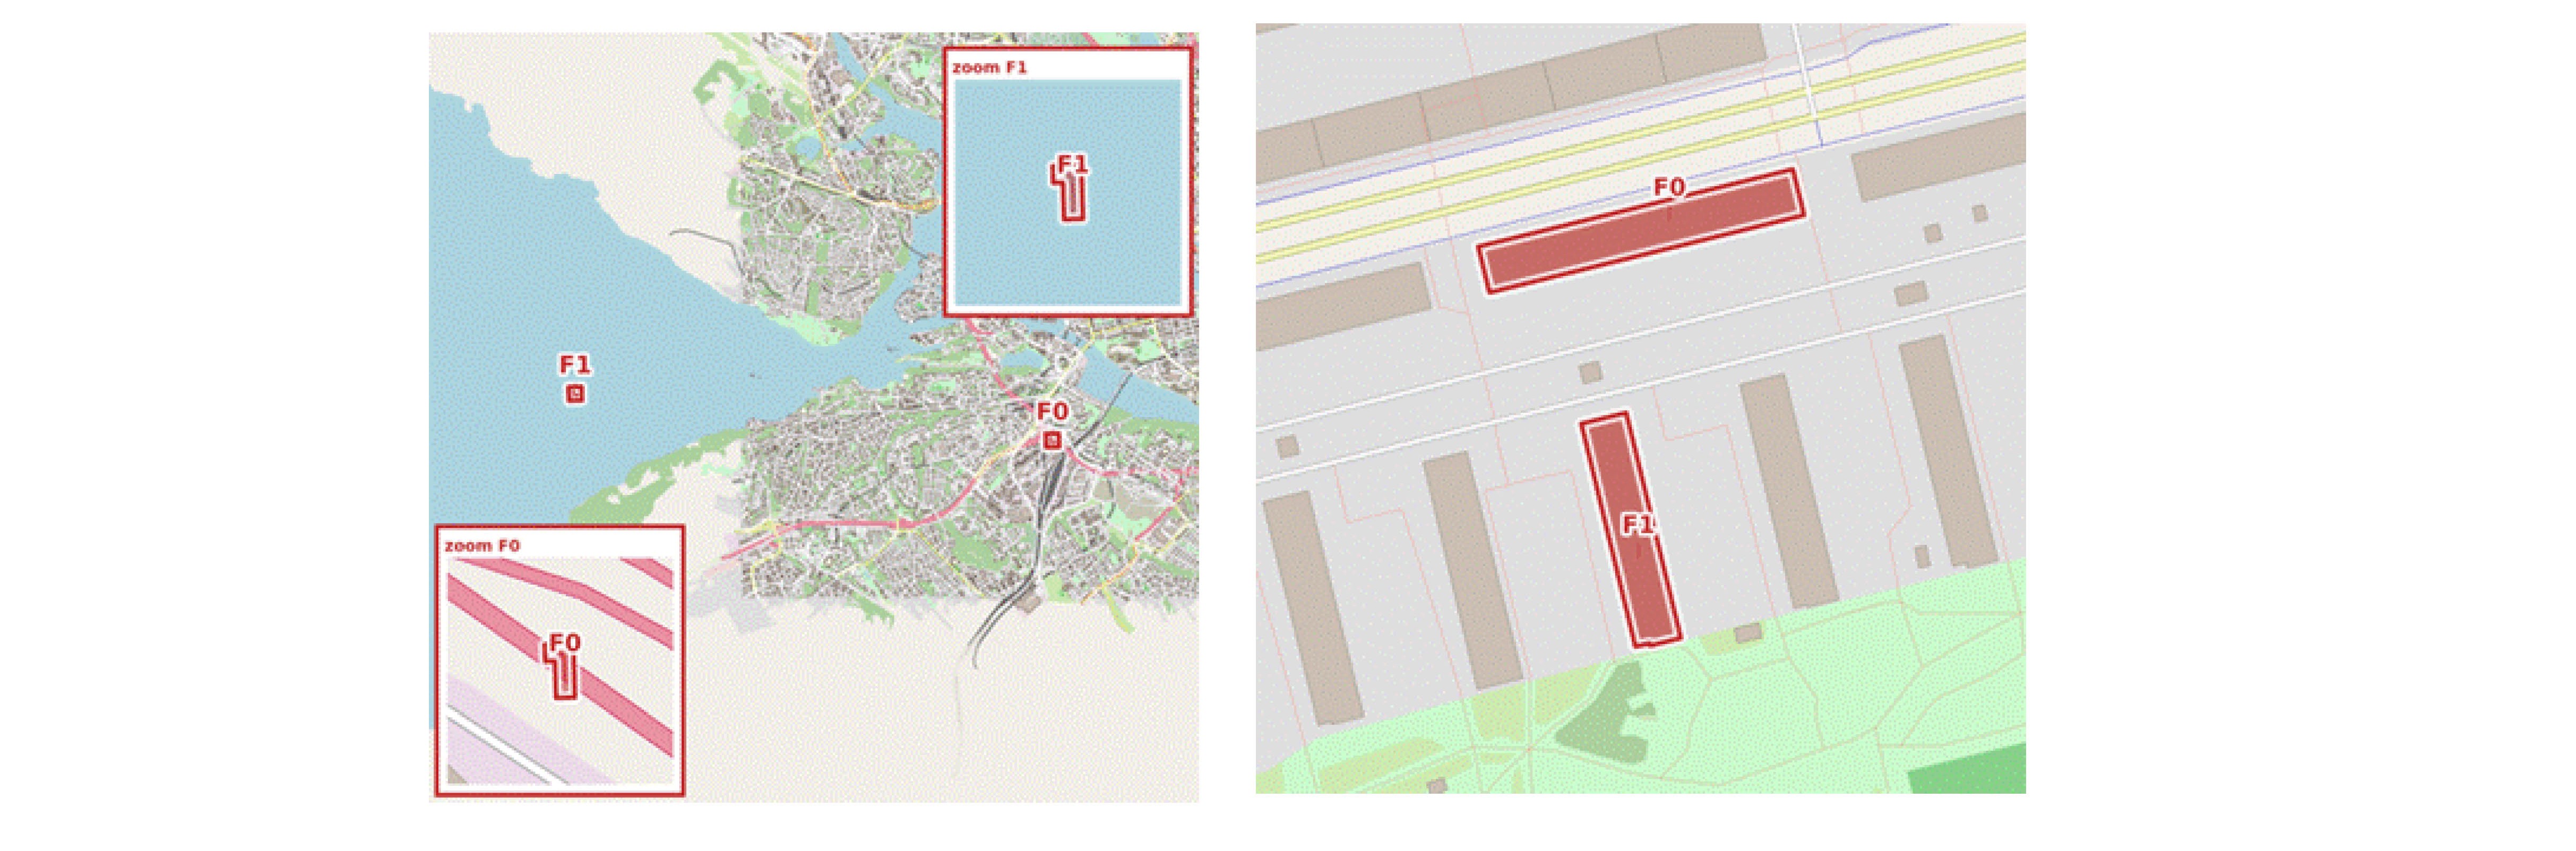
图 5 左:拓扑完全相等(equals)
案例要求将建筑 F0 吸附到 F1,使二者在拓扑上完全相等。
在 GeoJSON 模式下,Astra 直接返回:
{"op":"snap","to":"F1"}
执行后通过 equals 检查。
换成地图图像后,模型生成的多边形在视觉上已经非常接近目标,但像素 Hausdorff 距离为 6.54,超过 4 像素容差;恢复到真实坐标后,两者仍未达到拓扑相等。
对这类严格关系而言,即使只存在很小的边界偏移,也会被判定为不满足约束。
编辑评测因此能够把肉眼不容易察觉的几何误差直接暴露出来。
图 5 右:Hausdorff 区间距离约束
这一案例要求 F0 与 F1 的 Hausdorff 距离落入指定区间。
Astra 在地图图像模式下生成的结果与参考几何相差 12.66 像素,但换算后的实际 Hausdorff 距离约为 37.47 米,仍处于题目要求的范围内,因此被判定为正确。
对区间距离这类任务而言,模型输出不必与参考几何完全重合,只要最终满足给定空间约束,就被视为有效解。
总结:这次实测看到的 GPT-6#
这轮结果让 GPT-6 Astra 的空间能力边界变得更加清晰。
它在结构化 GeoJSON 输入下已经能够较稳定地完成关系判断和几何编辑;与 GPT-5.6 Sol 相比,提升也不仅体现在问答准确率上,两类编辑任务同样出现了较明显的增长。
加入 Kimi K3 后,Astra 的坐标任务准确率仍然领先;在当前共同图像样本中,Kimi K3 的编辑准确率则高于 Sol,与 Astra 更为接近。
但总体分数提高并不意味着所有空间关系都已经被同等程度地解决。
进一步按关系类型拆分后,GeoJSON 问答中的拓扑、方向和度量三组均达到 100%,而 GeoJSON 编辑中的方向关系只有 40.0%。同样,地图图像问答中的度量关系仅答对 8/40。
换句话说,模型能够识别方向变化,并不意味着它一定能求出满足方向约束的平移量或旋转角度;能够看清一个对象,也不意味着它能从没有比例尺的图像中恢复精确的米制尺度。
需要强调的是,本次测试采用斯德哥尔摩的部分样本:每类空间关系 5 道题,每条赛道 140 道,仅反映当前样本与评测协议下的表现。
近期我们将发布的完整 Benchmark 包括扩展任务和样本,在统一协议下比较不同系列模型,敬请关注。